ドキュメント抽出
スキャンされた書籍、コピーされたアーカイブ、縦書きのページなど、画像化されたドキュメントがあります。抽出機能はこれらを読み取り、検索や編集が可能なテキストと構造を返します。
縦書きの日本語や中国語は横書きに変換され、複数段組みのページもバラバラのブロックではなく、読み取り順序に従って出力されます。
利用シーン
フォーマット変換を行うかどうかの境界線は、テキストが画像内にロックされているかどうかです。スキャンデータ、写真、古い縦書きの書籍などは、まず文字を認識する必要があるため、この機能が適しています。すでにデジタル化されており、テキストを選択できるようなクリーンなドキュメントで、拡張子のみが異なる場合は、より高速なフォーマット変換をご利用ください。どちらも1ページあたり4クレジットですが、カウント方法が異なります。ドキュメント抽出は元のファイルのページ数をカウントし、フォーマット変換は変換後のファイル全体の文字数をカウントします(1,600文字ごとに1ページとし、端数は切り捨て、最低1ページ分を課金)。同じPDFでも、1ページあたりの平均文字数が1,600文字未満の複数ページファイルは変換コストが低くなりますが、1ページあたりの平均が1,600文字を超える場合や、1ページのみの場合は、変換しても安くなりません。
抽出のみで翻訳は行われません。入力された言語がそのまま出力されます。翻訳が必要な場合は、ファイル翻訳をご利用ください。
対応フォーマットと出力形式
PDF、画像(PNG / JPG / WEBP / TIFFなど)、DOCX、EPUB、Markdownに対応しており、Word、PDF、TXT、Markdownで出力可能です。料金はページ単位で、1ページあたり4クレジットです。画像1枚は1ページとしてカウントされます。
バックグラウンドジョブとして実行されるため、ページを閉じて後から「履歴」で結果を確認できます。完了したジョブはオンラインでプレビュー可能です。
抽出精度が高くなる条件
- 鮮明な印刷物で、まっすぐにスキャンされている場合、最も高い認識率が得られます。
- 縦書きの日本語、見開きページ、その他の特殊な読み取り順序は自動的に修正されるため、手動でページを分割する必要はありません。
- 画像が不鮮明な場合や手書き文字が多い場合は、エクスポート前に原本と照らし合わせるのが安全です。
4つの出力形式の選び方
| 出力形式 | 推奨される用途 |
|---|---|
| Word | 継続して編集やフォーマット調整を行う場合、または他者に渡す場合。 |
| Markdown | ノートアプリやナレッジベース、または独自の執筆環境に取り込む場合。 |
| TXT | 他のツールへの入力や、検索用のプレーンテキストが必要な場合。 |
| 閲覧やアーカイブのみを目的とする場合。 |
処理結果の例
1913年米国国勢調査抄録の2ページのスキャン画像(2段組みテキストと統計表、テキストレイヤーなし)が、Document Extractionによって編集可能なテキストに変換されます。本文と太字のランイン見出しが正確に認識され、2レベルのヘッダーを持つ表を含む両方の表が、元のセルと一致する数値を持つ30行のデータ行を備えた実際の表として復元されます(脚注を含む)。
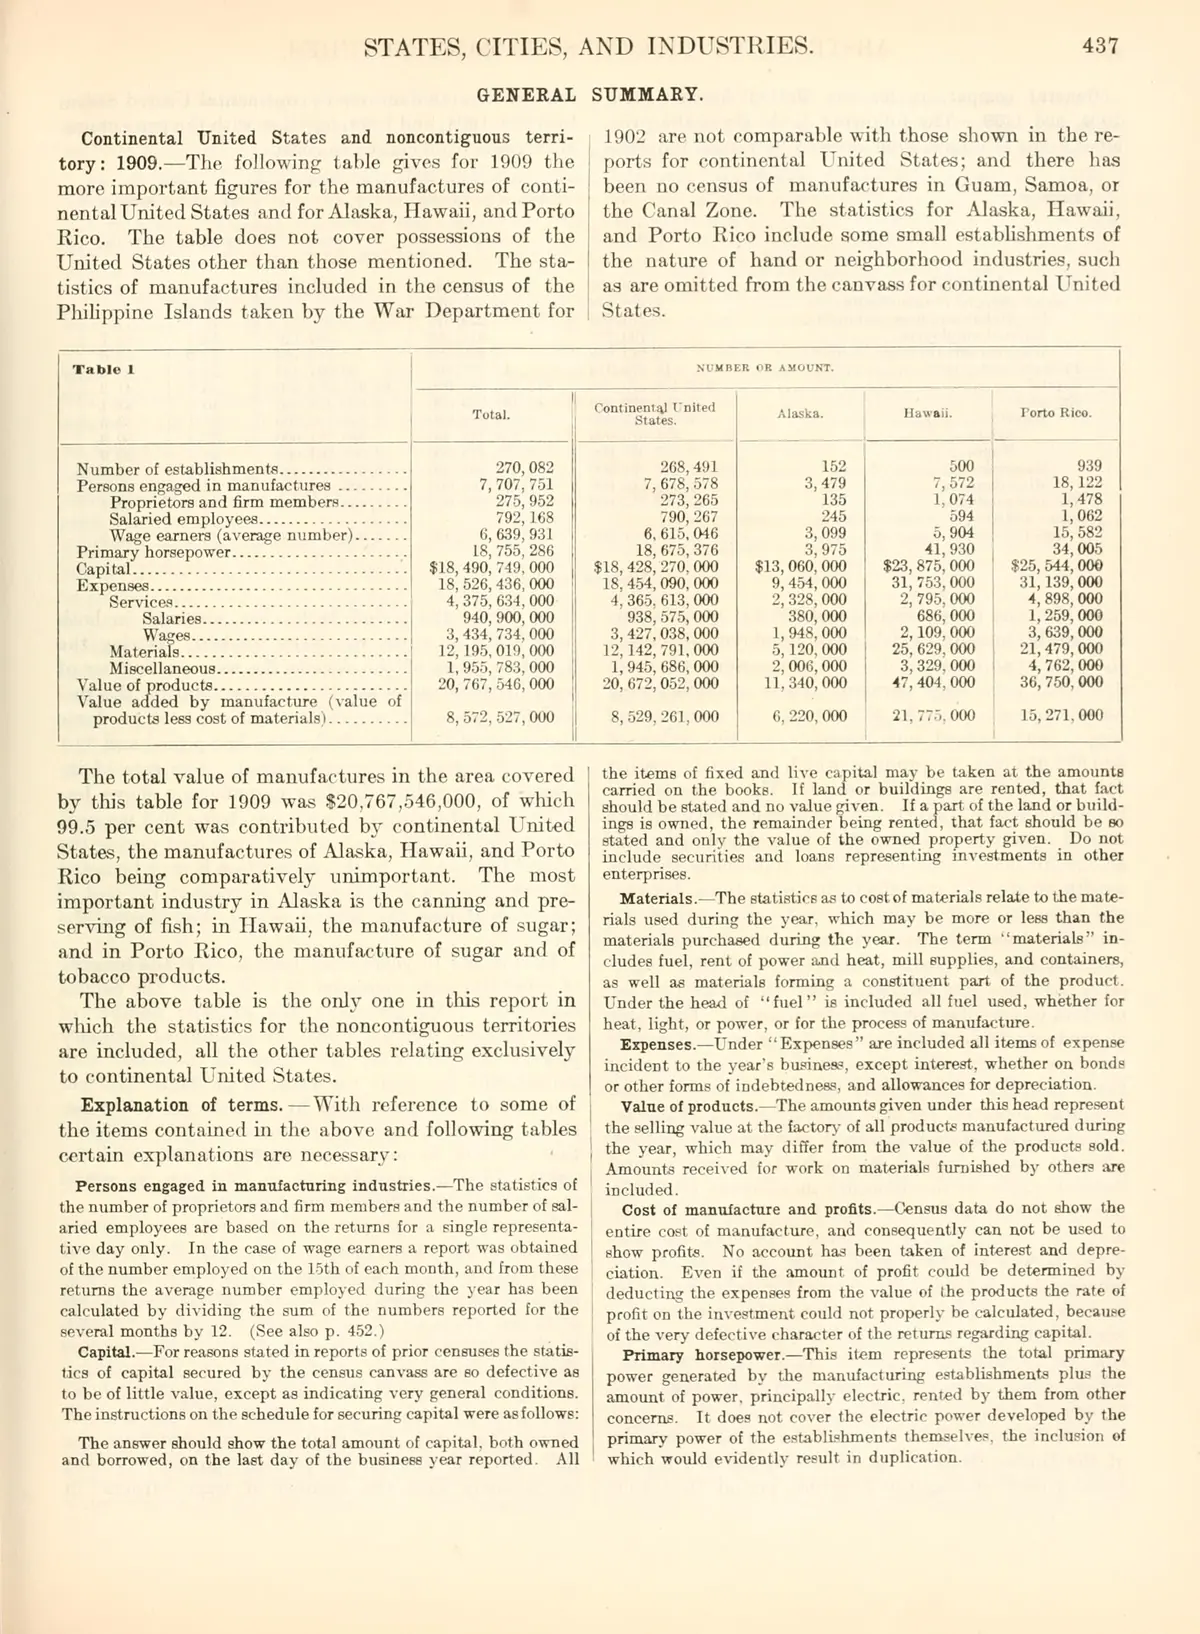
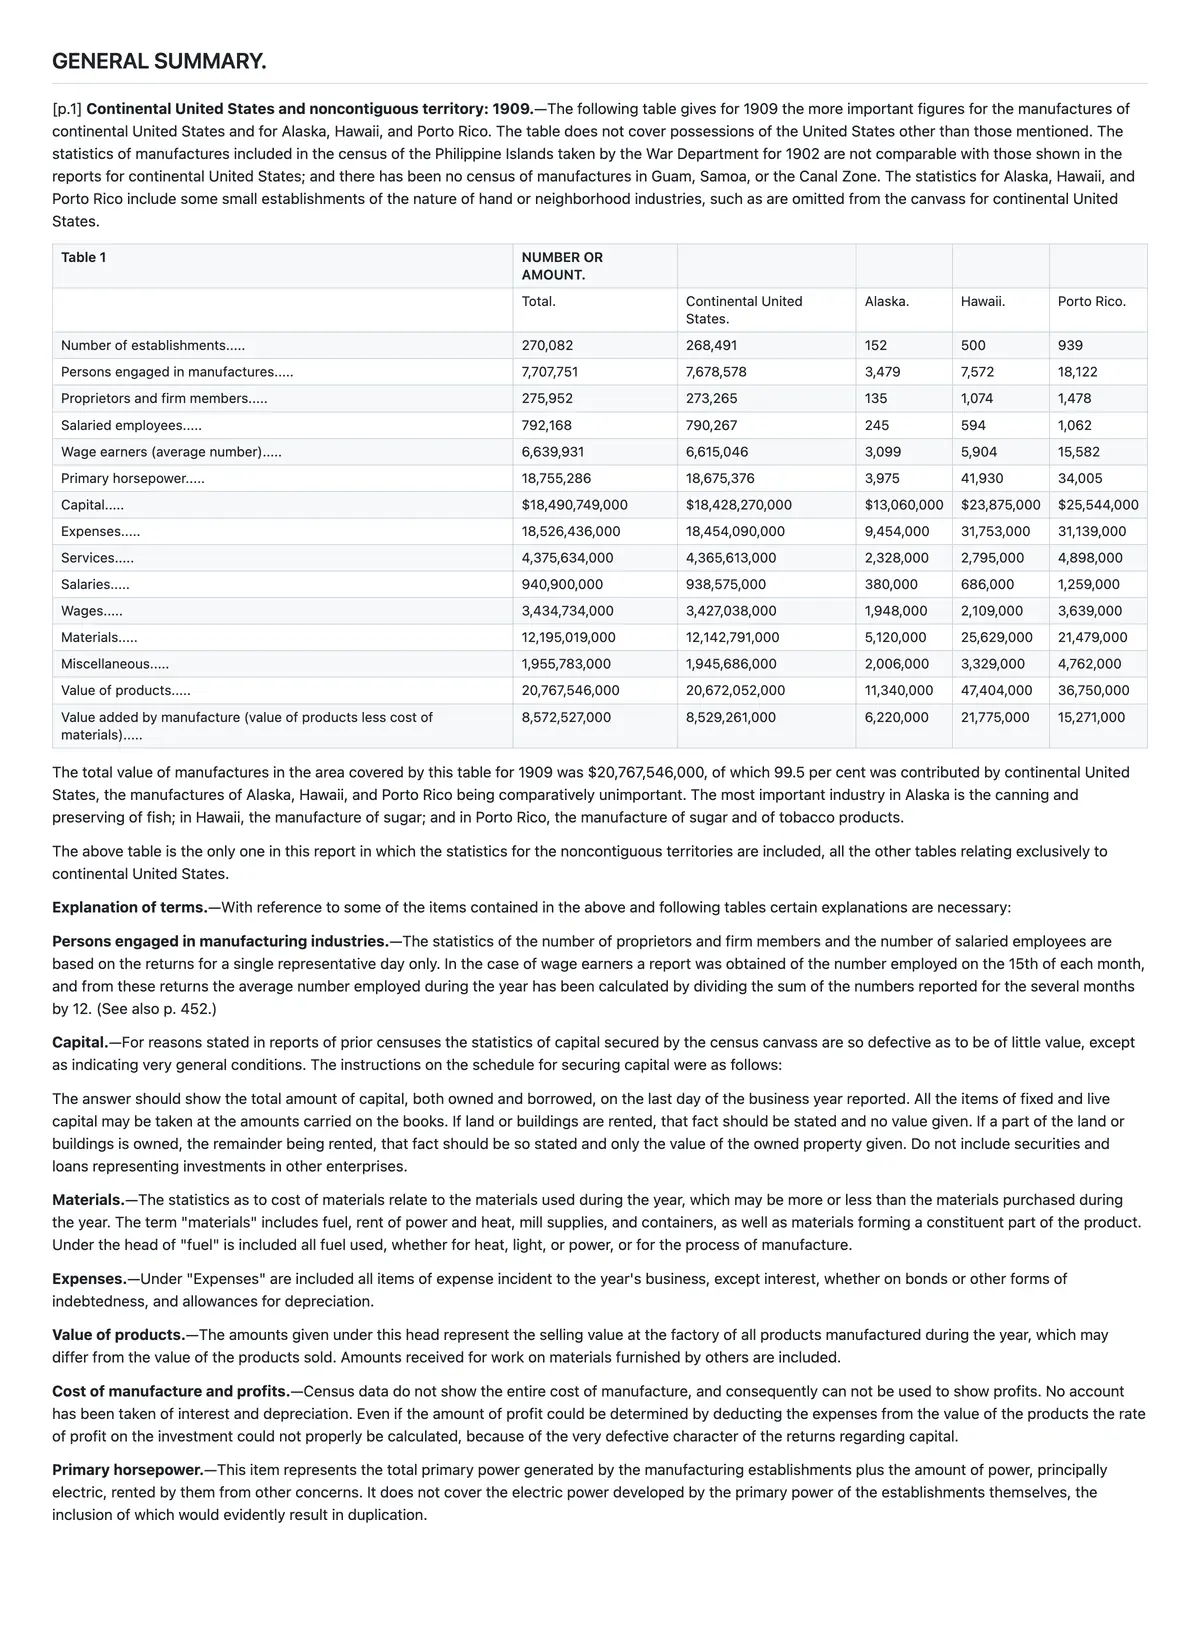
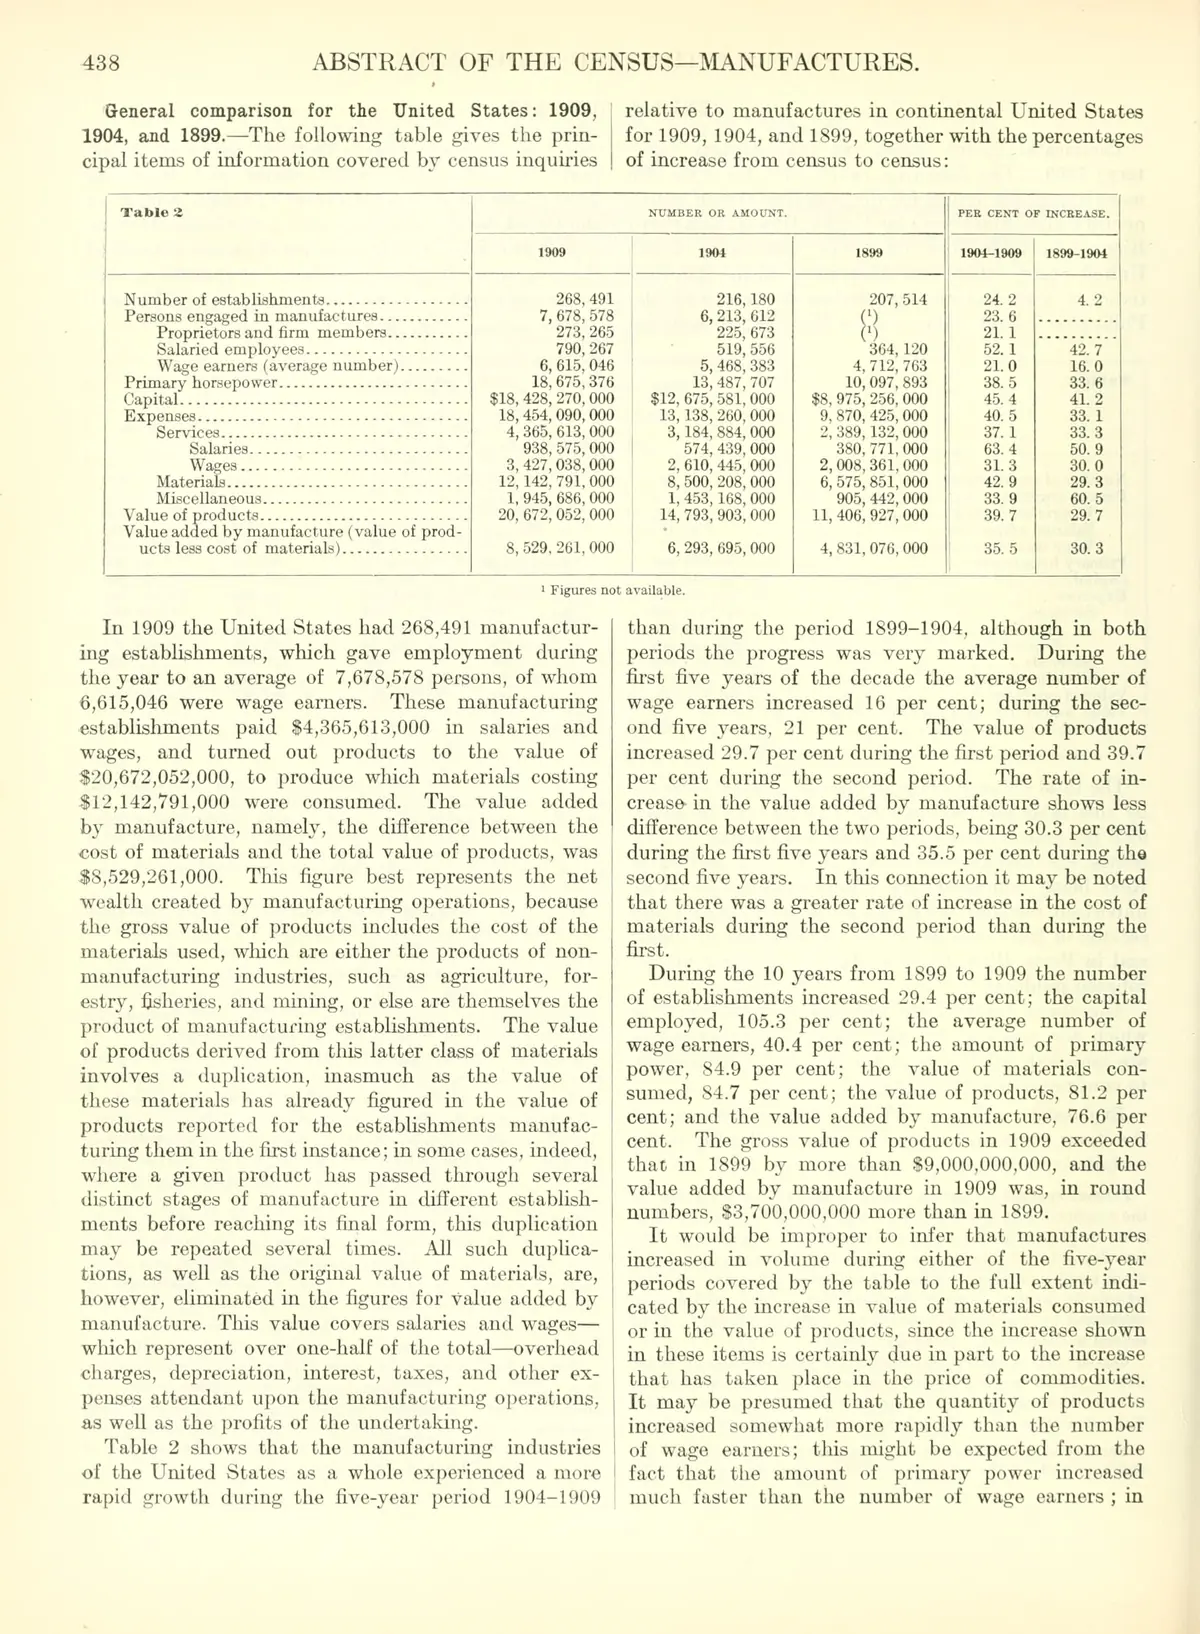
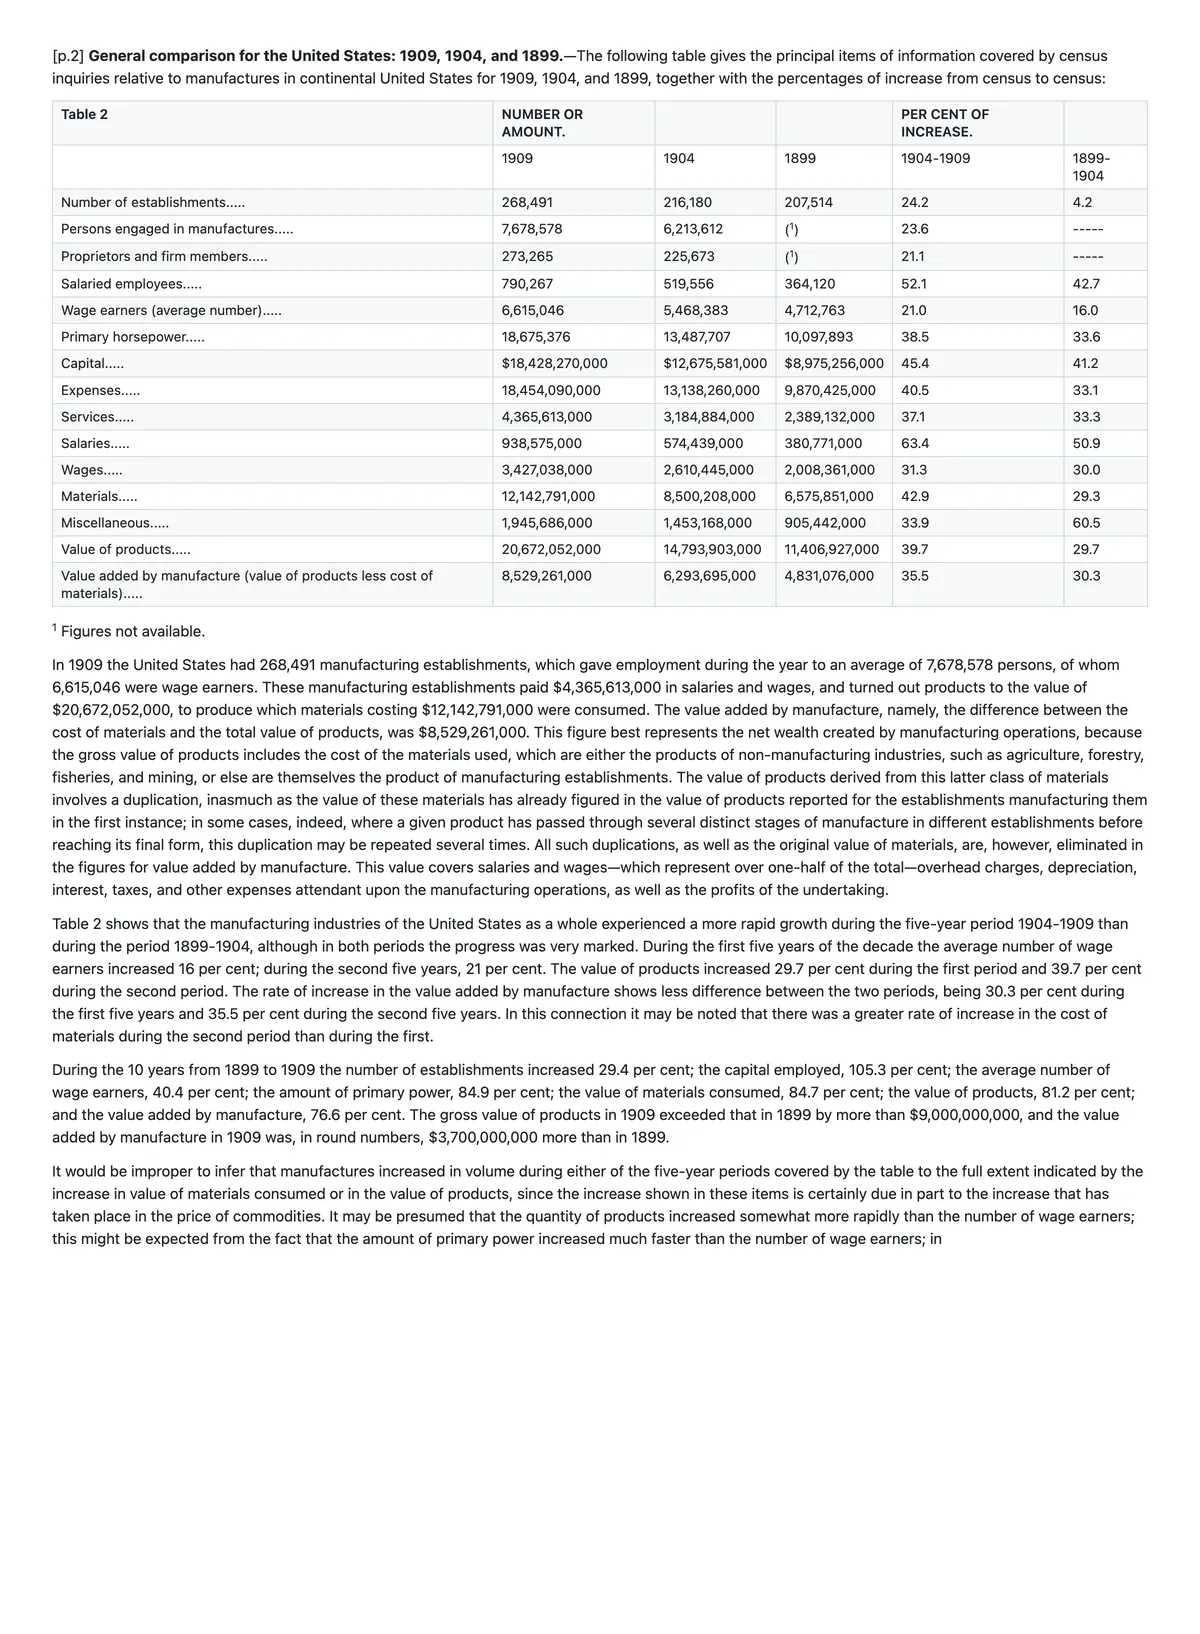
実際の生成出力。表示前に5箇所を手動で修正済み。 · 出典:1910年米国第13回国勢調査:国勢調査抄録, 米国国勢調査局, 1913 (米国政府の著作物:米国国勢調査局が編集し、1913年に政府印刷局から出版されたため、合衆国法典第17編第105条に基づき著作権の対象外です。Internet Archiveのアイテム(カリフォルニア大学図書館がスキャン)は、possible-copyright-status = NOT_IN_COPYRIGHTとマークされています。)
よくある質問
縦書きの日本語は正しい順序に戻りますか?
はい。縦書きの日本語、見開きページ、その他の特殊な読み取り順序は自動的に修正され、横書きに変換されます。手動でページを分割する必要はありません。複数段組みのページもバラバラのブロックではなく、読み取り順序に従って出力されます。
料金体系はどのようになっていますか?
ページ単位です。1ページあたり4クレジットで、画像1枚は1ページとしてカウントされます。
抽出したテキストを翻訳できますか?
このページではできません。翻訳が必要な場合は、抽出したWordまたはMarkdownファイルをファイル翻訳にアップロードして実行してください。
関連コンテンツ
简体中文 · English · Français · Deutsch · Русский · 한국어
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.