Extraction de documents
Certains documents sont des images de texte : livres numérisés, archives photocopiées, pages à composition verticale. L'extraction lit ces documents et renvoie un texte et une structure que vous pouvez rechercher et modifier.
La composition verticale japonaise et chinoise est convertie en sortie horizontale, et les pages à plusieurs colonnes sont restituées dans l'ordre de lecture plutôt que sous forme de bloc désordonné.
Quand l'utiliser
La limite pour la conversion de format dépend du fait que le texte soit encore verrouillé dans une image. Les scans, photos et vieux livres à composition verticale relèvent de cette catégorie, car les caractères doivent d'abord être reconnus. Les documents déjà propres et numériques, où le texte peut être sélectionné et dont seule l'extension est incorrecte, passent par la conversion de format, qui est plus rapide. Les deux facturent 4 crédits par page, mais comptent les pages différemment : l'extraction de documents compte les pages de l'original, tandis que la conversion de format compte le texte de l'ensemble du fichier converti, à raison d'une page pour chaque tranche complète de 1 600 caractères, le reste étant abandonné et au moins une page étant facturée. Pour un même PDF, un fichier multipage comptant en moyenne moins de 1 600 caractères par page coûte moins cher à convertir ; un fichier comptant en moyenne plus de 1 600 caractères par page, ou ne comportant qu'une seule page, ne coûte pas moins cher à convertir.
Extraction uniquement, sans traduction : la langue d'entrée est la langue de sortie. Utilisez la traduction de fichiers lorsque vous avez besoin d'une traduction.
Formats acceptés et produits
Le service accepte les formats PDF, images (PNG / JPG / WEBP / TIFF et similaires), DOCX, EPUB et Markdown, et produit des fichiers Word, PDF, TXT ou Markdown. La facturation se fait à la page : 4 crédits par page, une image seule comptant pour une page.
Le traitement s'effectue en arrière-plan, vous pouvez donc fermer la page et récupérer le résultat plus tard dans l'Historique. Les travaux terminés peuvent être prévisualisés en ligne.
Quand l'extraction est-elle la plus précise
- Une impression propre, scannée bien droite, offre le meilleur taux de reconnaissance.
- Le japonais vertical, les doubles pages et autres ordres de lecture inhabituels sont corrigés automatiquement : inutile de diviser les pages vous-même.
- Si l'image est floue ou largement manuscrite, il est préférable de vérifier le résultat par rapport à l'original avant l'exportation.
Choisir parmi les quatre formats d'exportation
| Exportation | À choisir si |
|---|---|
| Word | Vous souhaitez continuer à modifier le document, le mettre en forme ou le transmettre à quelqu'un d'autre. |
| Markdown | Le document est destiné à une application de notes, une base de connaissances ou votre propre environnement de rédaction. |
| TXT | Vous avez besoin de texte brut pour alimenter un autre outil ou pour effectuer des recherches. |
| Vous souhaitez simplement le lire et l'archiver. |
Résultats concrets
Deux pages numérisées de l'Abstract du recensement américain de 1913 (texte à deux colonnes plus tableaux statistiques, sans couche de texte) sont transformées en texte modifiable par l'extraction de documents : le corps du texte et les titres en gras sont reconnus avec précision, et les deux tableaux, dont l'un avec un en-tête à deux niveaux, reviennent sous forme de vrais tableaux avec 30 lignes de données dont les chiffres correspondent à l'original cellule par cellule, notes de bas de page incluses.
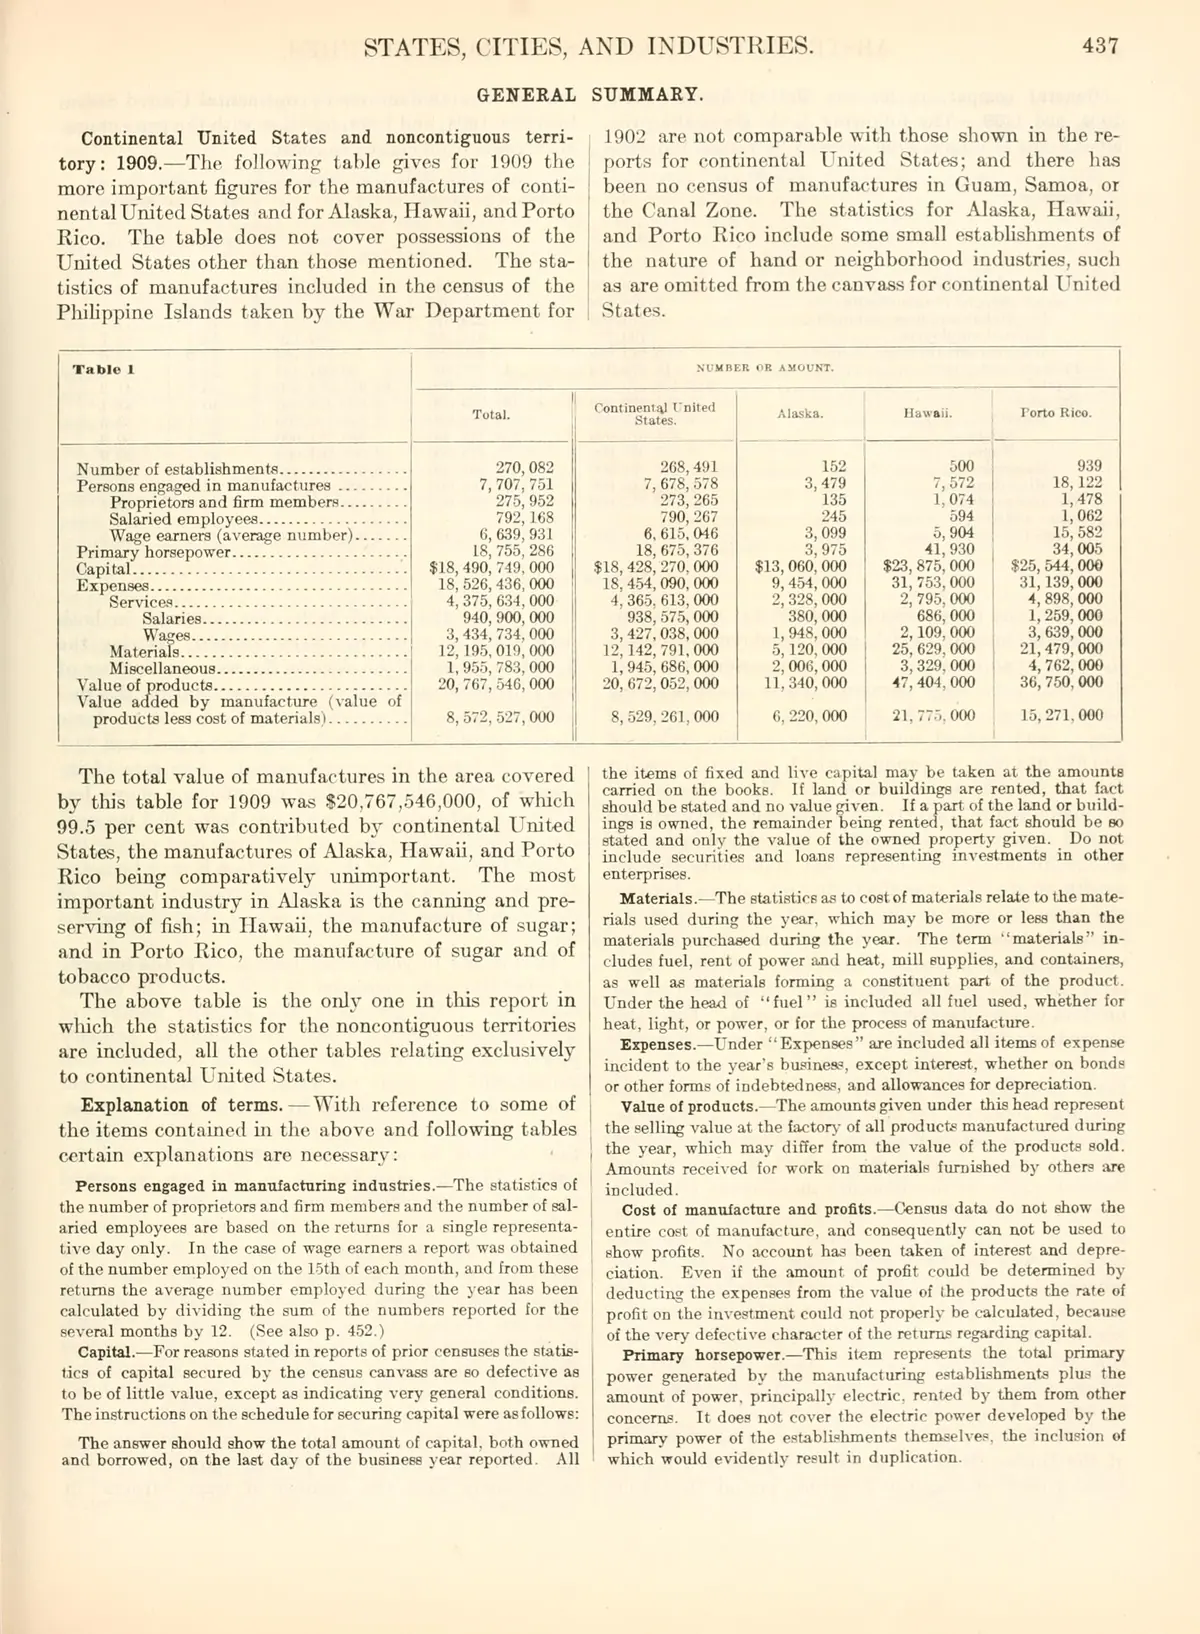
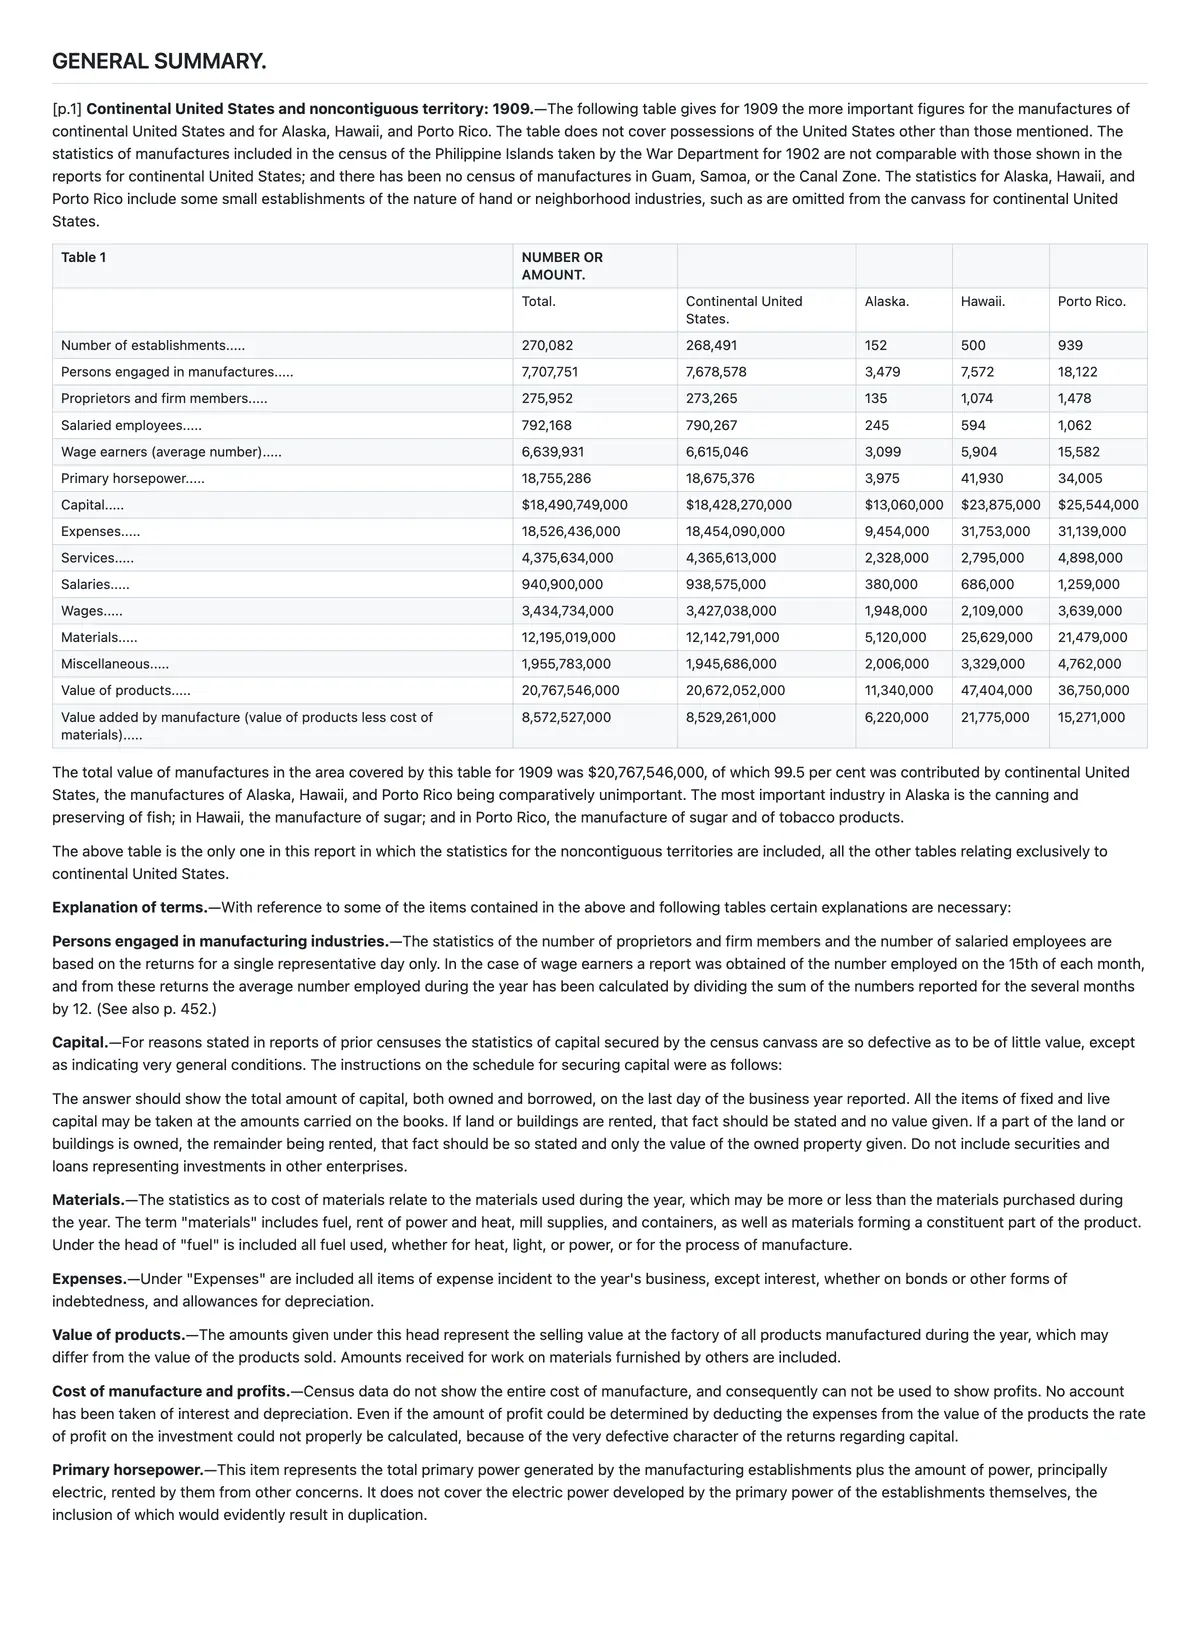
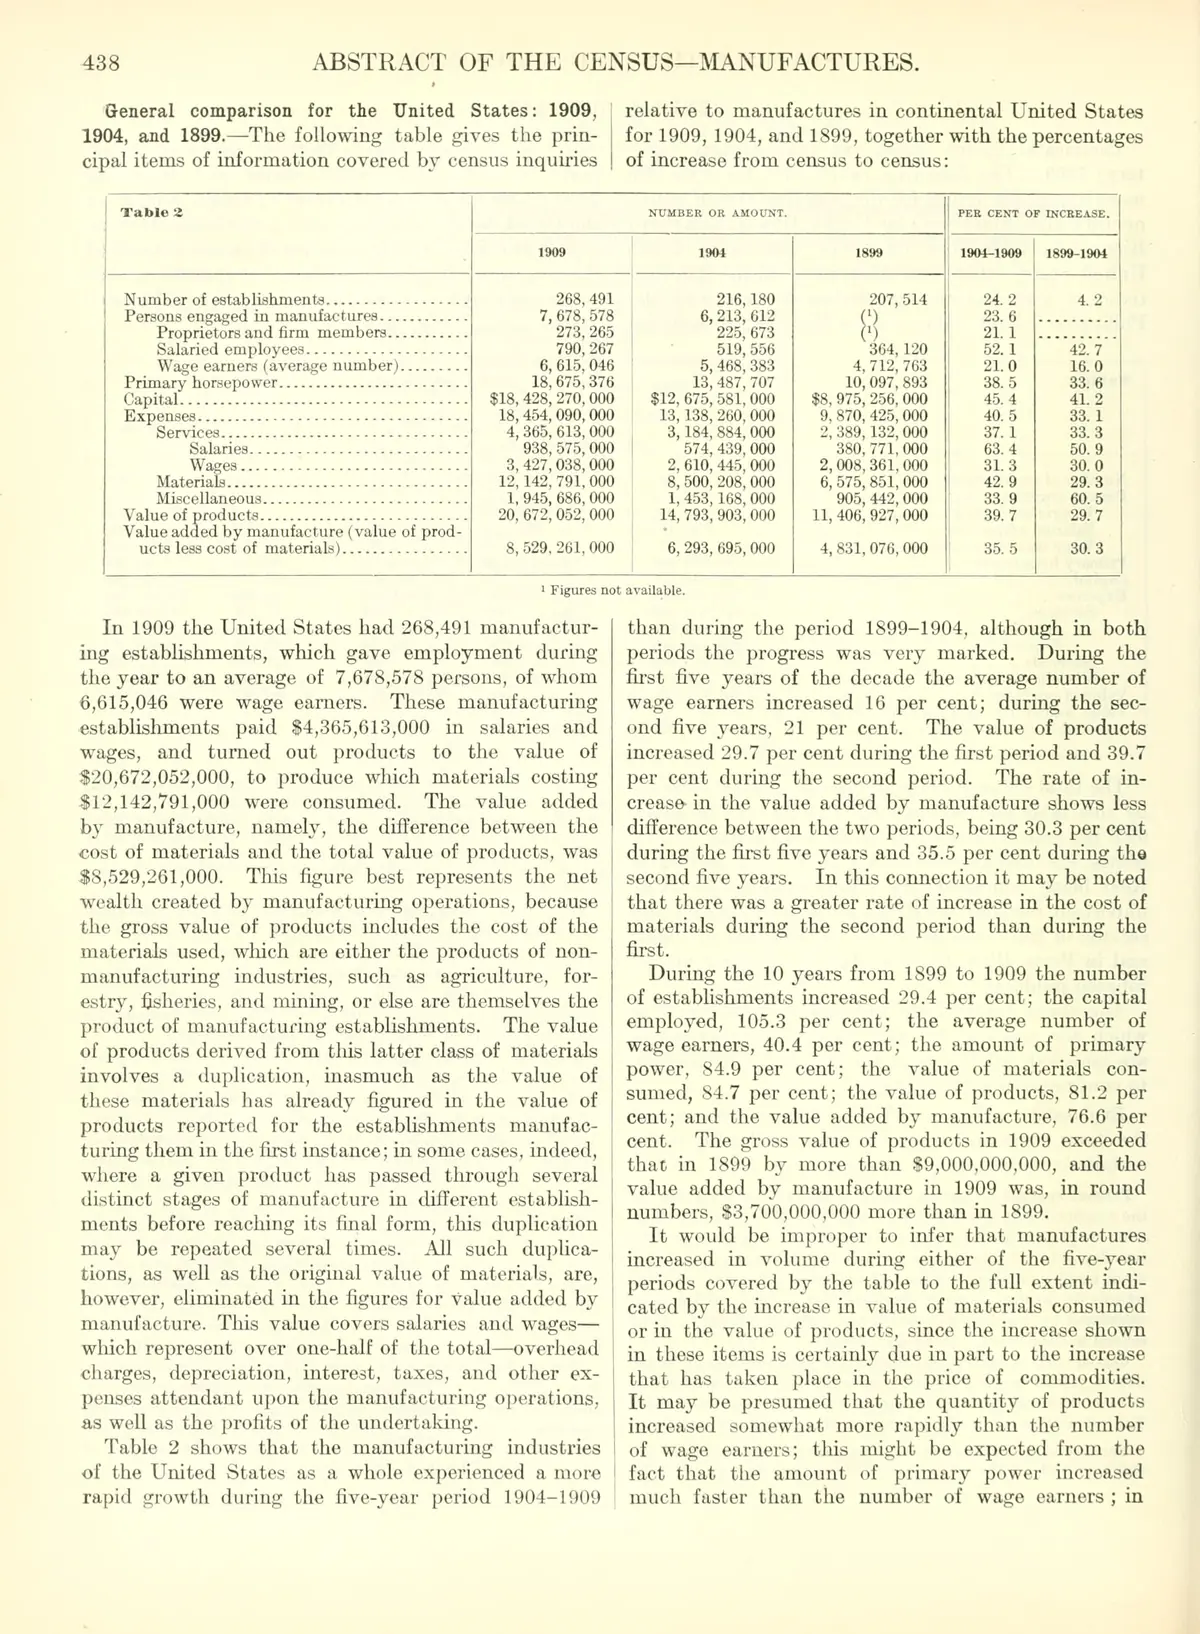
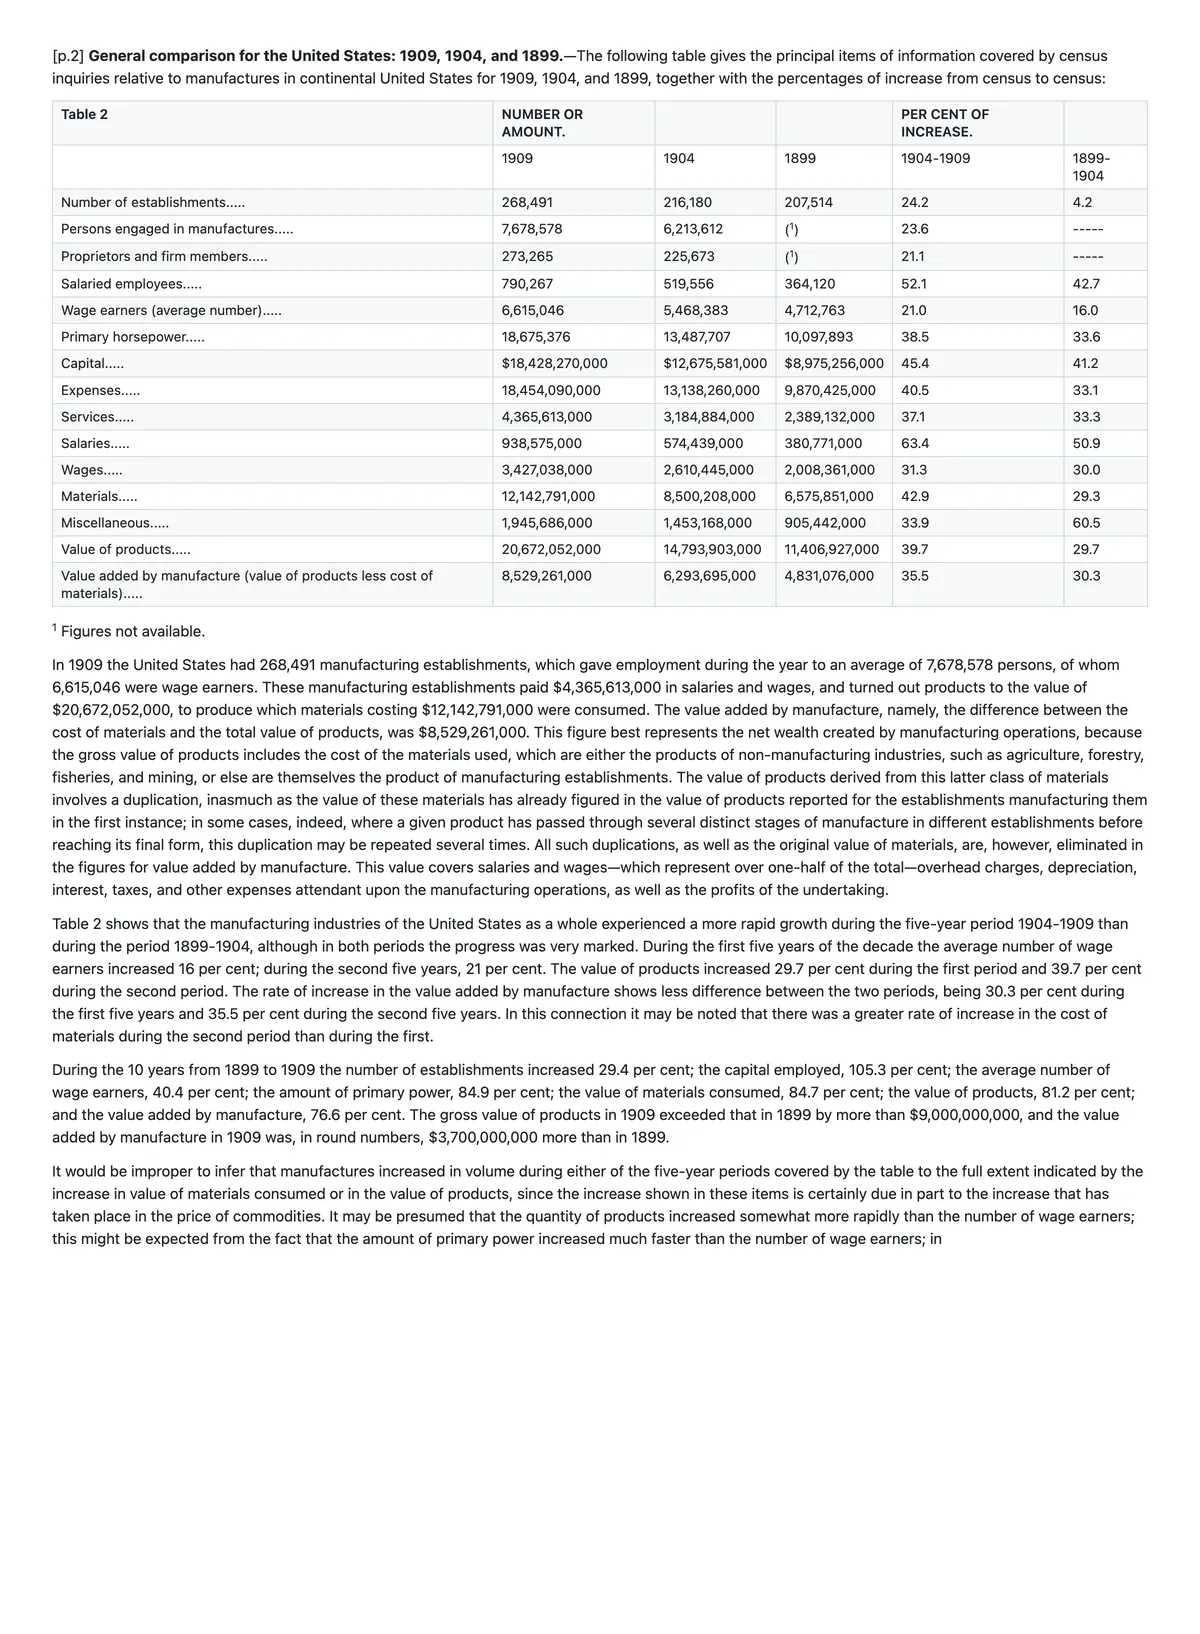
Résultat de production réel ; 5 points corrigés à la main avant affichage · Source : Treizième recensement des États-Unis réalisé en 1910 : Abstract du recensement, Bureau du recensement des États-Unis, 1913 (Travail du gouvernement américain : compilé par le Bureau du recensement des États-Unis et publié par le Government Printing Office en 1913, il n'est donc pas soumis au droit d'auteur en vertu de 17 U.S.C. §105 ; l'élément Internet Archive (numérisé par les bibliothèques de l'Université de Californie) est marqué possible-copyright-status = NOT_IN_COPYRIGHT.)
Questions fréquentes
Le japonais vertical est-il remis dans le bon ordre ?
Oui. Le japonais vertical, les doubles pages et autres ordres de lecture inhabituels sont corrigés automatiquement et convertis en sortie horizontale, sans qu'il soit nécessaire de diviser les pages vous-même. Les pages à plusieurs colonnes sont restituées dans l'ordre de lecture plutôt que sous forme de bloc désordonné.
Comment est-ce facturé ?
À la page : 4 crédits par page, une image seule comptant pour une page.
Peut-il traduire ce qu'il extrait ?
Pas sur cette page. Lorsque vous avez besoin d'une traduction, importez le fichier Word ou Markdown extrait dans l'outil de traduction de fichiers et lancez le traitement à partir de là.
Contenu associé
- Explorez un exemple avant d'utiliser votre propre document
- OCR et traduction pour les fonds d'archives
简体中文 · English · Deutsch · Русский · 日本語 · 한국어
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.