Извлечение данных из документов
Некоторые документы представляют собой изображения текста: отсканированные книги, ксерокопии архивов, страницы с вертикальной версткой. Функция извлечения считывает их и возвращает текст и структуру, которые можно искать и редактировать.
Вертикальная японская и китайская верстка преобразуется в горизонтальный формат, а многоколоночные страницы возвращаются в порядке чтения, а не как один неразборчивый блок.
Когда использовать
Критерием выбора между преобразованием формата и извлечением является то, заблокирован ли текст внутри изображения. Сканы, фотографии и старые книги с вертикальной версткой относятся к извлечению, так как символы нужно сначала распознать. Документы, которые уже являются чистыми и цифровыми, где текст можно выделить, а проблема лишь в расширении файла, проходят через преобразование формата, что быстрее. Оба варианта стоят 4 кредита за страницу, но они считают страницы по-разному: извлечение документов считает страницы оригинала, в то время как преобразование формата считает текст всего преобразованного файла (одна страница на каждые полные 1600 знаков, остаток отбрасывается, оплата минимум за одну страницу). Для одного и того же PDF многостраничный файл, где в среднем менее 1600 знаков на страницу, стоит дешевле при преобразовании; файл, где в среднем более 1600 знаков на страницу или всего одна страница, стоит при преобразовании не меньше.
Только извлечение, без перевода — какой язык был на входе, такой и будет на выходе. Используйте перевод файлов, если вам нужен перевод.
Что принимается и что получается на выходе
Поддерживаются PDF, изображения (PNG / JPG / WEBP / TIFF и аналогичные), DOCX, EPUB и Markdown. Результат выдается в форматах Word, PDF, TXT или Markdown. Оплата за страницу: 4 кредита за страницу, одно изображение считается за одну страницу.
Задание выполняется в фоновом режиме, поэтому вы можете закрыть страницу и забрать результат позже в разделе «История». Готовые задания можно просмотреть онлайн.
Когда извлечение наиболее точно
- Четкий шрифт, ровное сканирование обеспечивают наивысший процент распознавания.
- Вертикальный японский текст, развороты из двух страниц и другие необычные порядки чтения исправляются автоматически — нет необходимости разделять страницы самостоятельно.
- Если изображение размыто или в основном рукописное, безопаснее проверить результат по оригиналу перед экспортом.
Выбор между четырьмя вариантами экспорта
| Экспорт | Выбирайте, если |
|---|---|
| Word | Вы планируете продолжать редактирование, форматирование или передать файл кому-то еще. |
| Markdown | Файл пойдет в приложение для заметок, базу знаний или вашу систему для работы с текстом. |
| TXT | Вам нужен простой текст для передачи в другой инструмент или для поиска. |
| Вы собираетесь просто прочитать и сохранить его в архив. |
Примеры результатов
Две отсканированные страницы Реферата переписи населения США 1913 года (двухколоночный текст плюс статистические таблицы, без текстового слоя) превращаются в редактируемый текст с помощью функции извлечения документов: основной текст и полужирные заголовки распознаются точно, а обе таблицы, включая одну с двухуровневым заголовком, возвращаются как настоящие таблицы с 30 строками данных, цифры в которых соответствуют оригиналу ячейка в ячейку, включая сноски.
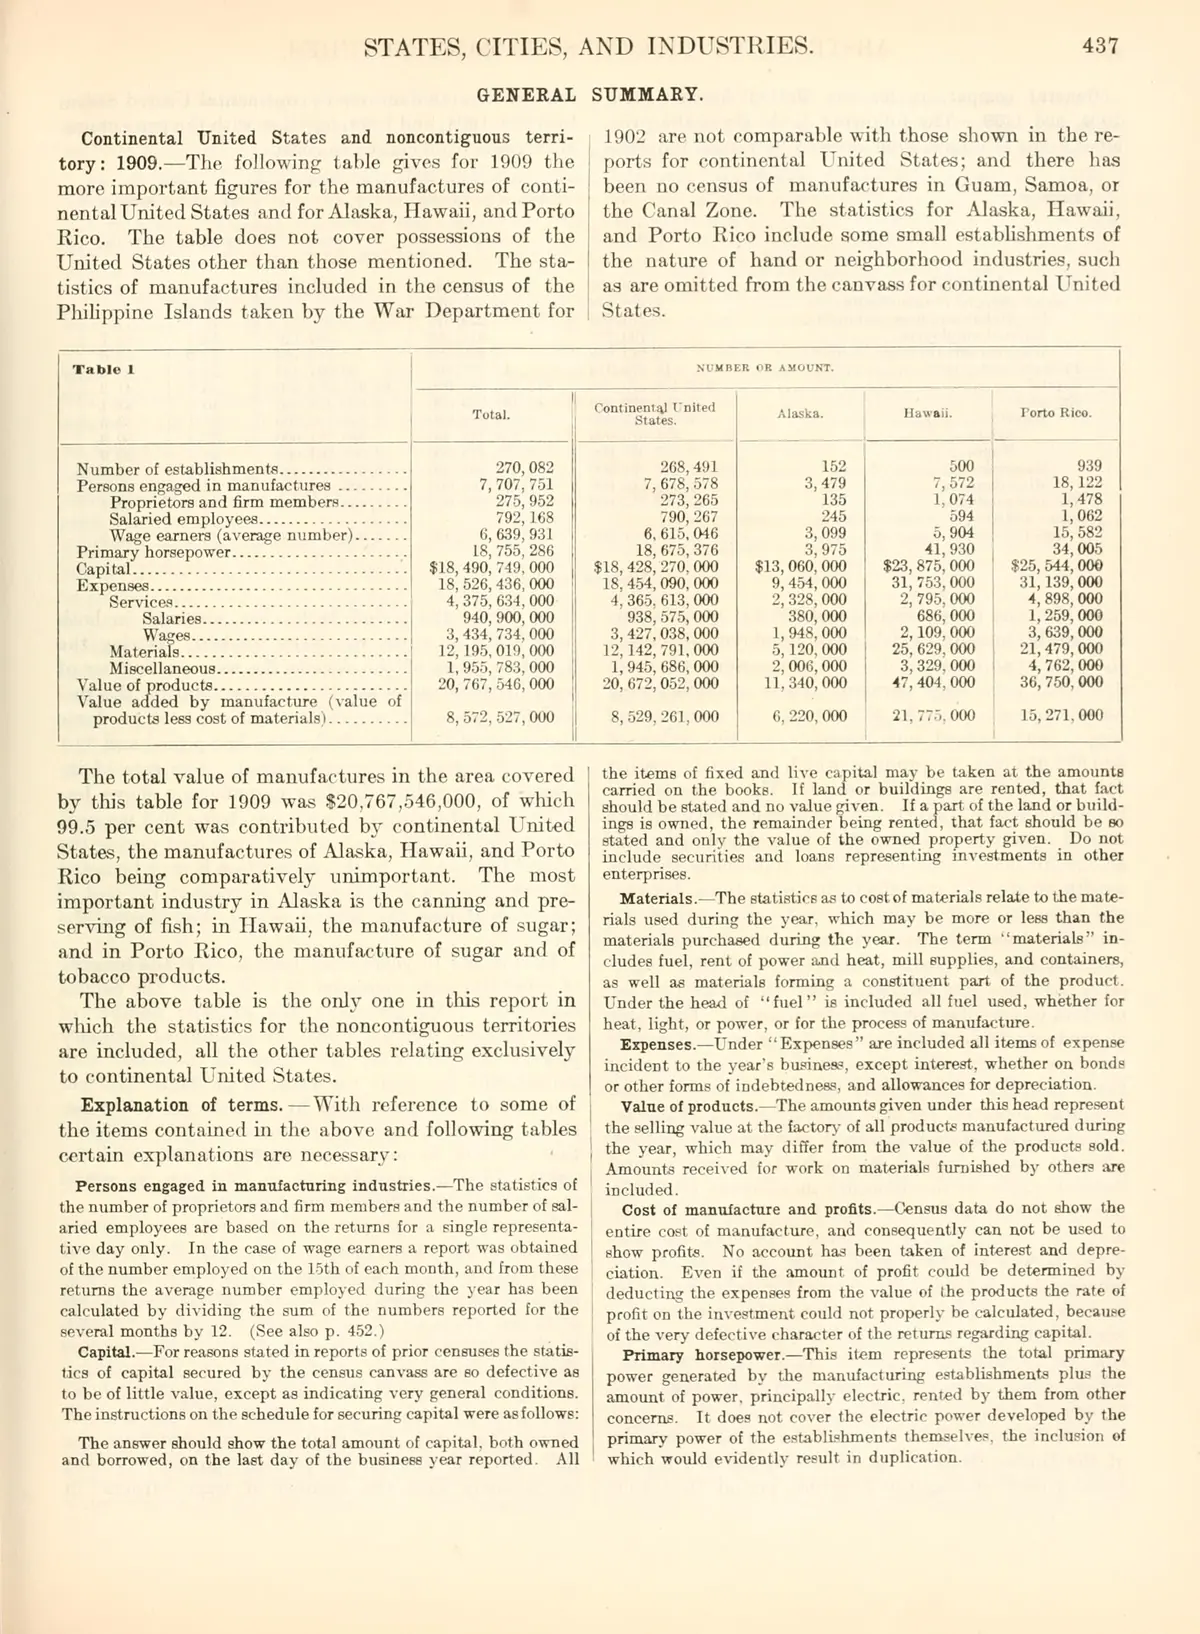
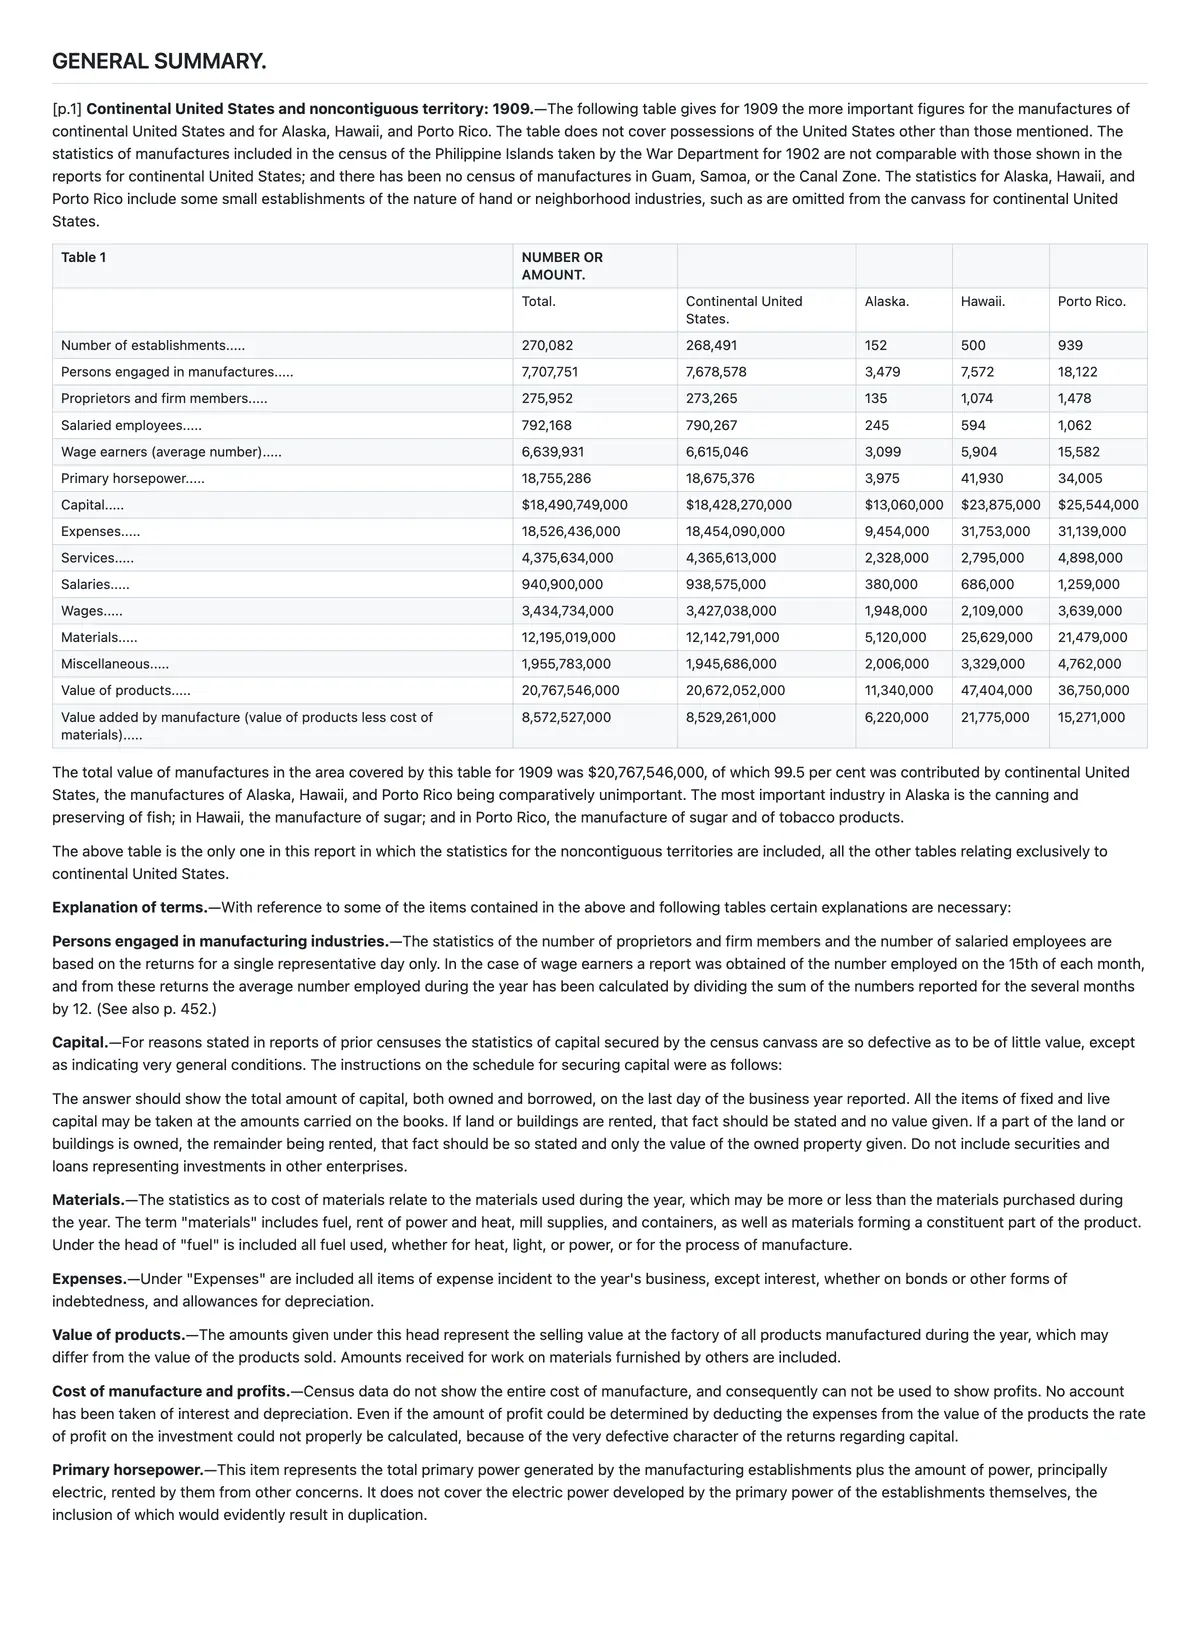
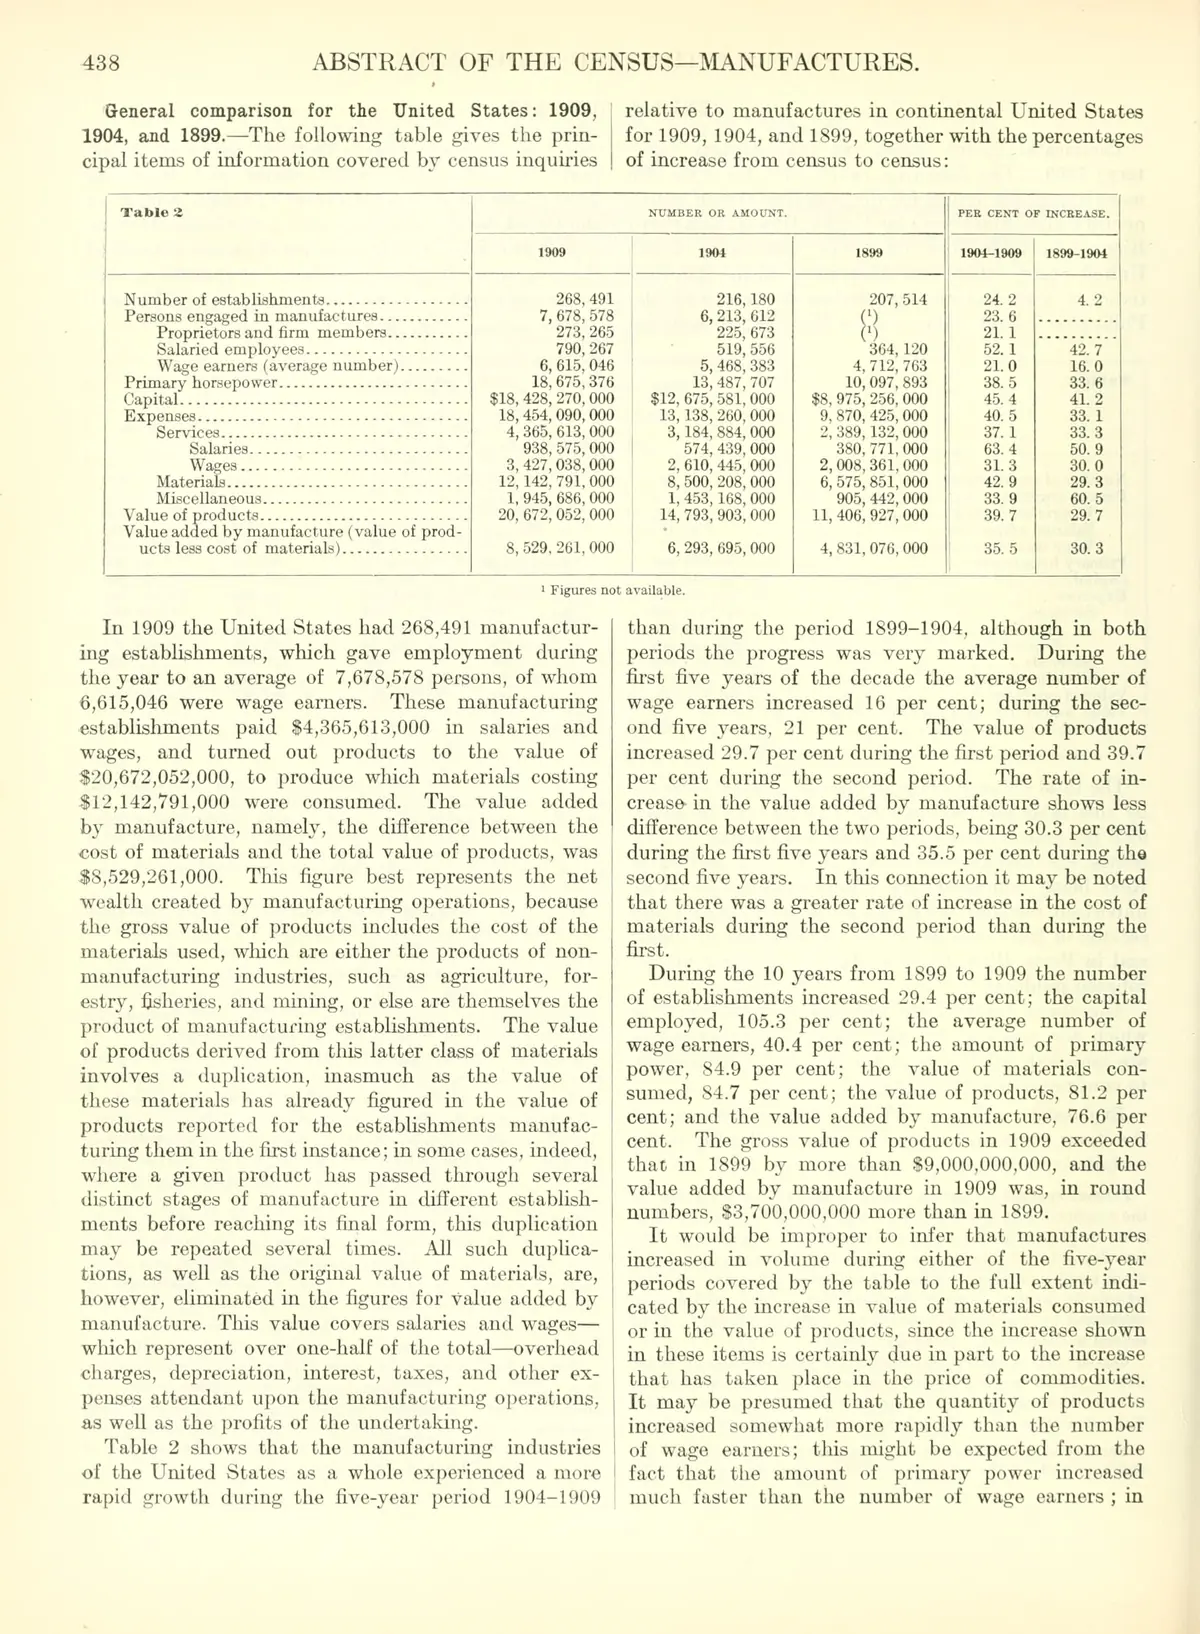
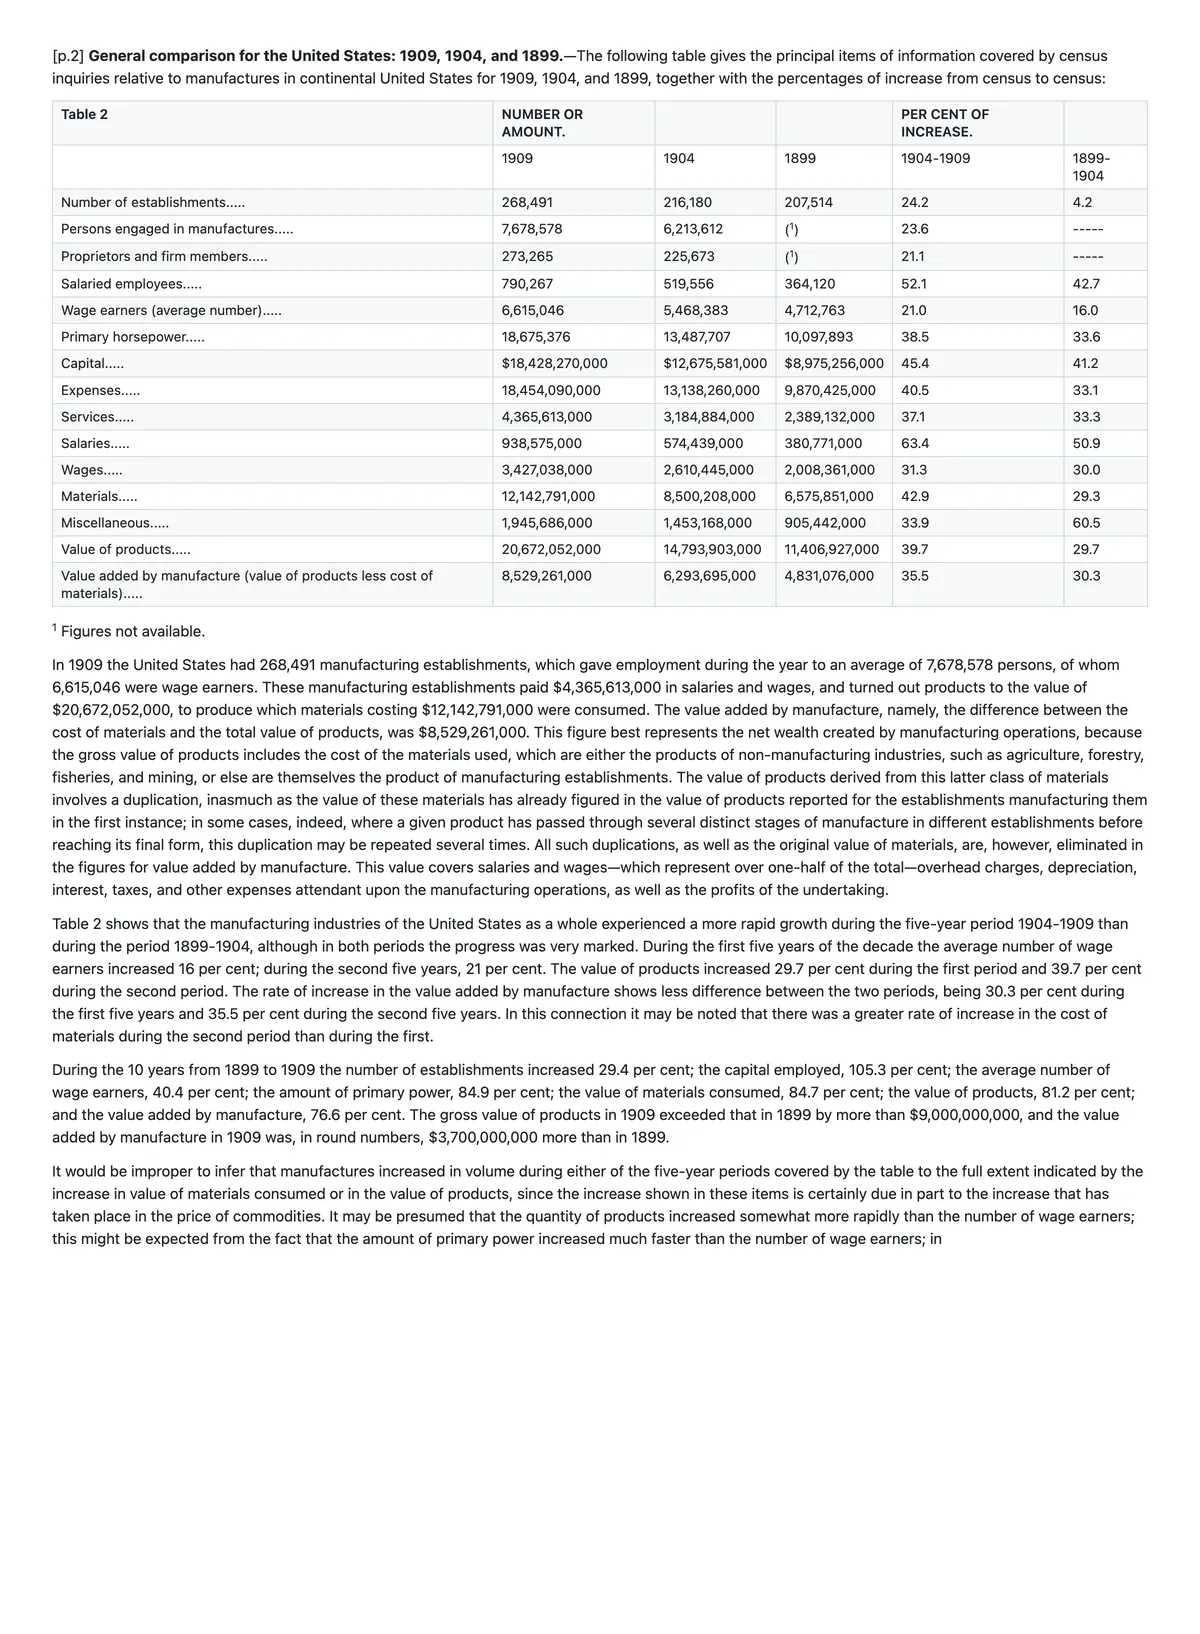
Фактический результат обработки; 5 мест исправлены вручную перед отображением · Источник: Тринадцатая перепись населения Соединенных Штатов, проведенная в 1910 году: Реферат переписи, Бюро переписи населения Соединенных Штатов, 1913 (Работа правительства США: составлена Бюро переписи населения США и опубликована Типографией правительства в 1913 году, поэтому не подлежит защите авторским правом согласно 17 U.S.C. §105; объект Internet Archive (отсканированный библиотеками Калифорнийского университета) помечен как possible-copyright-status = NOT_IN_COPYRIGHT.)
Частые вопросы
Восстанавливается ли правильный порядок в вертикальном японском тексте?
Да. Вертикальный японский текст, развороты из двух страниц и другие необычные порядки чтения исправляются автоматически и преобразуются в горизонтальный формат без необходимости разделять страницы вручную. Многоколоночные страницы возвращаются в порядке чтения, а не как один неразборчивый блок.
Как происходит оплата?
За страницу: 4 кредита за страницу, одно изображение считается за одну страницу.
Можно ли перевести извлеченный текст?
Не на этой странице. Если вам нужен перевод, возьмите извлеченный файл Word или Markdown и используйте функцию перевода файлов.
Похожие материалы
简体中文 · English · Français · Deutsch · 日本語 · 한국어
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.