文档智能提取
有些文档本身就是图:扫描的书、影印的档案、竖排的旧版面。文档提取把这些读出来,还原成能搜、能改的文字与结构。
日文与中文的竖排会转成横排;多栏页面按阅读顺序还原,而不是揉成一大团。
什么时候该用它
和格式转换的分界在于:字是不是还嵌在图里。原件是扫描件、照片、竖排老书——文字还是图像的一部分,得先认出来,用这里。原件已经是规整的电子文档、文字能直接选中,只是后缀不对,走格式转换更快。费用上两边都是 4 积分一页,差别在「页」怎么数:文档提取按原件的页数算;格式转换按整份转出的文字总量算,每满 1600 个字符记一页,零头不计,最少算一页。所以同一份 PDF,平均每页不到 1600 字符的多页文件,走格式转换更省;平均每页超过 1600 字符或只有一页的,走格式转换不会更省。
只提取,不翻译——原文是什么语言,出来还是什么语言。需要译文请用文件翻译。
可以收什么,产出什么
收 PDF、图片(PNG / JPG / WEBP / TIFF 等)、DOCX、EPUB、Markdown;产出 Word / PDF / TXT / Markdown 四选一。按页计费 4 积分一页,单张图片按 1 页。
提交后是后台任务,可以直接关页面,回来去「历史记录」拿结果;完成后可在线预览。
什么情况下提得最准
- 印刷清晰、扫描端正的版面识别率最高。
- 竖排日文、見開き这类阅读顺序特殊的版式会自动纠正,不用自己拆页。
- 图像模糊或手写体较多时,导出前对着原件过一遍更稳妥。
四种导出怎么挑
| 导出格式 | 什么时候选它 |
|---|
| Word | 还要继续改、要排版、要交给别人接着写。 |
| Markdown | 要贴进笔记软件、知识库或自己的写作流程。 |
| TXT | 只要纯文字,喂给别的工具或者做检索。 |
| PDF | 直接拿去阅读和存档。 |
实际效果
1913 年美国人口普查摘要第 437–438 页扫描件经文档提取管道转成可编辑正文与统计表格,展示第 437 页的表 1 和相关说明。
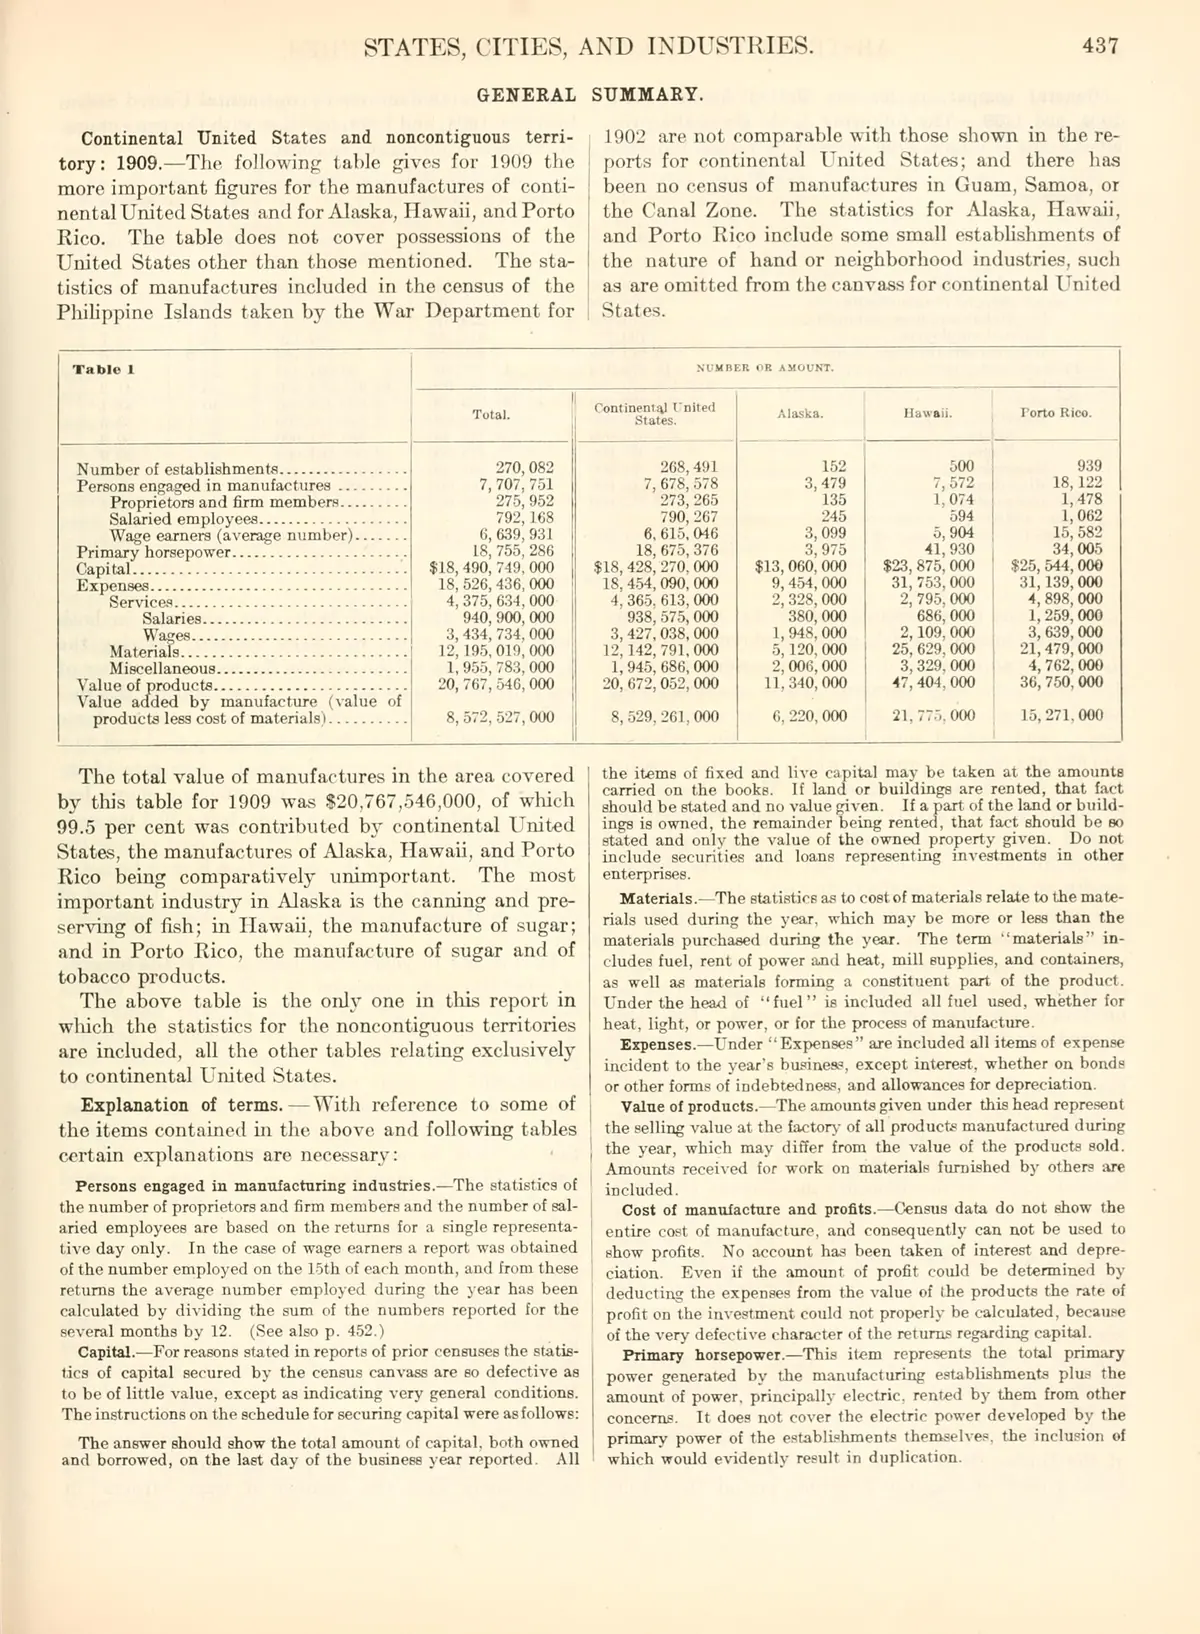
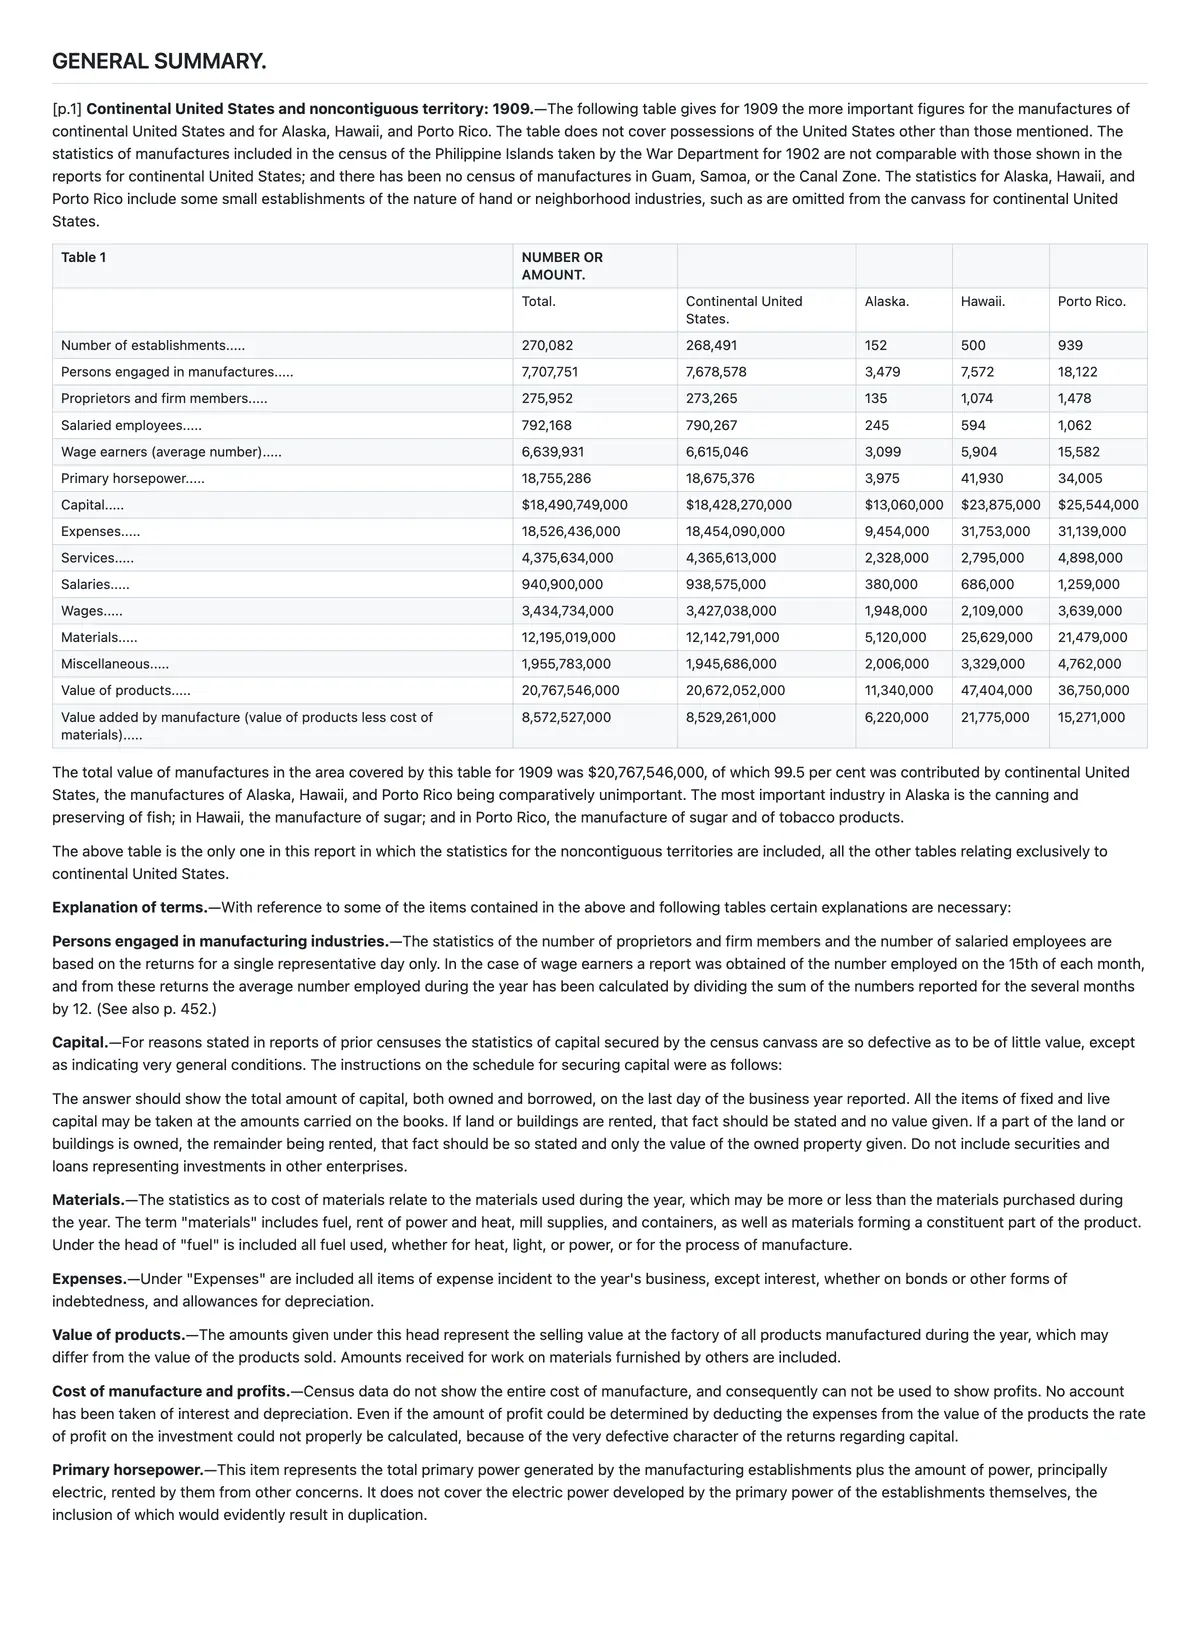 1913 年美国人口普查摘要第 437 页(无文字层的扫描件):正文文字和粗体小标题识别准确;Table 1 还原为 15 行、5 个数据列的可编辑表格,75 个数字与原件逐格一致。
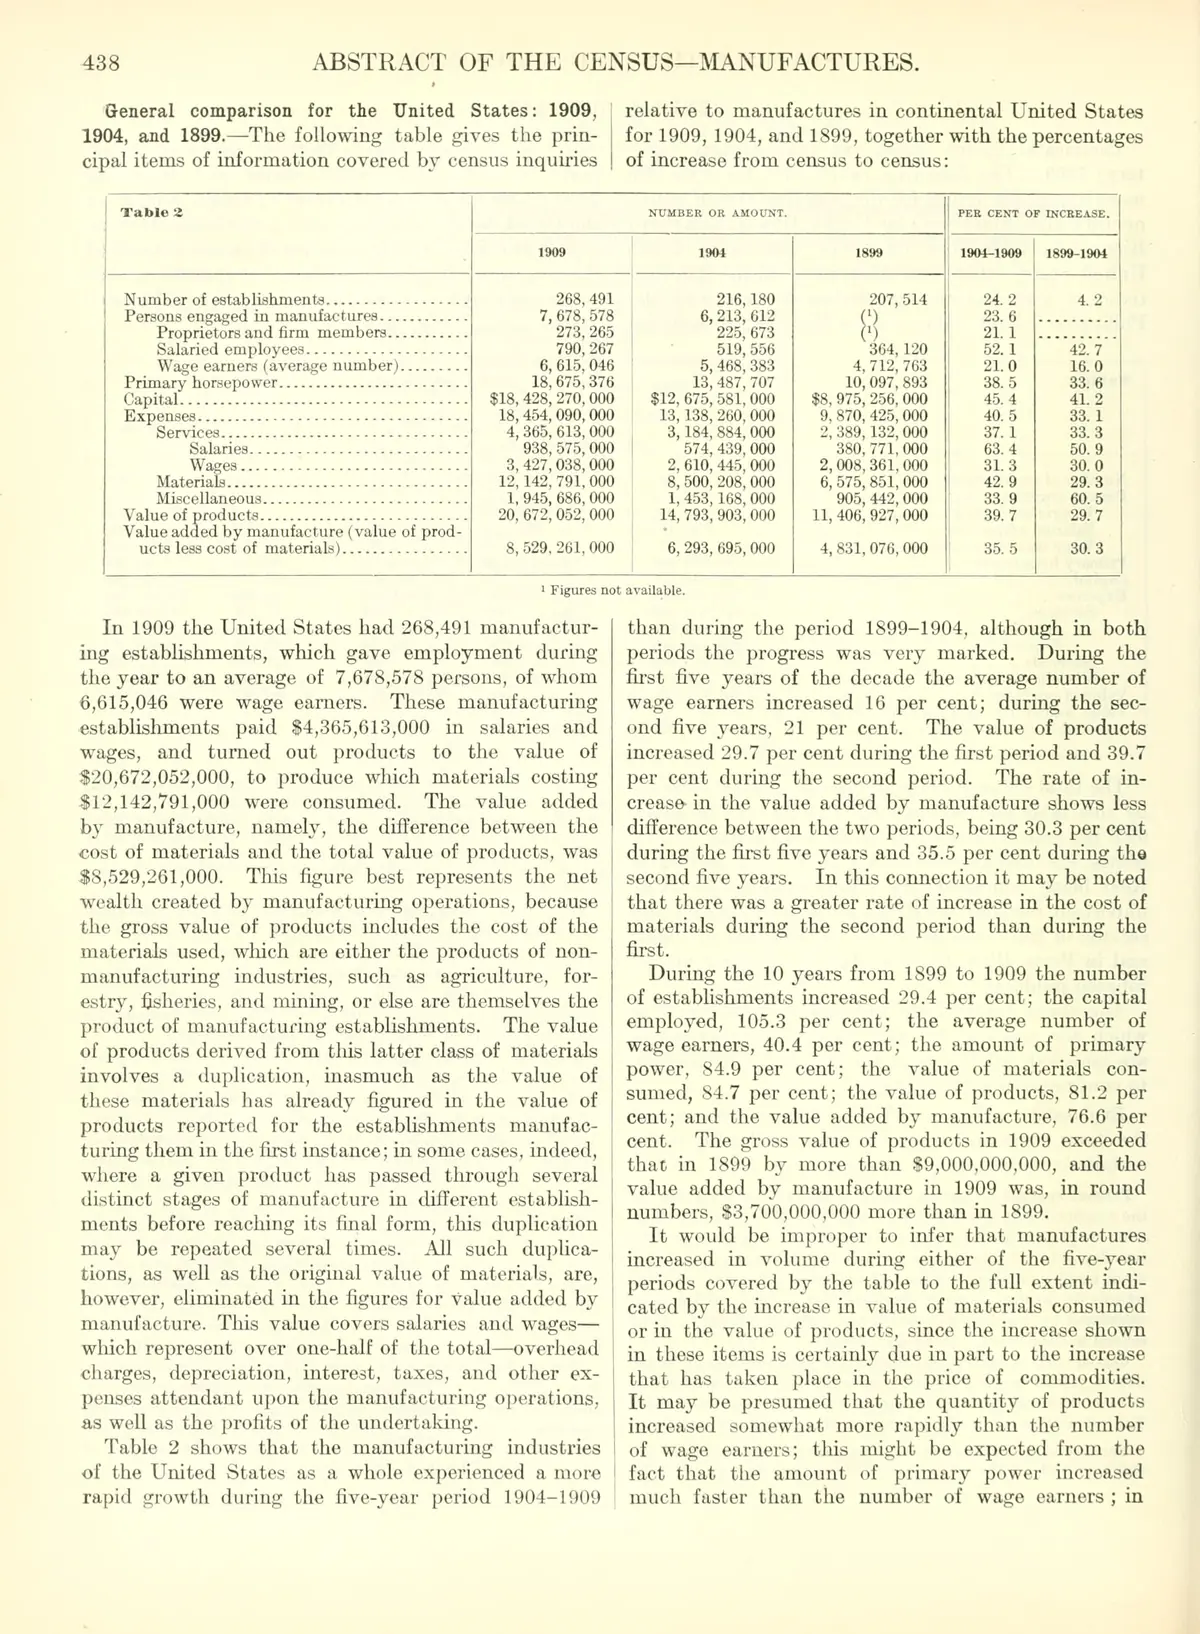
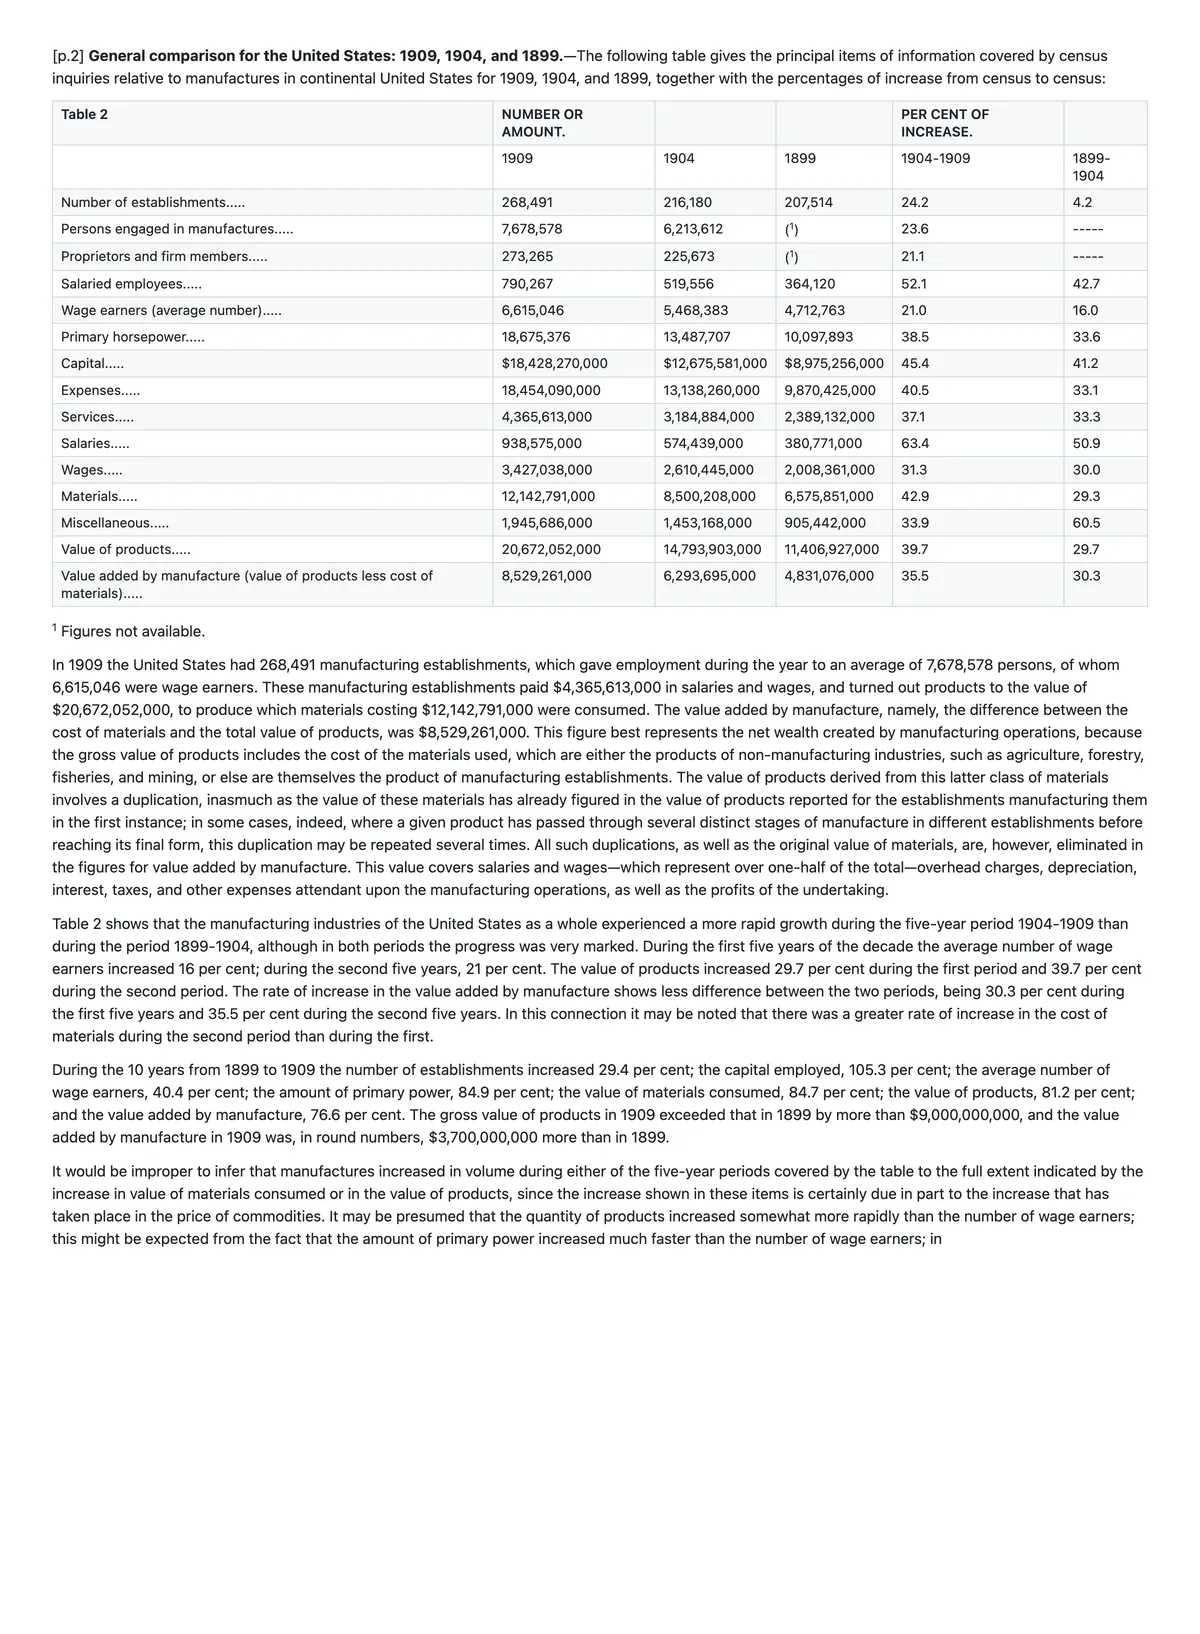 第 438 页:带两层表头(NUMBER OR AMOUNT. 与 PER CENT OF INCREASE. 下面再分年份)的 1899–1909 对比表,还原为两行表头的可编辑表格,数字与原件逐格一致;脚注标记 (1) 和脚注「Figures not available.」保留。
经格译提取管道生成;展示前对照原件检查表头、数字与脚注。英文原文提取,未翻译。 · 原文:Thirteenth Census of the United States Taken in the Year 1910: Abstract of the Census,美国人口普查局,1913(美国联邦政府作品:由美国人口普查局编写、美国政府印刷局(Govt. Print. Off.)1913 年出版,按美国版权法第 105 条不受版权保护;Internet Archive 该条目(加州大学图书馆扫描)标注 possible-copyright-status = NOT_IN_COPYRIGHT。)
常见问题
竖排日文能正确还原顺序吗?
能。竖排日文、見開き这类阅读顺序特殊的版式会自动纠正并转成横排,不用自己拆页;多栏页面按阅读顺序还原,而不是揉成一大团。
怎么收费?
按页计费,4 积分一页,单张图片按一页算。
提取完能直接翻译吗?
本页不做翻译。需要译文时,把提取出的 Word 或 Markdown 拿到文件翻译再跑一次即可。
相关内容
English · Français · Deutsch · Русский · 日本語 · 한국어 · العربية · 繁體中文
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.