Dokumentenextraktion
Manche Dokumente sind Bilder von Text: eingescannte Bücher, kopierte Archive, vertikal gesetzte Seiten. Die Extraktion liest diese und liefert Text und Struktur, die Sie durchsuchen und bearbeiten können.
Vertikaler japanischer und chinesischer Satz wird in horizontale Ausgabe umgewandelt, und mehrspaltige Seiten werden in der Leserichtung zurückgegeben, anstatt als ein durcheinandergewürfelter Block.
Wann man es verwendet
Die Grenze zur Formatkonvertierung liegt dort, wo der Text noch in einem Bild eingeschlossen ist. Scans, Fotos und alte, vertikal gesetzte Bücher gehören hierher, da die Zeichen zuerst erkannt werden müssen. Dokumente, die bereits sauber und digital vorliegen, bei denen der Text ausgewählt werden kann und nur die Dateiendung falsch ist, werden durch die Formatkonvertierung verarbeitet, was schneller geht. Beide kosten 4 Account-Credits pro Seite, aber sie zählen Seiten unterschiedlich: Die Dokumentenextraktion zählt die Seiten des Originals, während die Formatkonvertierung den Text der gesamten konvertierten Datei zählt (eine Seite pro angefangene 1.600 Zeichen, wobei der Rest wegfällt und mindestens eine Seite berechnet wird). Bei demselben PDF kostet eine mehrseitige Datei mit durchschnittlich weniger als 1.600 Zeichen pro Seite weniger in der Konvertierung; eine mit durchschnittlich mehr als 1.600 Zeichen pro Seite oder mit nur einer Seite kostet nicht weniger.
Nur Extraktion, keine Übersetzung – welche Sprache auch immer eingegeben wird, kommt wieder heraus. Verwenden Sie die Dateiübersetzung, wenn Sie eine Übersetzung benötigen.
Was akzeptiert und produziert wird
Es akzeptiert PDF, Bilder (PNG / JPG / WEBP / TIFF und ähnliche), DOCX, EPUB und Markdown und produziert Word, PDF, TXT oder Markdown. Die Abrechnung erfolgt pro Seite: 4 Account-Credits pro Seite, wobei ein einzelnes Bild als eine Seite zählt.
Es läuft als Hintergrundauftrag, sodass Sie die Seite schließen und das Ergebnis später unter Verlauf abrufen können. Abgeschlossene Aufträge können online in der Vorschau angesehen werden.
Wann die Extraktion am genauesten ist
- Sauberer Druck, gerade eingescannt, liefert die höchste Erkennungsrate.
- Vertikales Japanisch, Doppelseiten und andere ungewöhnliche Leserichtungen werden automatisch korrigiert – Sie müssen die Seiten nicht selbst trennen.
- Wenn das Bild unscharf oder größtenteils handschriftlich ist, ist es sicherer, es vor dem Export mit dem Original abzugleichen.
Auswahl zwischen den vier Exportformaten
| Export | Wählen Sie dies, wenn |
|---|---|
| Word | Sie weiter bearbeiten, formatieren oder das Dokument an jemanden weitergeben möchten. |
| Markdown | Es in eine Notizen-App, eine Wissensdatenbank oder Ihr eigenes Schreib-Setup integriert werden soll. |
| TXT | Sie reinen Text benötigen, um ihn in ein anderes Tool einzuspeisen oder zu durchsuchen. |
| Sie es nur lesen und archivieren möchten. |
Beispiele
Zwei gescannte Seiten des U.S. Census Abstract von 1913 (zweispaltiger Text plus Statistiktabellen, keine Textebene) werden durch die Dokumentenextraktion in bearbeitbaren Text umgewandelt: Der Fließtext und die fettgedruckten Überschriften werden präzise erkannt, und beide Tabellen, eine davon mit einer zweistufigen Kopfzeile, werden als echte Tabellen mit 30 Datenzeilen zurückgegeben, deren Zahlen Zelle für Zelle mit dem Original übereinstimmen, Fußnoten inklusive.
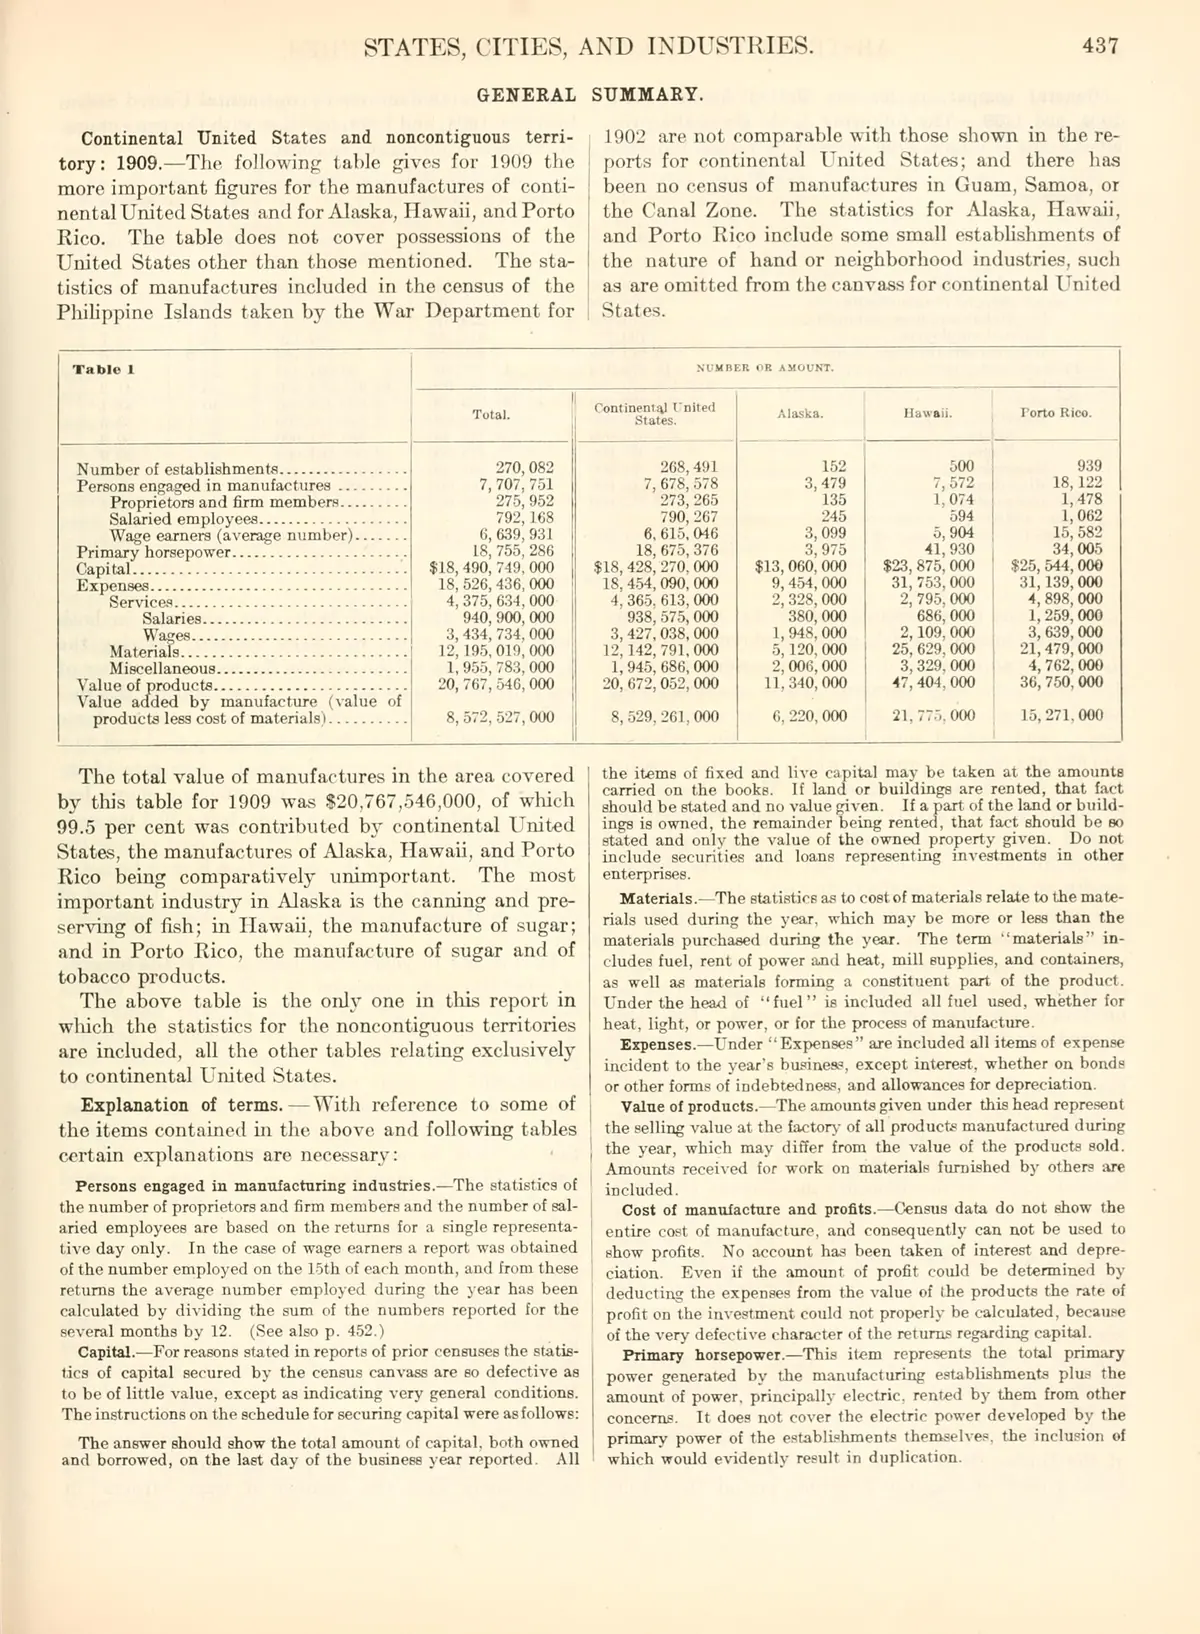
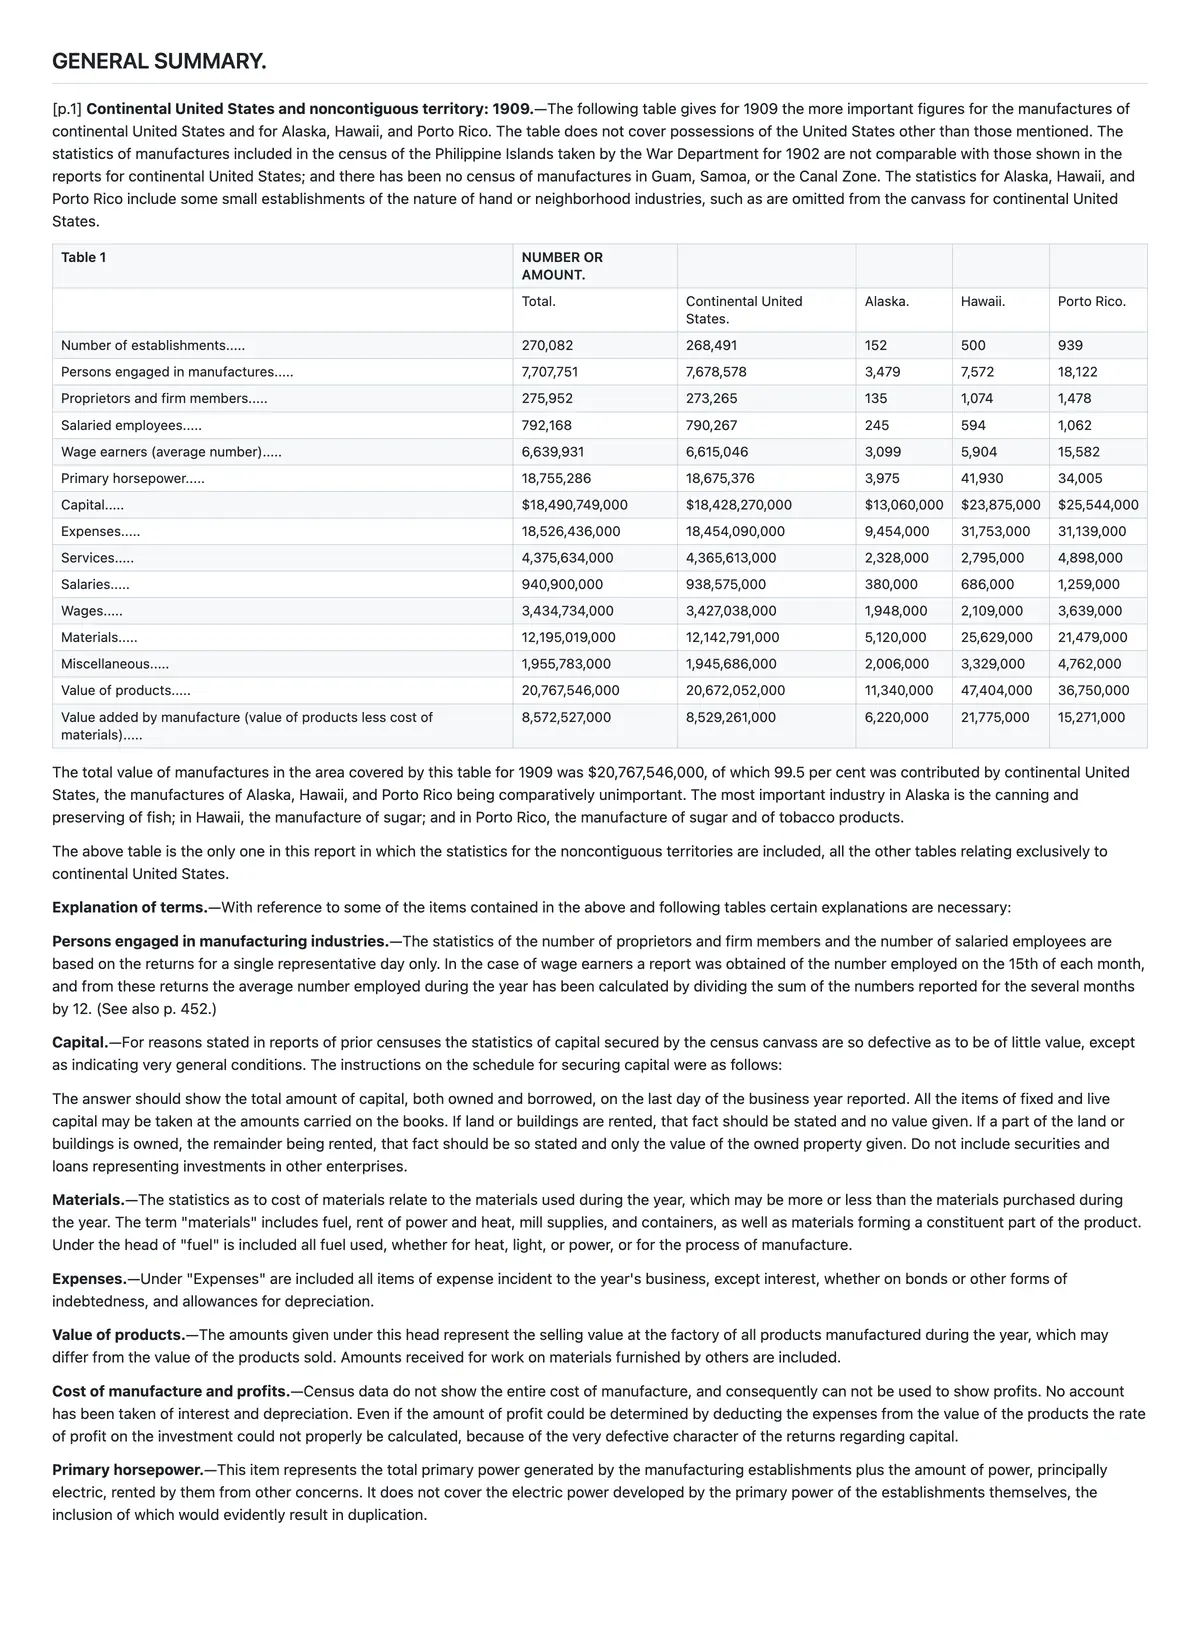
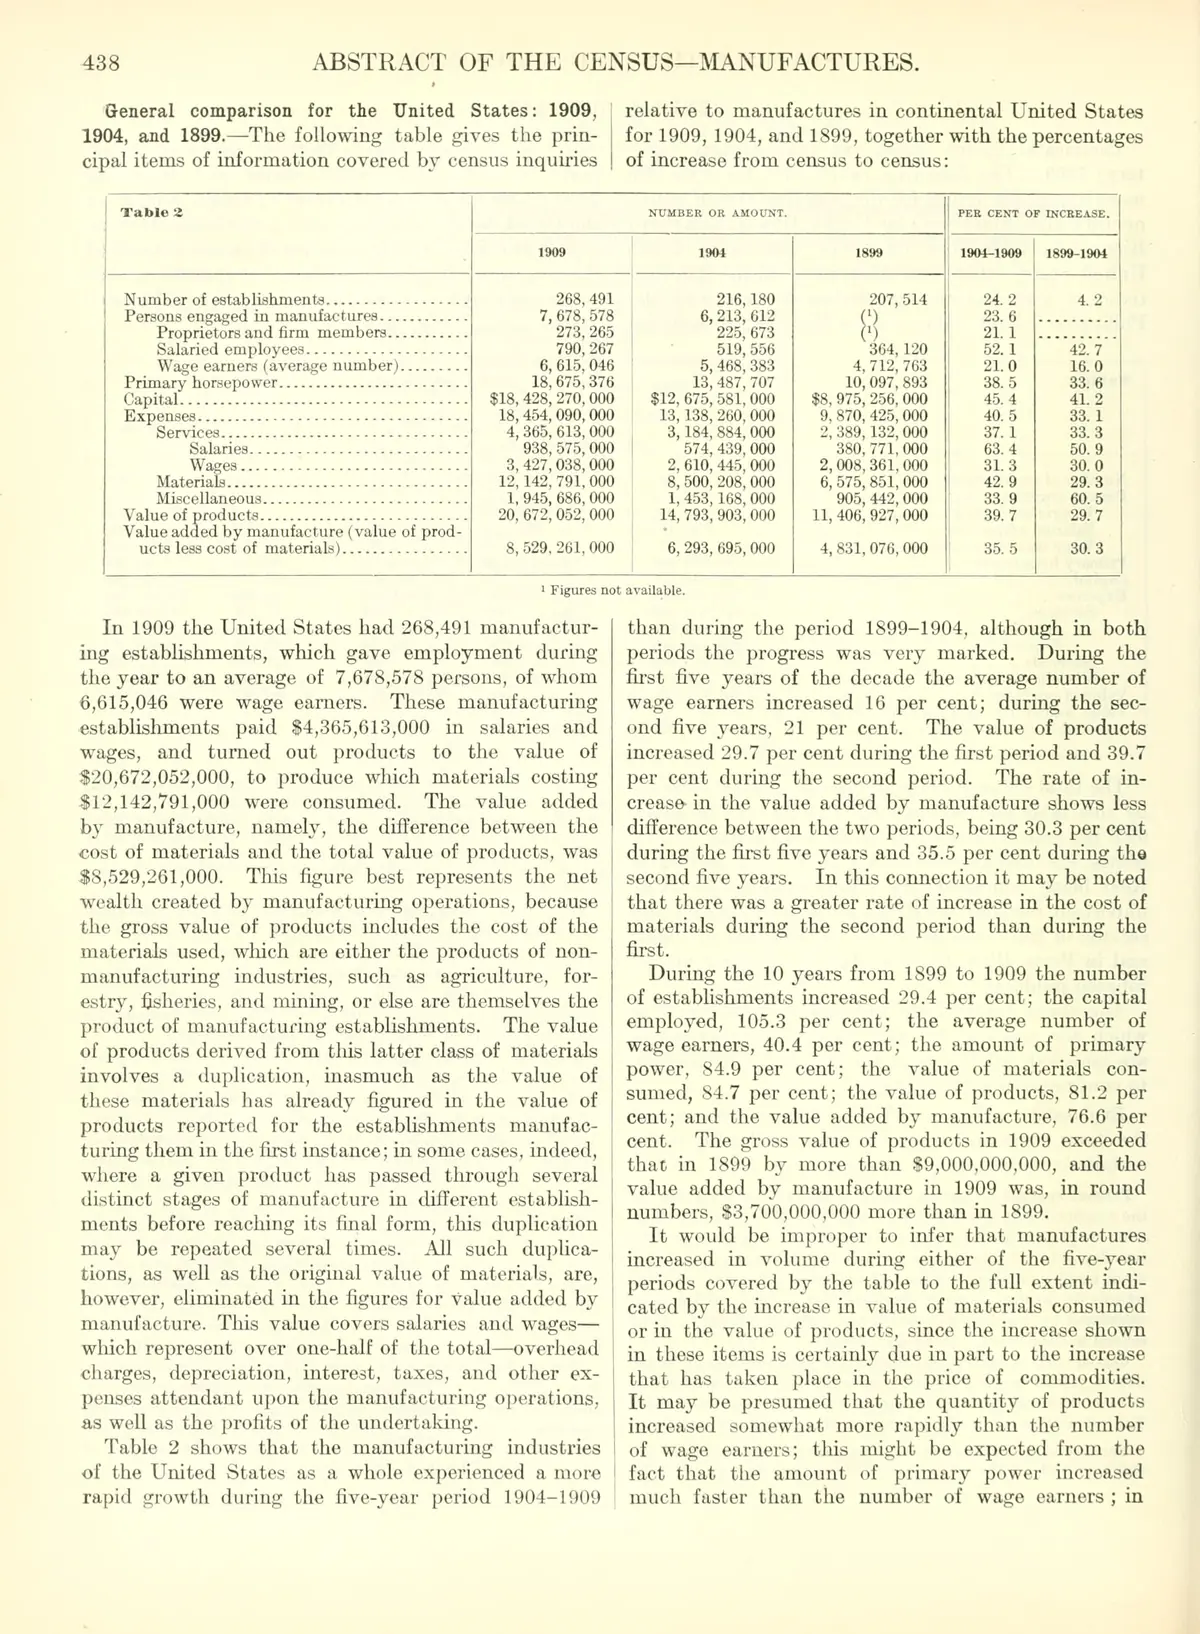
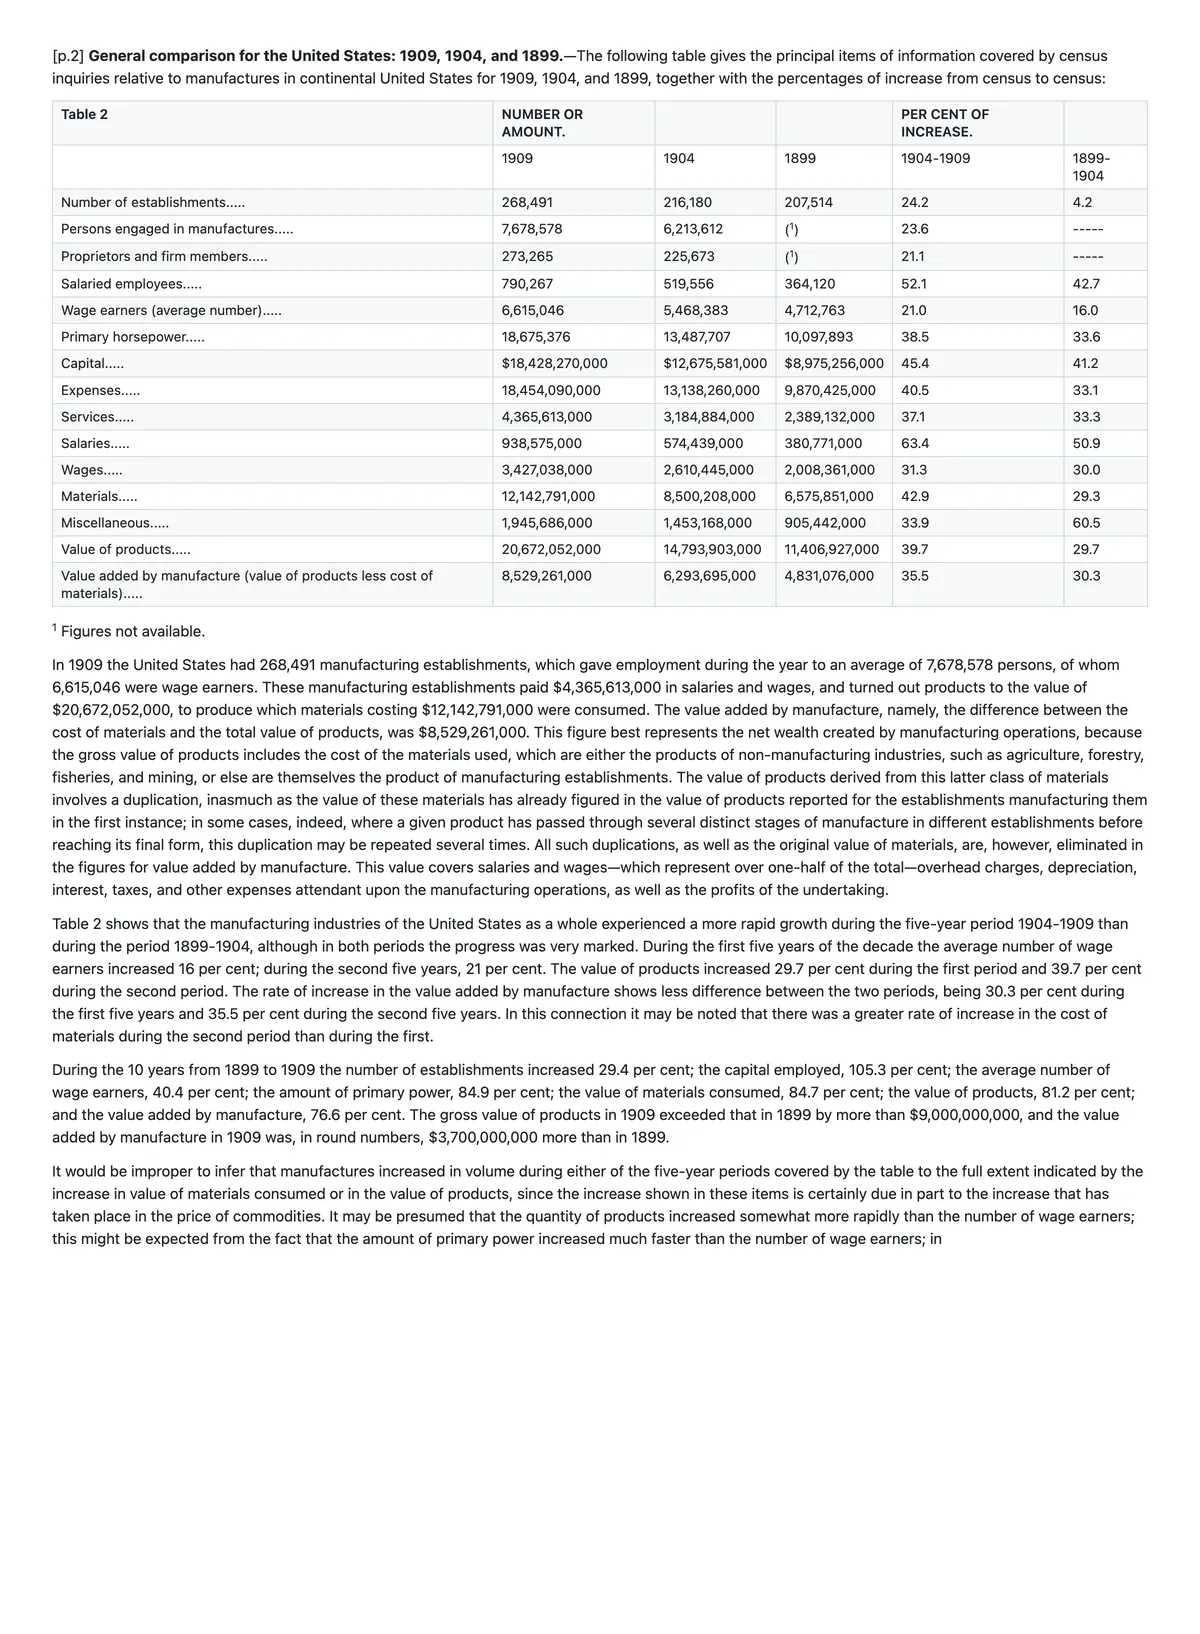
Tatsächliches Produktionsergebnis; 5 Stellen vor der Anzeige manuell korrigiert · Quelle: Thirteenth Census of the United States Taken in the Year 1910: Abstract of the Census, United States Bureau of the Census, 1913 (Arbeit der US-Regierung: zusammengestellt vom U.S. Bureau of the Census und 1913 vom Government Printing Office veröffentlicht, daher gemäß 17 U.S.C. §105 nicht urheberrechtlich geschützt; das Internet Archive-Objekt (gescannt von den University of California Libraries) ist als possible-copyright-status = NOT_IN_COPYRIGHT markiert.)
Häufige Fragen
Wird vertikales Japanisch wieder in die richtige Reihenfolge gebracht?
Ja. Vertikales Japanisch, Doppelseiten und andere ungewöhnliche Leserichtungen werden automatisch korrigiert und in horizontale Ausgabe umgewandelt, ohne dass Sie Seiten selbst trennen müssen. Mehrspaltige Seiten werden in der Leserichtung zurückgegeben, anstatt als ein durcheinandergewürfelter Block.
Wie erfolgt die Abrechnung?
Pro Seite: 4 Account-Credits pro Seite, wobei ein einzelnes Bild als eine Seite zählt.
Kann es das Extrahierte übersetzen?
Nicht auf dieser Seite. Wenn Sie eine Übersetzung benötigen, nehmen Sie die extrahierte Word- oder Markdown-Datei und verwenden Sie die Dateiübersetzung.
Verwandte Inhalte
- Erkunden Sie ein Beispiel, bevor Sie Ihr eigenes Dokument verwenden
- OCR und Übersetzung für Archivbestände
简体中文 · English · Français · Русский · 日本語 · 한국어
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.