Extracción de documentos
Algunos documentos son imágenes de texto: libros escaneados, archivos fotocopiados, páginas compuestas en vertical. La extracción los lee y devuelve texto y estructura que puedes buscar y editar.
La composición vertical en japonés y chino se convierte a salida horizontal, y las páginas a varias columnas vuelven en orden de lectura en lugar de como un solo bloque revuelto.
Cuándo usarla
La diferencia con la conversión de formatos está en si el texto sigue atrapado dentro de una imagen. Los escaneos, las fotos y los libros antiguos con texto vertical van aquí, porque primero hay que reconocer los caracteres. Los documentos que ya son digitales y limpios, en los que el texto se puede seleccionar y solo la extensión no es la adecuada, pasan por la conversión de formatos, que es más rápida. Ambas cobran 4 créditos por página, pero cuentan las páginas de forma distinta: la extracción de documentos cuenta las páginas del original, mientras que la conversión de formatos cuenta el texto de todo el archivo convertido, una página por cada 1,600 caracteres completos; el resto se descarta y se cobra como mínimo una página. Con un mismo PDF, convertir un archivo de varias páginas con un promedio de menos de 1,600 caracteres por página cuesta menos; convertir uno con un promedio de más de 1,600 caracteres por página, o de una sola página, no cuesta menos.
Solo extracción, sin traducción: el texto sale en el mismo idioma en que entró. Usa la traducción de archivos cuando necesites una traducción.
Qué acepta y qué genera
Acepta PDF, imágenes (PNG / JPG / WEBP / TIFF y similares), DOCX, EPUB y Markdown, y genera Word, PDF, TXT o Markdown. Se cobra por página: 4 créditos por página, y una sola imagen cuenta como una página.
Se ejecuta como un trabajo en segundo plano, así que puedes cerrar la página y recoger el resultado más tarde en el Historial. Los trabajos terminados se pueden previsualizar en línea.
Cuándo es más precisa la extracción
- Una impresión limpia, escaneada derecha, da la tasa de reconocimiento más alta.
- El japonés vertical, las páginas dobles y otros órdenes de lectura poco comunes se corrigen automáticamente; no hace falta que separes las páginas tú.
- Si la imagen está borrosa o es en gran parte manuscrita, lo más seguro es cotejar con el original antes de exportar.
Cómo elegir entre los cuatro formatos de exportación
| Formato | Elígelo cuando |
|---|
| Word | Vas a seguir editándolo, darle formato o pasárselo a otra persona para que continúe. |
| Markdown | Va a ir a una app de notas, una base de conocimiento o tu propio entorno de escritura. |
| TXT | Quieres texto plano para usarlo en otra herramienta o para hacer búsquedas. |
| PDF | Solo vas a leerlo y archivarlo. |
Resultados reales
Las páginas escaneadas 437–438 del Abstract del censo de los Estados Unidos de 1913 se convierten en texto editable y tablas estadísticas mediante la extracción de documentos. La vista previa muestra la tabla 1 de la página 437 y la explicación que la rodea.
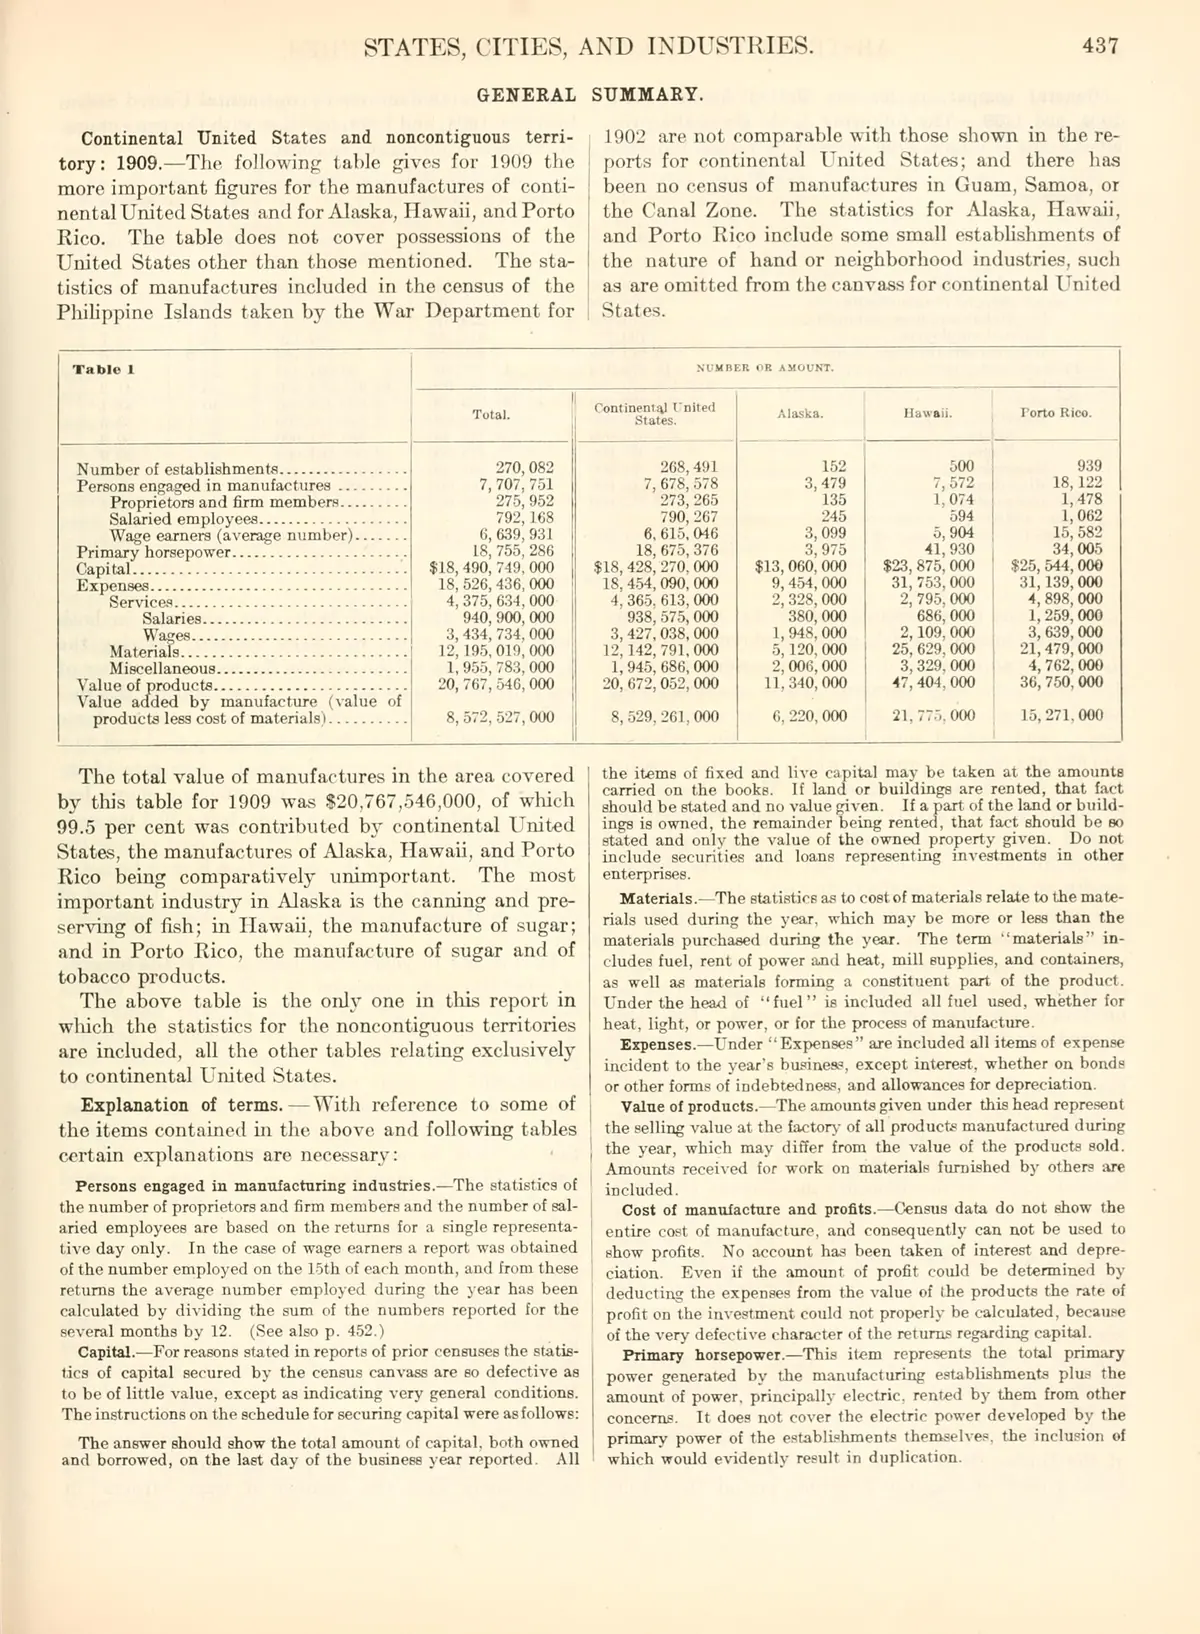
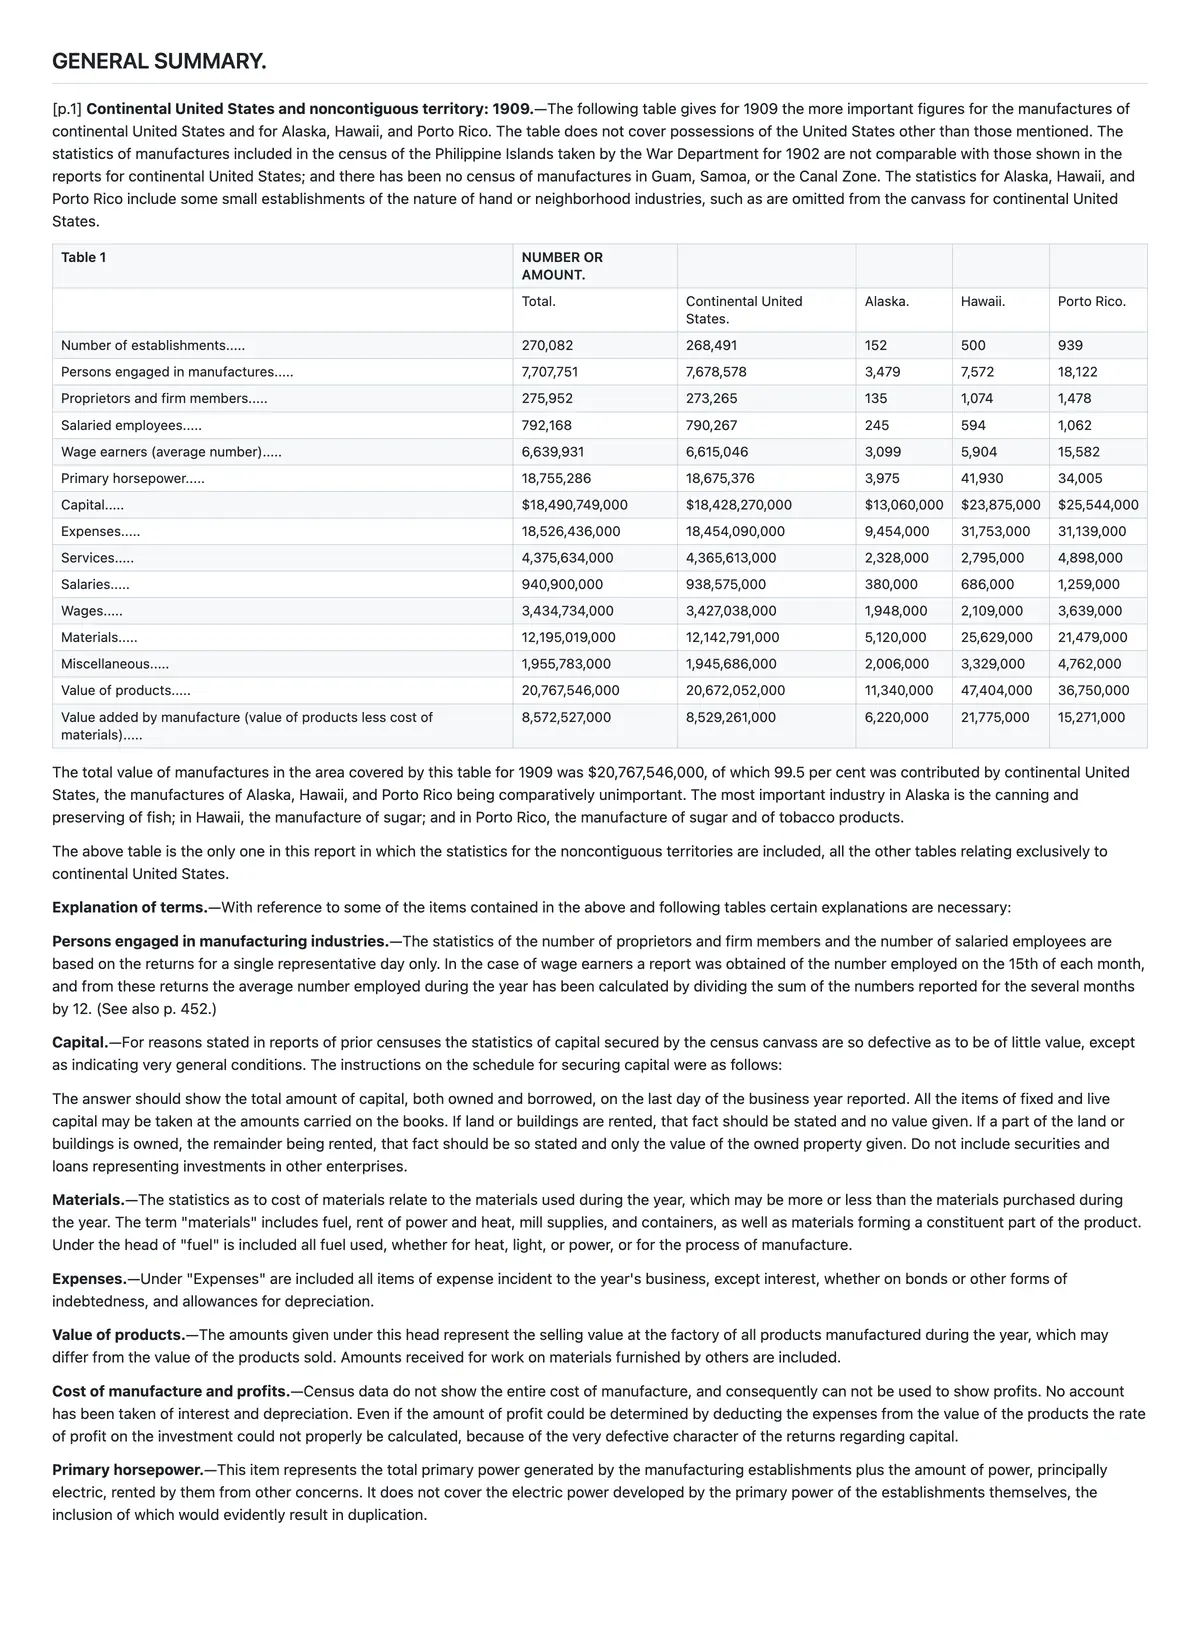 Página 437 del Abstract del censo de los Estados Unidos de 1913, un escaneo sin capa de texto: el cuerpo del texto y los encabezados en negrita integrados al párrafo se reconocen con precisión, y la tabla 1 se convierte en una tabla editable de 15 filas y 5 columnas de datos cuyas 75 cifras coinciden con el original celda por celda.
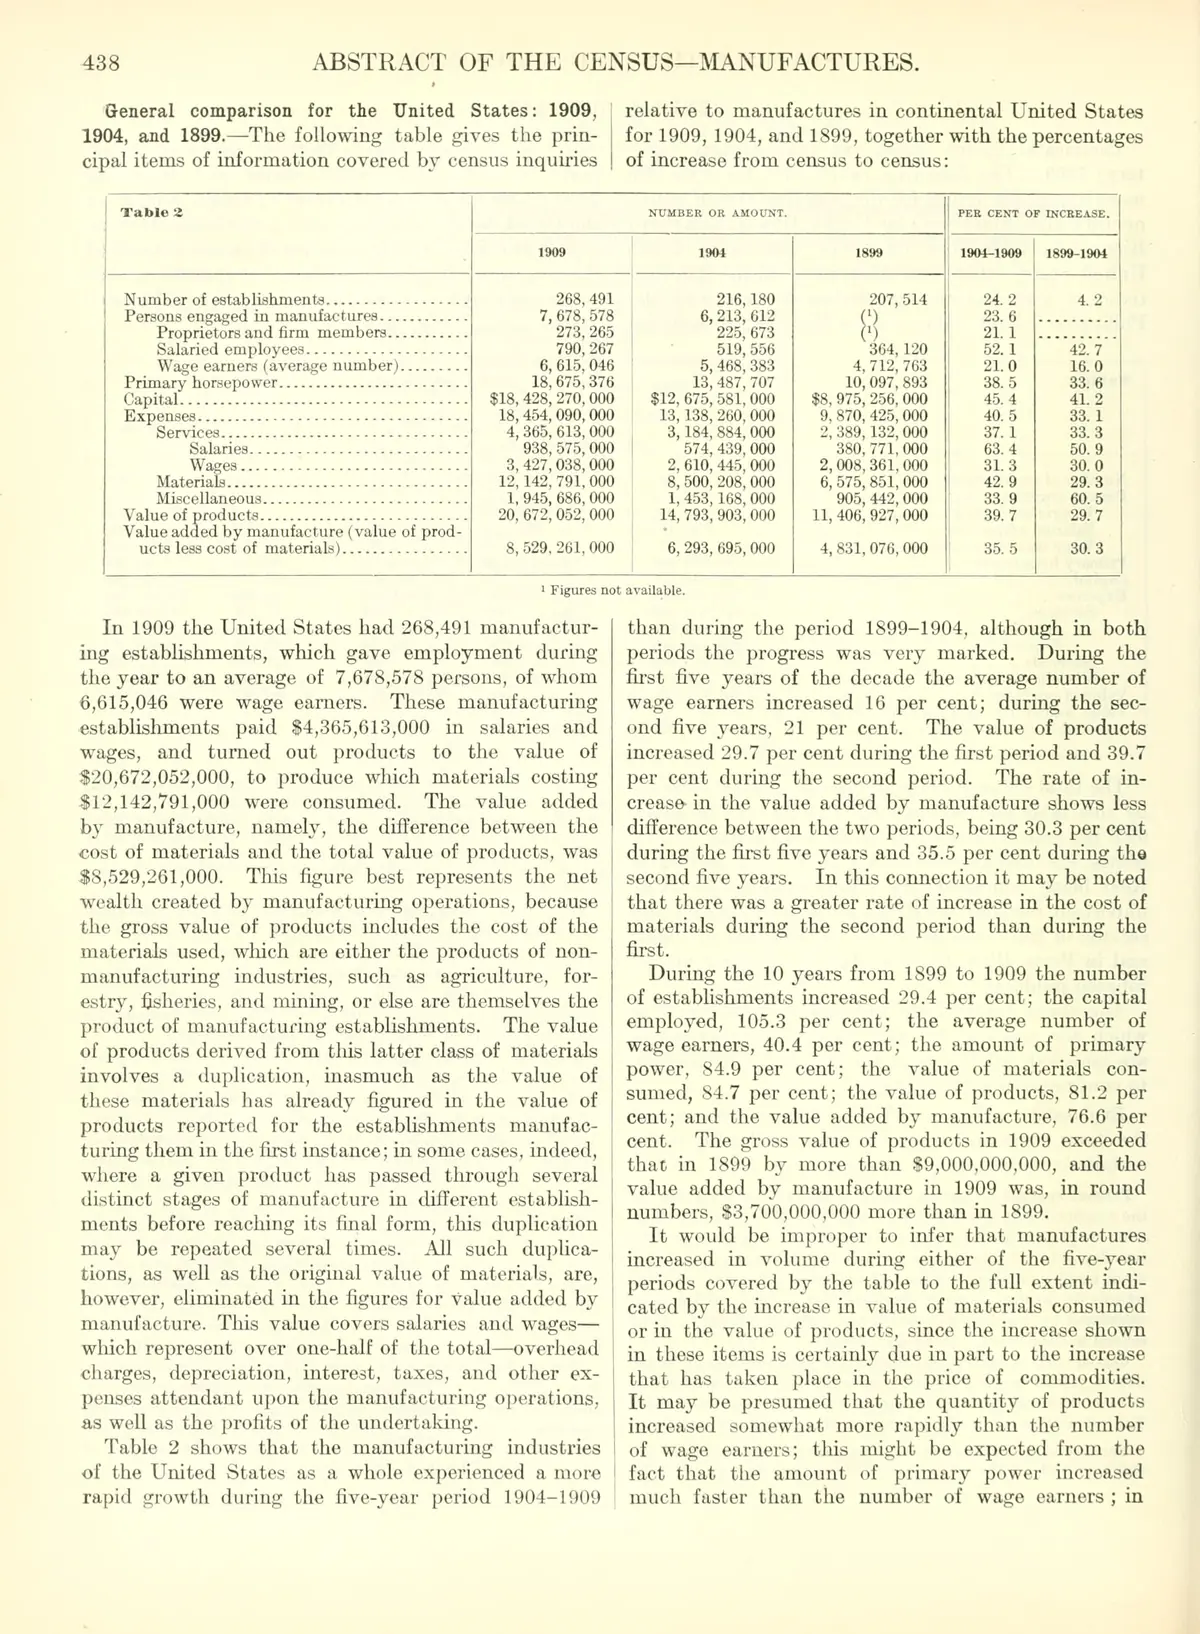
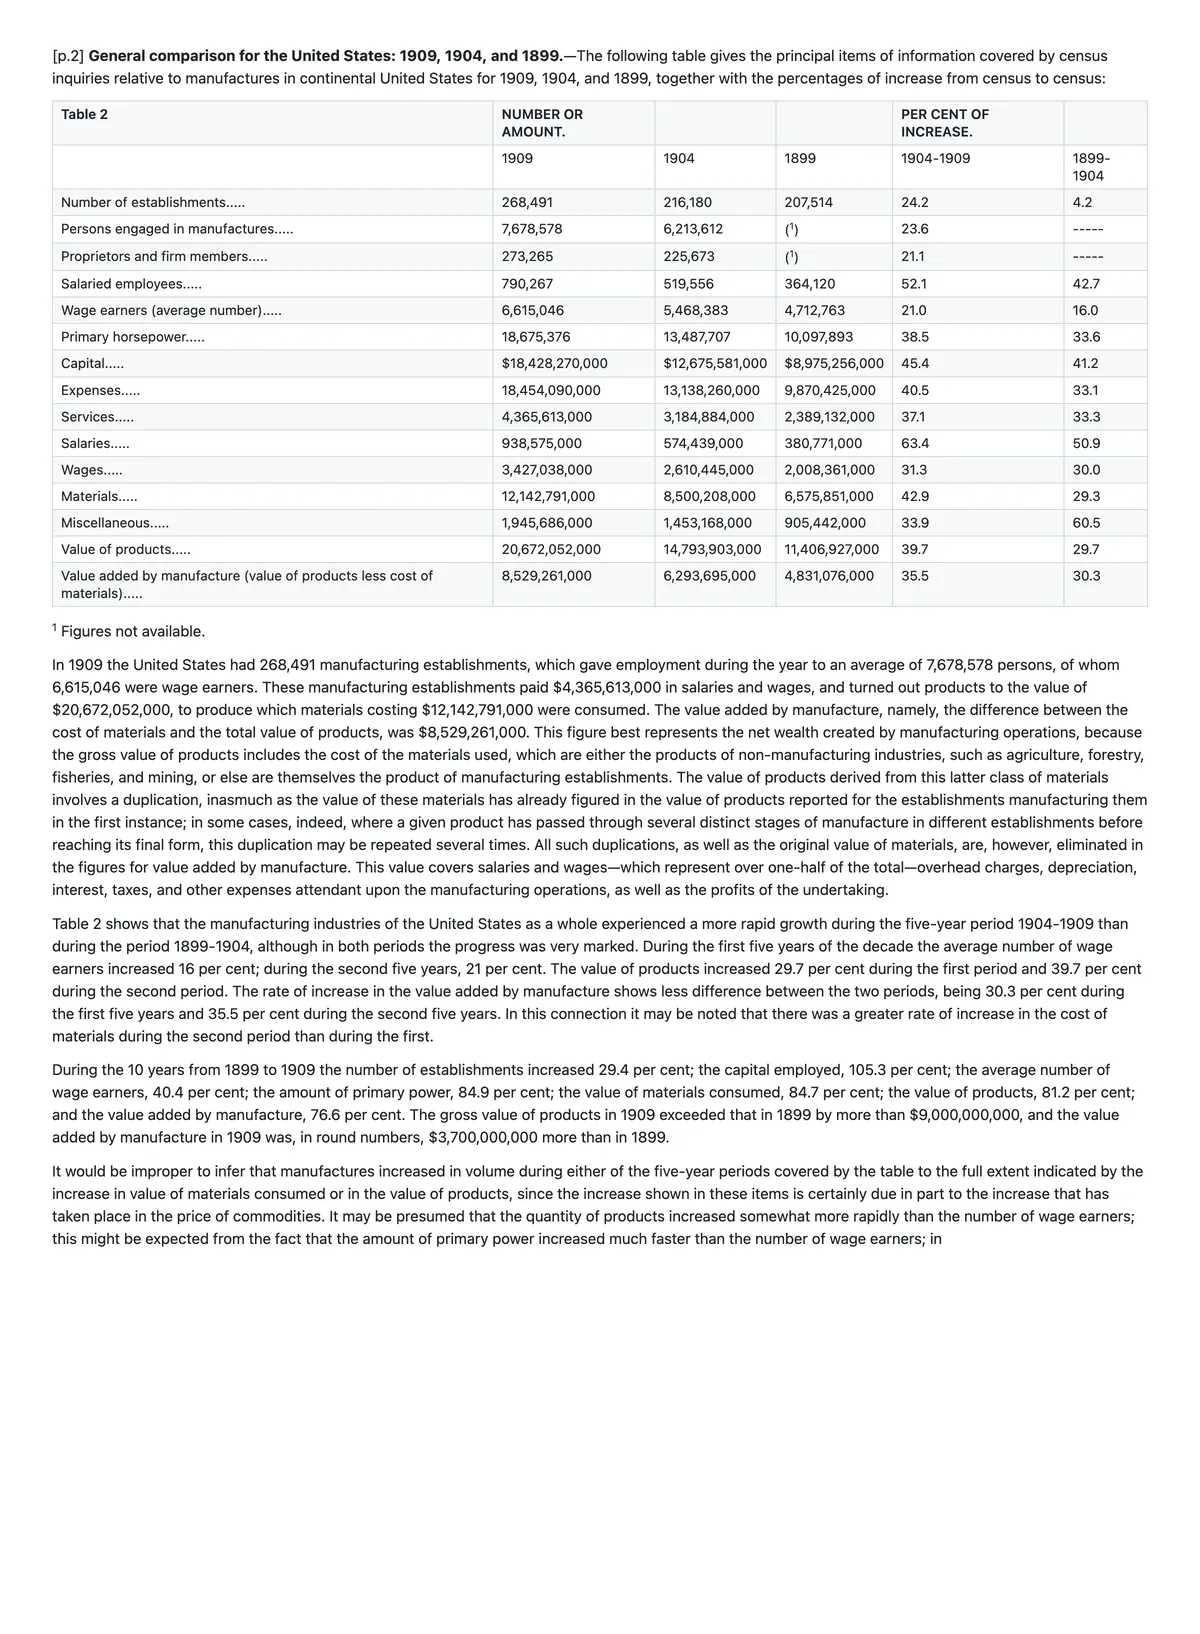 Página 438: una tabla comparativa de 1899–1909 con encabezado de dos niveles (Number or Amount y Per Cent of Increase, cada uno dividido por año) se convierte en una tabla editable con dos filas de encabezado y cifras que coinciden con el original celda por celda; se conservan la llamada de nota (1) y la nota “Figures not available.”
Generado con el flujo de extracción de Geyi; antes de mostrarse, los encabezados, las cifras y las notas al pie se cotejaron con el escaneo. Extracción en inglés, sin traducción. · Fuente: Decimotercer censo de los Estados Unidos, realizado en 1910: resumen del censo, Oficina del Censo de los Estados Unidos, 1913 (Obra del Gobierno de los Estados Unidos: compilada por la Oficina del Censo de los Estados Unidos y publicada por la Government Printing Office en 1913, por lo que no está sujeta a derechos de autor conforme al 17 U.S.C. §105; el elemento de Internet Archive (escaneado por las bibliotecas de la Universidad de California) está marcado como possible-copyright-status = NOT_IN_COPYRIGHT.)
Preguntas frecuentes
¿El japonés vertical vuelve en el orden correcto?
Sí. El japonés vertical, las páginas dobles y otros órdenes de lectura poco comunes se corrigen automáticamente y se convierten a salida horizontal, sin que tengas que separar las páginas. Las páginas a varias columnas vuelven en orden de lectura en lugar de como un solo bloque revuelto.
¿Cómo se cobra?
Por página: 4 créditos por página, y una sola imagen cuenta como una página.
¿Puede traducir lo que extrae?
En esta página no. Cuando necesites una traducción, lleva el archivo Word o Markdown extraído a la traducción de archivos y procésalo ahí.
Contenido relacionado
简体中文 · English · Français · Deutsch · Русский · 日本語 · 한국어 · العربية · 繁體中文 · Português (Brasil)
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.