Extração de documentos
Alguns documentos são fotos de texto: livros digitalizados, arquivos fotocopiados, páginas com composição vertical. A extração lê esses documentos e devolve texto e estrutura que você pode pesquisar e editar.
A composição vertical em japonês e em chinês é convertida em saída horizontal, e páginas com várias colunas voltam na ordem de leitura, em vez de um único bloco embaralhado.
Quando usar
O que a separa da conversão de formatos é saber se o texto ainda está preso dentro de uma imagem. Digitalizações, fotos e livros antigos com composição vertical vêm para cá, porque os caracteres precisam ser reconhecidos primeiro. Documentos que já são digitais e limpos, em que o texto pode ser selecionado e só a extensão está errada, passam pela conversão de formatos, que é mais rápida. As duas cobram 4 créditos por página, mas contam as páginas de forma diferente: a extração de documentos conta as páginas do original, enquanto a conversão de formatos conta o texto do arquivo convertido inteiro, uma página a cada 1.600 caracteres completos, com o resto descartado e no mínimo uma página cobrada. Para o mesmo PDF, um arquivo de várias páginas com média inferior a 1.600 caracteres por página custa menos para converter; um com média superior a 1.600 caracteres por página, ou com uma única página, não sai mais barato na conversão.
Só extração, sem tradução — o idioma que entra é o mesmo que sai. Use a tradução de arquivos quando precisar de uma tradução.
O que aceita e o que gera
Aceita PDF, imagens (PNG / JPG / WEBP / TIFF e semelhantes), DOCX, EPUB e Markdown, e gera Word, PDF, TXT ou Markdown. A cobrança é por página: 4 créditos por página, e uma imagem avulsa conta como uma página.
Roda como tarefa em segundo plano, então você pode fechar a página e pegar o resultado depois no Histórico. As tarefas concluídas podem ser visualizadas online.
Quando a extração é mais precisa
- Impressão nítida, digitalizada sem inclinação, dá a maior taxa de reconhecimento.
- Japonês vertical, páginas duplas e outras ordens de leitura incomuns são corrigidos automaticamente — não é preciso separar as páginas você mesmo.
- Quando a imagem está borrada ou é em grande parte manuscrita, o mais seguro é conferir com o original antes de exportar.
Como escolher entre as quatro exportações
| Exportação | Escolha quando |
|---|
| Word | Você vai continuar editando, formatar ou repassar a outra pessoa para dar continuidade. |
| Markdown | O texto vai para um app de notas, uma base de conhecimento ou o seu próprio fluxo de escrita. |
| TXT | Você quer texto puro para alimentar outra ferramenta ou para pesquisar. |
| PDF | Você só vai ler e arquivar. |
Resultados na prática
As páginas digitalizadas 437–438 do resumo do Censo dos Estados Unidos de 1913 viram texto editável e tabelas estatísticas por meio da extração de documentos. A prévia mostra a Tabela 1 da página 437 e a explicação ao redor.
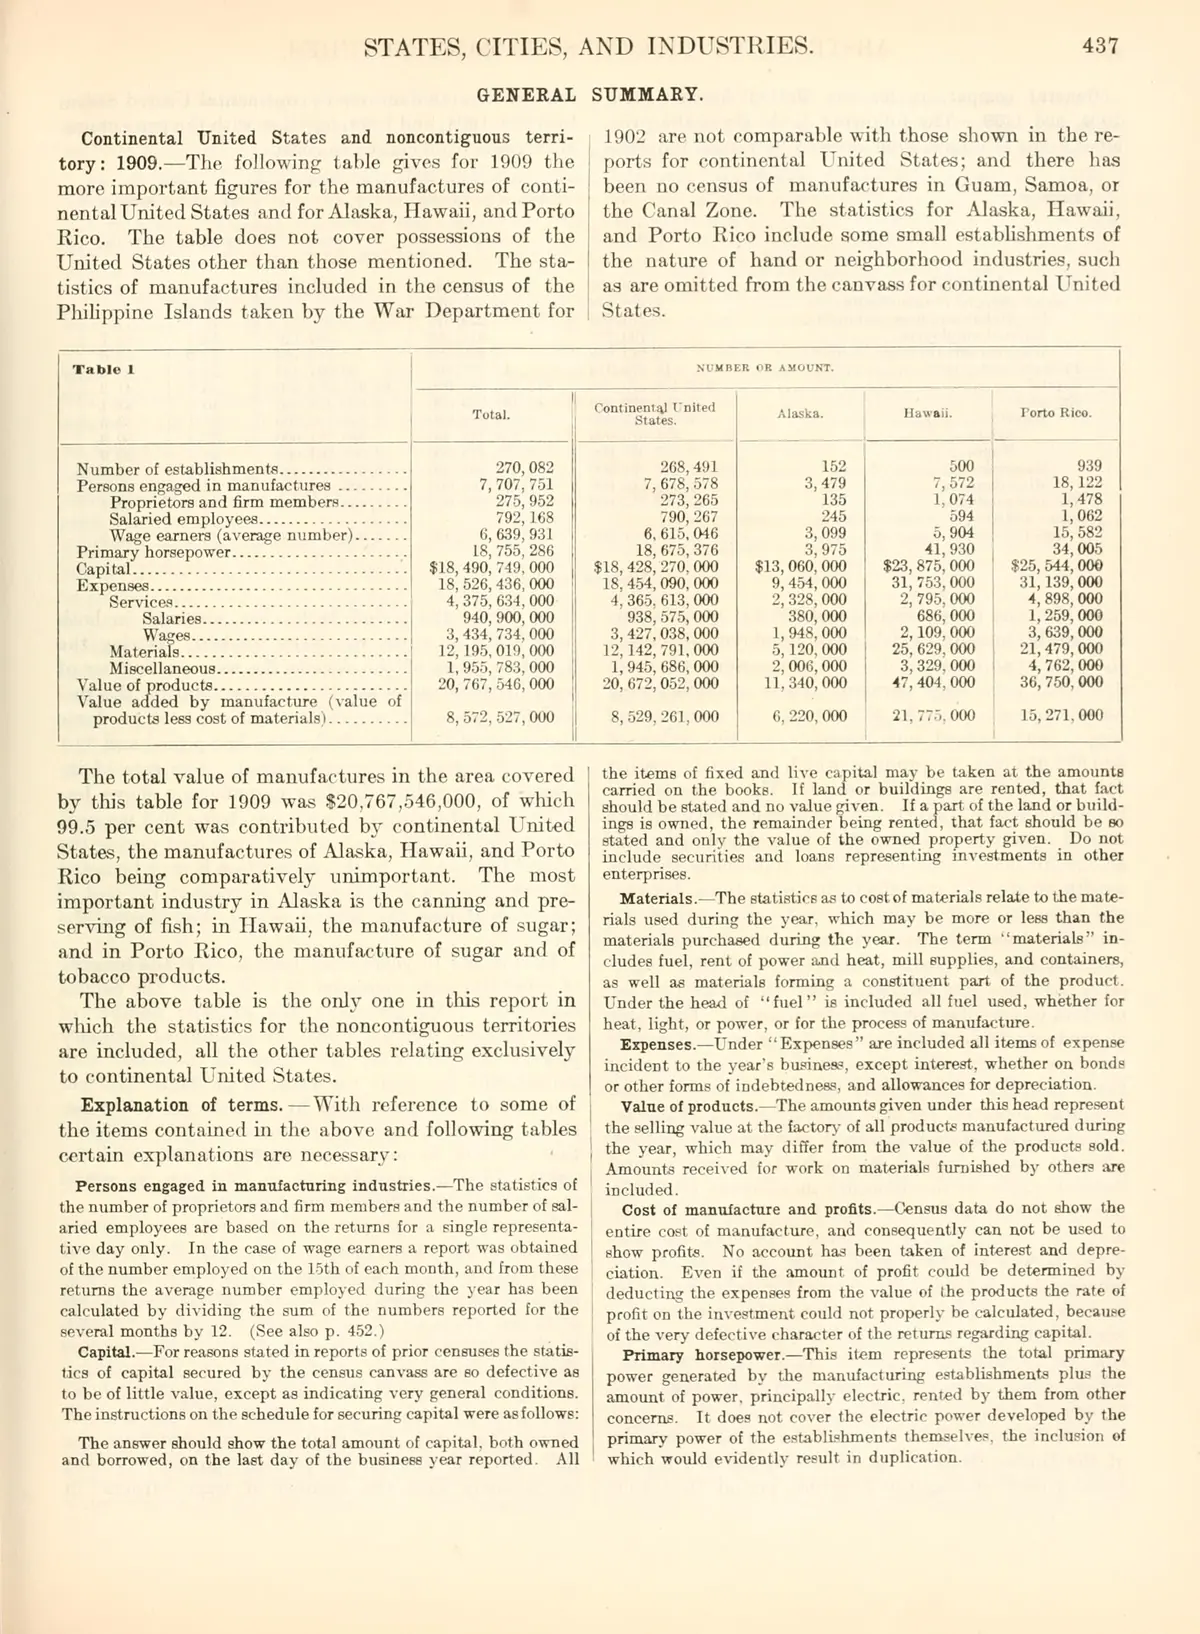
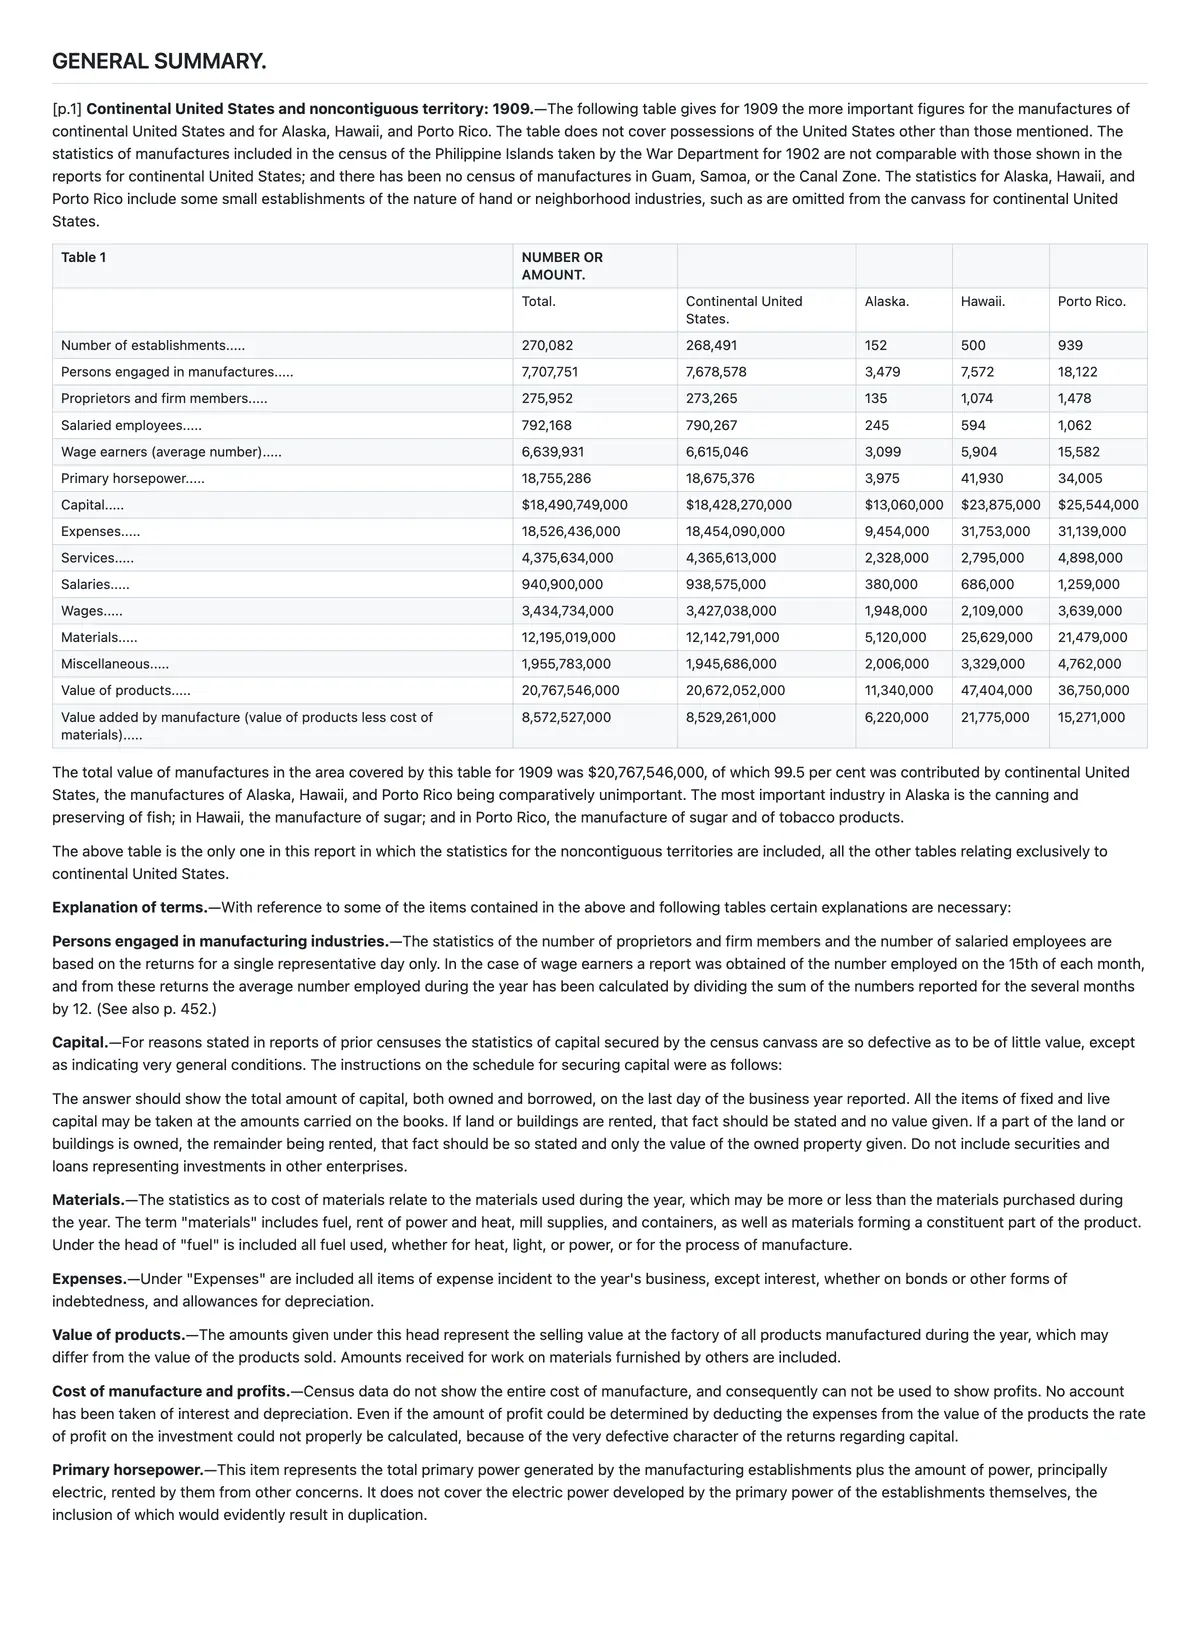 Página 437 do resumo do Censo dos Estados Unidos de 1913, uma digitalização sem camada de texto: o corpo do texto e os intertítulos em negrito incorporados aos parágrafos são reconhecidos com precisão, e a Tabela 1 vira uma tabela editável de 15 linhas e 5 colunas de dados, cujos 75 números correspondem ao original célula por célula.
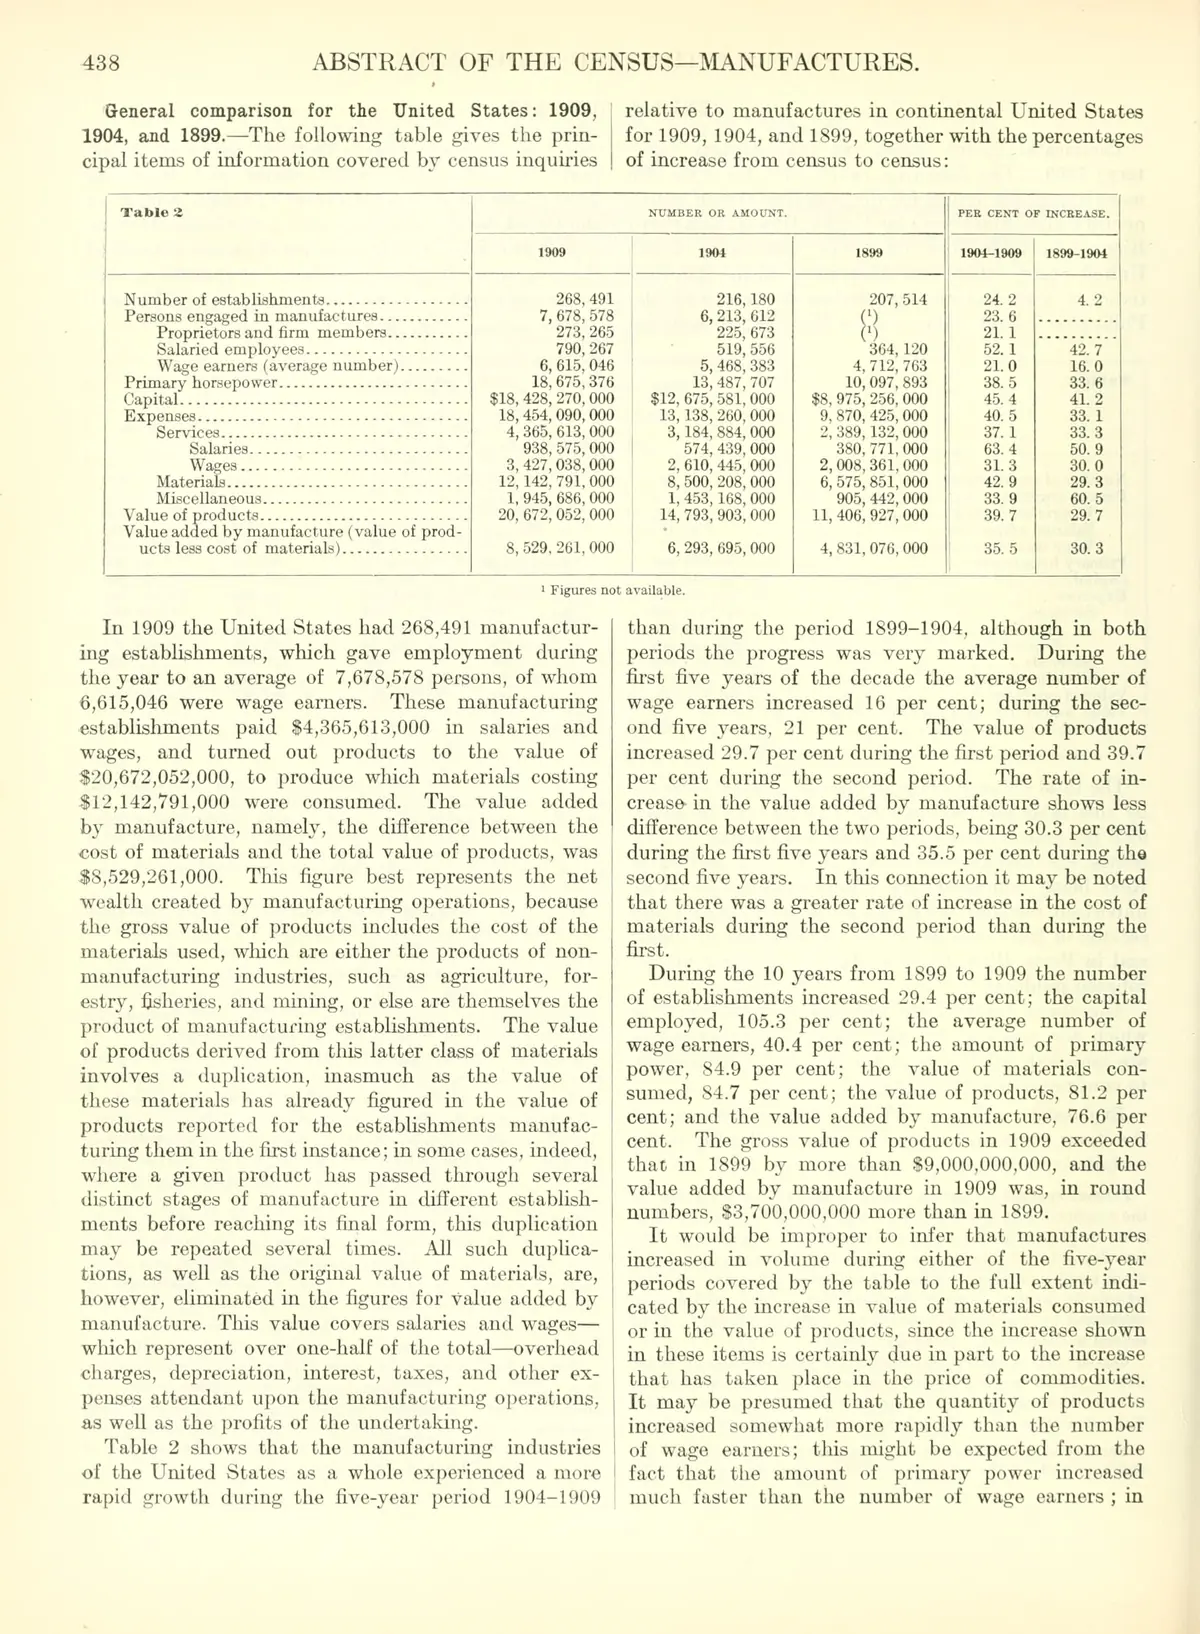
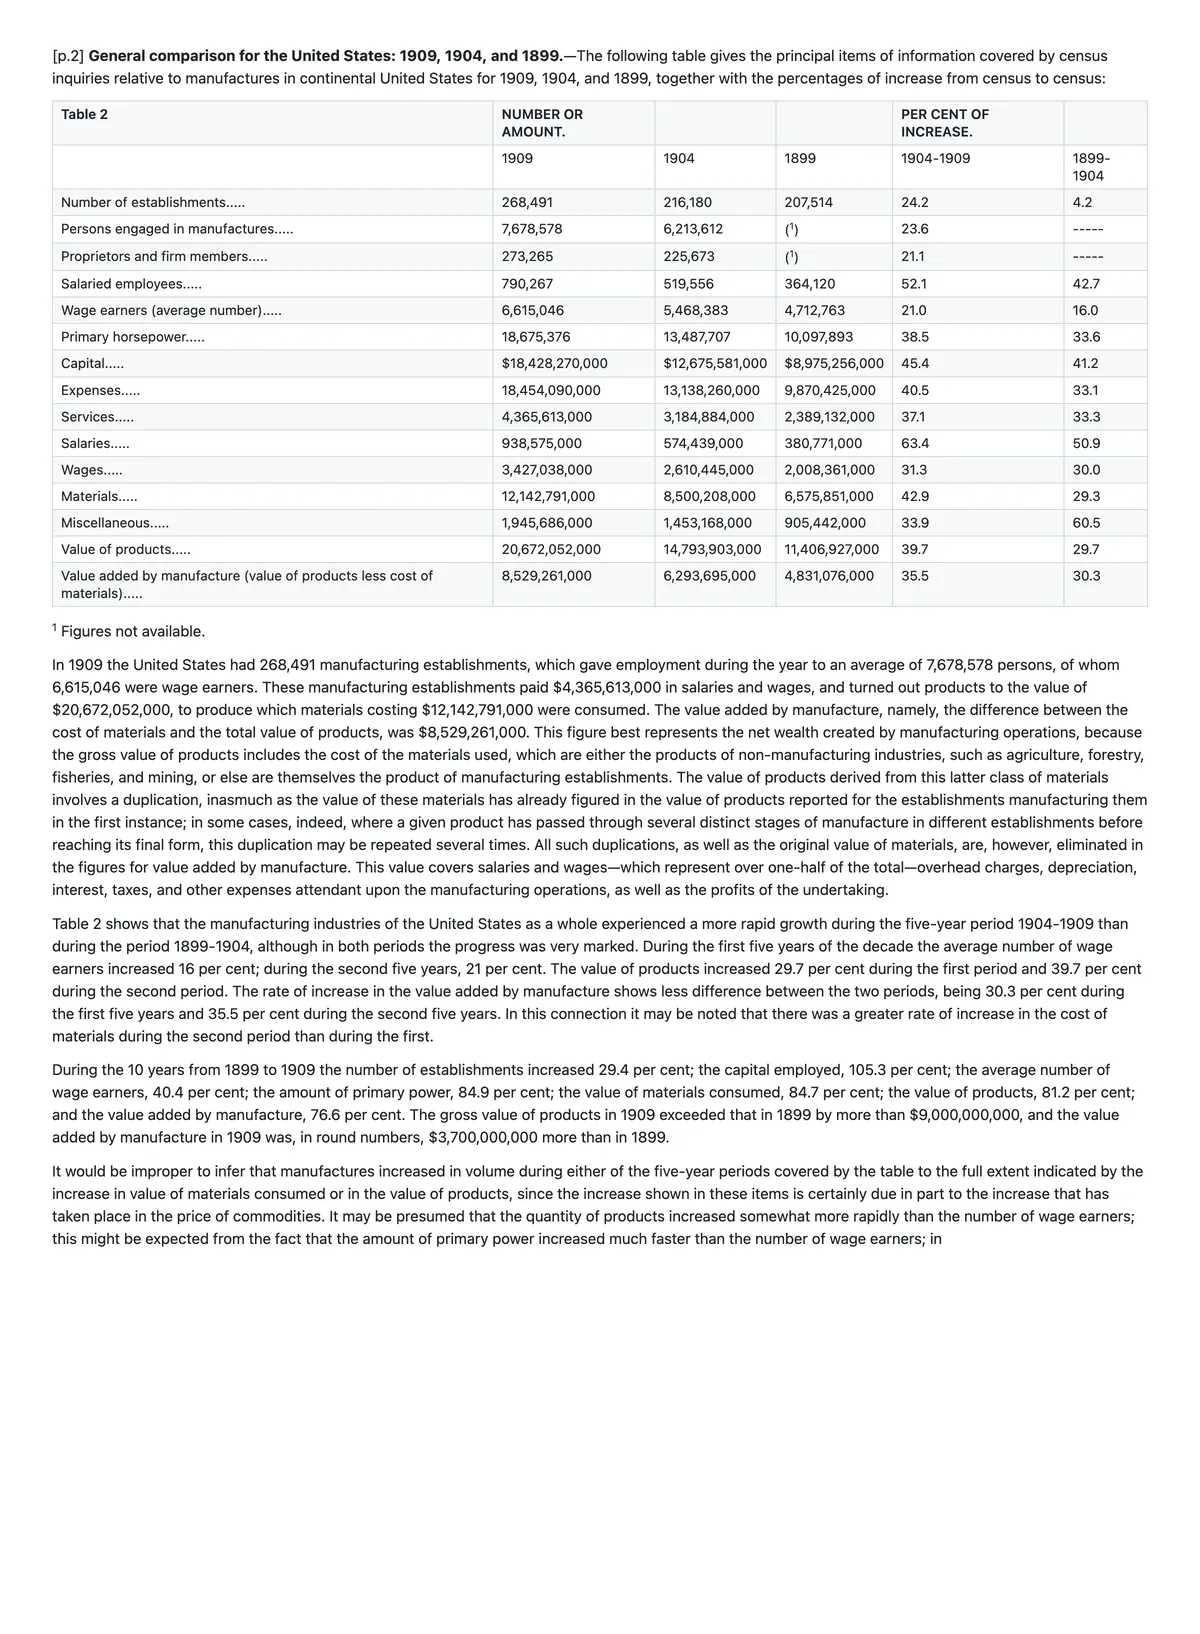 Página 438: uma tabela comparativa de 1899–1909 com cabeçalho em dois níveis (Número ou montante e Porcentagem de aumento, cada um dividido por ano) vira uma tabela editável com duas linhas de cabeçalho e números que correspondem ao original célula por célula; o marcador de nota (1) e a nota “Figures not available.” são mantidos.
Gerado pelo fluxo de extração do Geyi; cabeçalhos, números e notas de rodapé são conferidos com a digitalização antes da exibição. Extração em inglês, sem tradução. · Fonte: Décimo Terceiro Censo dos Estados Unidos, realizado em 1910: resumo do censo, Departamento do Censo dos Estados Unidos, 1913 (Obra do governo dos Estados Unidos: compilada pelo Departamento do Censo dos Estados Unidos e publicada pelo Government Printing Office em 1913, portanto não está protegida por direitos autorais nos termos do 17 U.S.C. §105; o item do Internet Archive (digitalizado pelas bibliotecas da Universidade da Califórnia) traz a marcação possible-copyright-status = NOT_IN_COPYRIGHT.)
Perguntas frequentes
O japonês vertical volta na ordem certa?
Sim. Japonês vertical, páginas duplas e outras ordens de leitura incomuns são corrigidos automaticamente e convertidos em saída horizontal, sem que você precise separar as páginas. Páginas com várias colunas voltam na ordem de leitura, em vez de um único bloco embaralhado.
Como é cobrado?
Por página: 4 créditos por página, e uma imagem avulsa conta como uma página.
Ela pode traduzir o que extrai?
Não nesta página. Quando precisar de uma tradução, leve o arquivo Word ou Markdown extraído para a tradução de arquivos e rode a tarefa lá.
Conteúdo relacionado
简体中文 · English · Français · Deutsch · Русский · 日本語 · 한국어 · العربية · 繁體中文 · Español
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.