Übersetzung gescannter Dokumente
In einem Scan ist Text kein Text, sondern ein Bild. Sie können ihn nicht markieren, und herkömmliche Übersetzungstools können ihn nicht lesen. Deshalb führt das Hochladen einer fotokopierten Datei in ein Übersetzungsfeld meist zu keinem Ergebnis.
Geyi erkennt diese Dateien vor der Übersetzung: Die Zeichen werden aus dem Bild gelesen, die Lesereihenfolge ermittelt, und das Ergebnis wird übersetzt und neu formatiert. Mehrspaltige Seiten werden spaltenweise korrekt wiedergegeben, anstatt durcheinander zu geraten, und vertikaler Text wird in horizontalen umgewandelt.
Welche Originale sind geeignet
- Gescannte Buchseiten und fotokopierte Archive — PDFs, die von einem Scanner oder Kopierer erstellt wurden.
- Fotos von Dokumenten — PNG, JPEG, WEBP, TIFF und ähnliche Bildformate.
- Bildbasierte PDFs — Dateien, bei denen in einem Reader kein Text markiert werden kann.
- Ältere Publikationen mit komplexem Layout — mehrere Spalten, vertikale Ausrichtung, Doppelseiten.
Wann ist die Erkennung am genauesten
Saubere, gerade gescannte Drucke liefern die höchste Genauigkeit. Unscharfe, schiefe oder ungleichmäßig beleuchtete Bilder sowie Seiten mit viel Handschrift sind deutlich schwieriger — überprüfen Sie bei solchen Dokumenten vor dem Export die wichtigsten Passagen anhand des Originals.
Vertikal gesetzter japanischer Text, Doppelseiten und andere ungewöhnliche Lesereihenfolgen werden automatisch korrigiert, ohne dass Sie Seiten selbst trennen oder neu anordnen müssen.
Wenn Sie nur den Originaltext benötigen
Wenn Sie nur den Text aus dem Scan benötigen, ohne Übersetzung, ist die Dokumentenextraktion besser geeignet: Sie kostet 4 Credits pro Seite und erstellt ein horizontales, bearbeitbares Word-, PDF-, TXT- oder Markdown-Dokument in der Originalsprache.
Zuerst eine Extraktion durchzuführen, um die Erkennungsqualität zu prüfen und dann zu entscheiden, ob übersetzt werden soll, ist zudem eine Möglichkeit, Credits zu sparen.
Beispiele
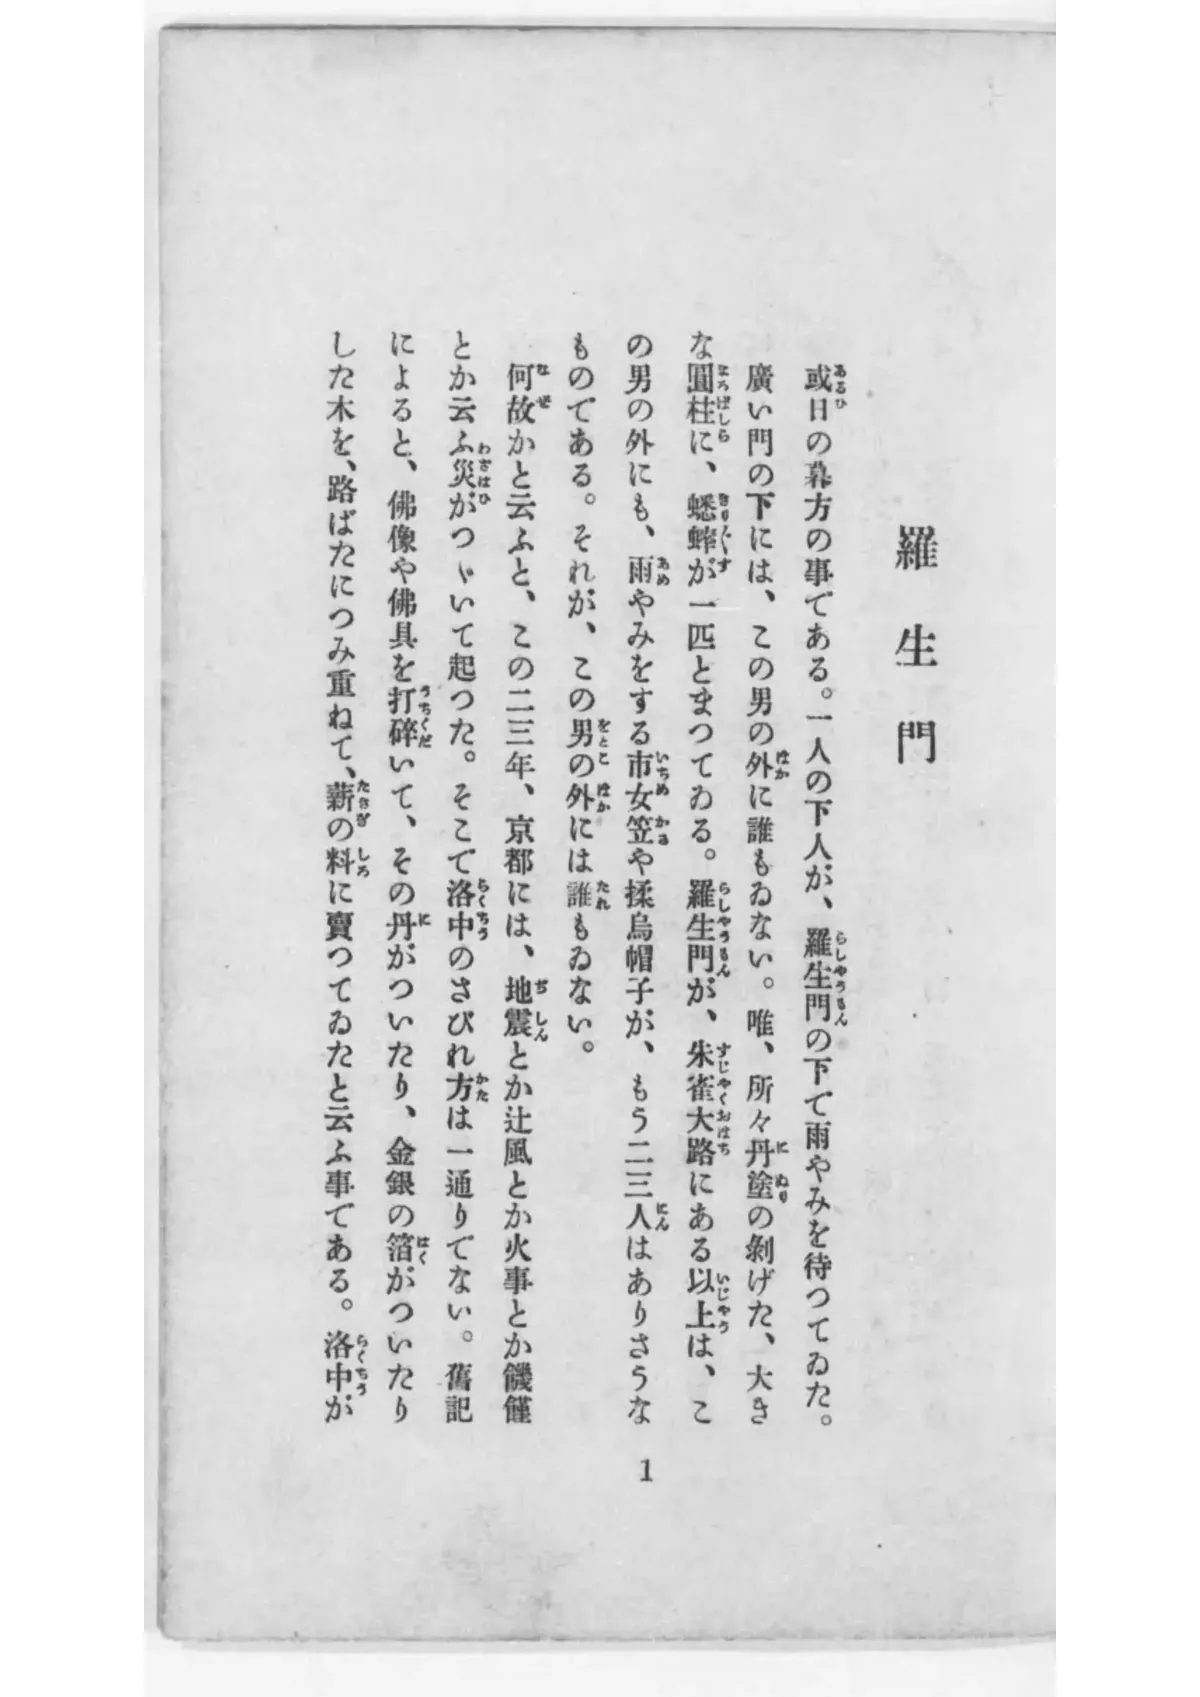
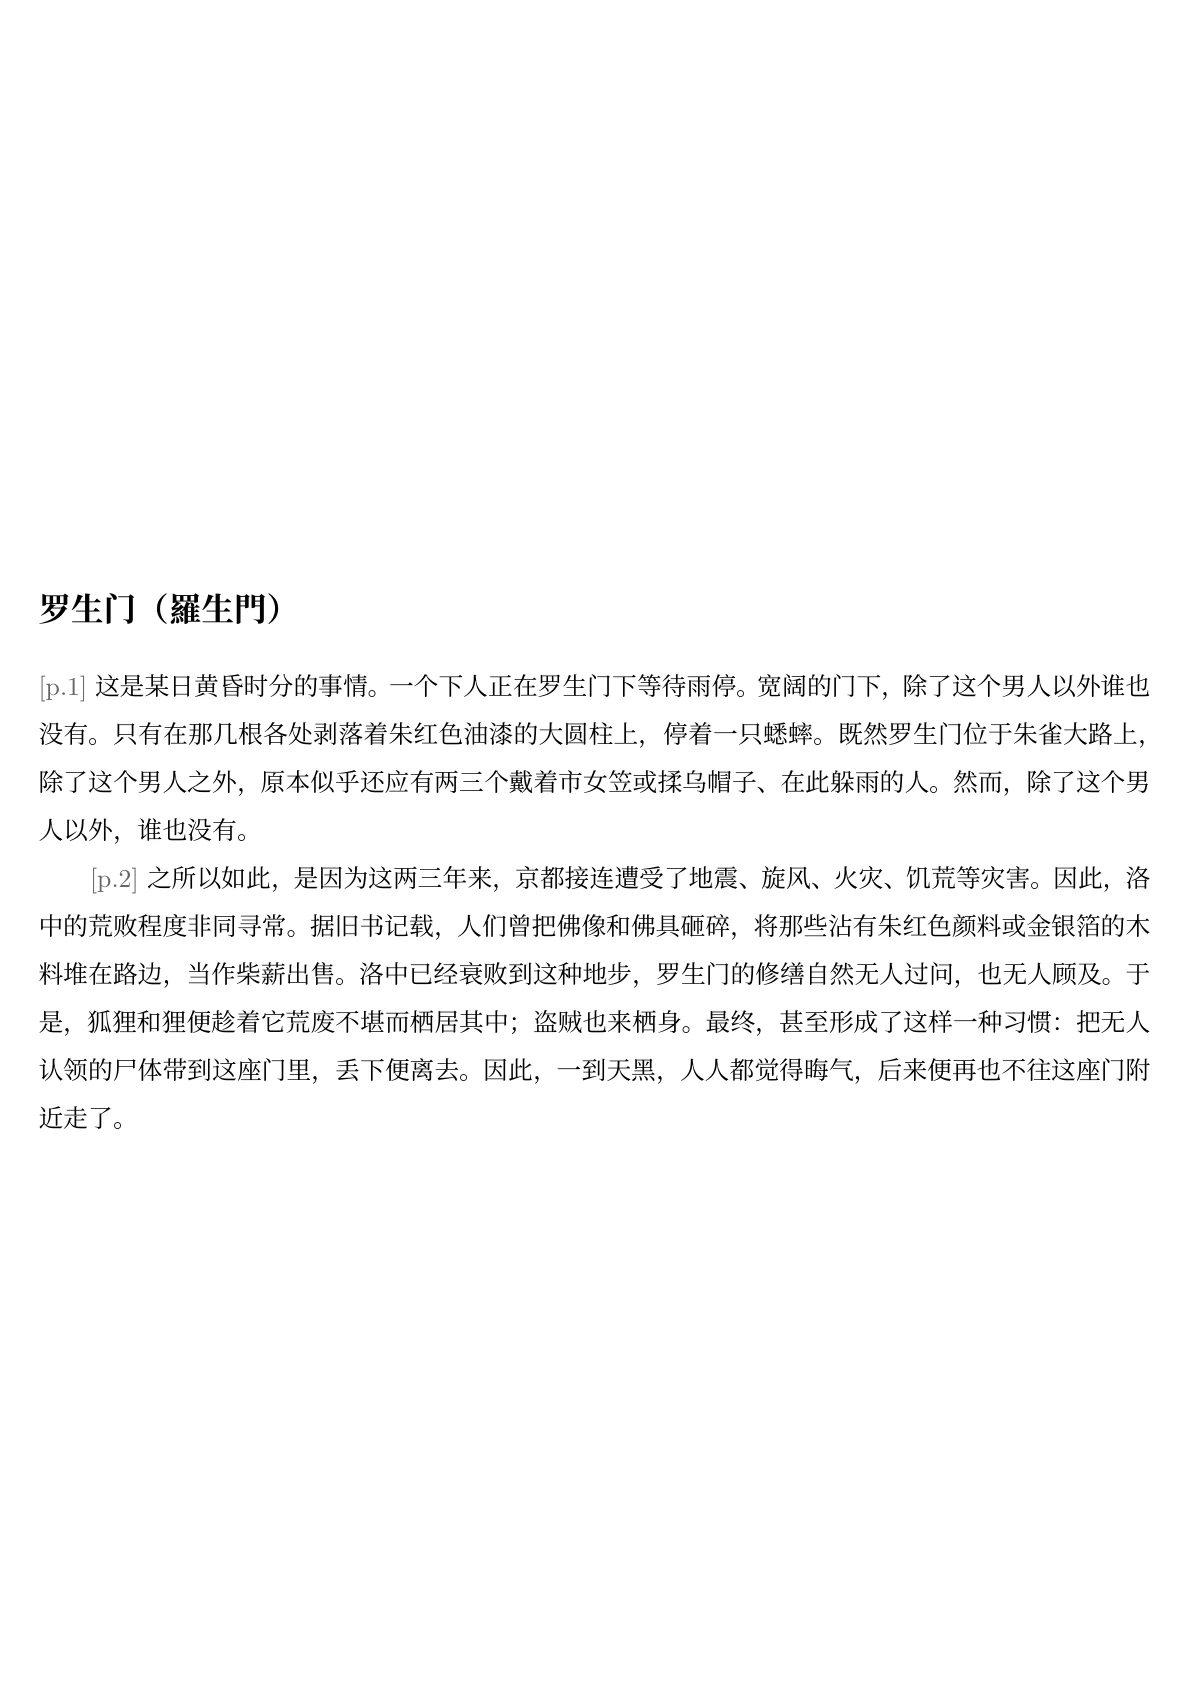
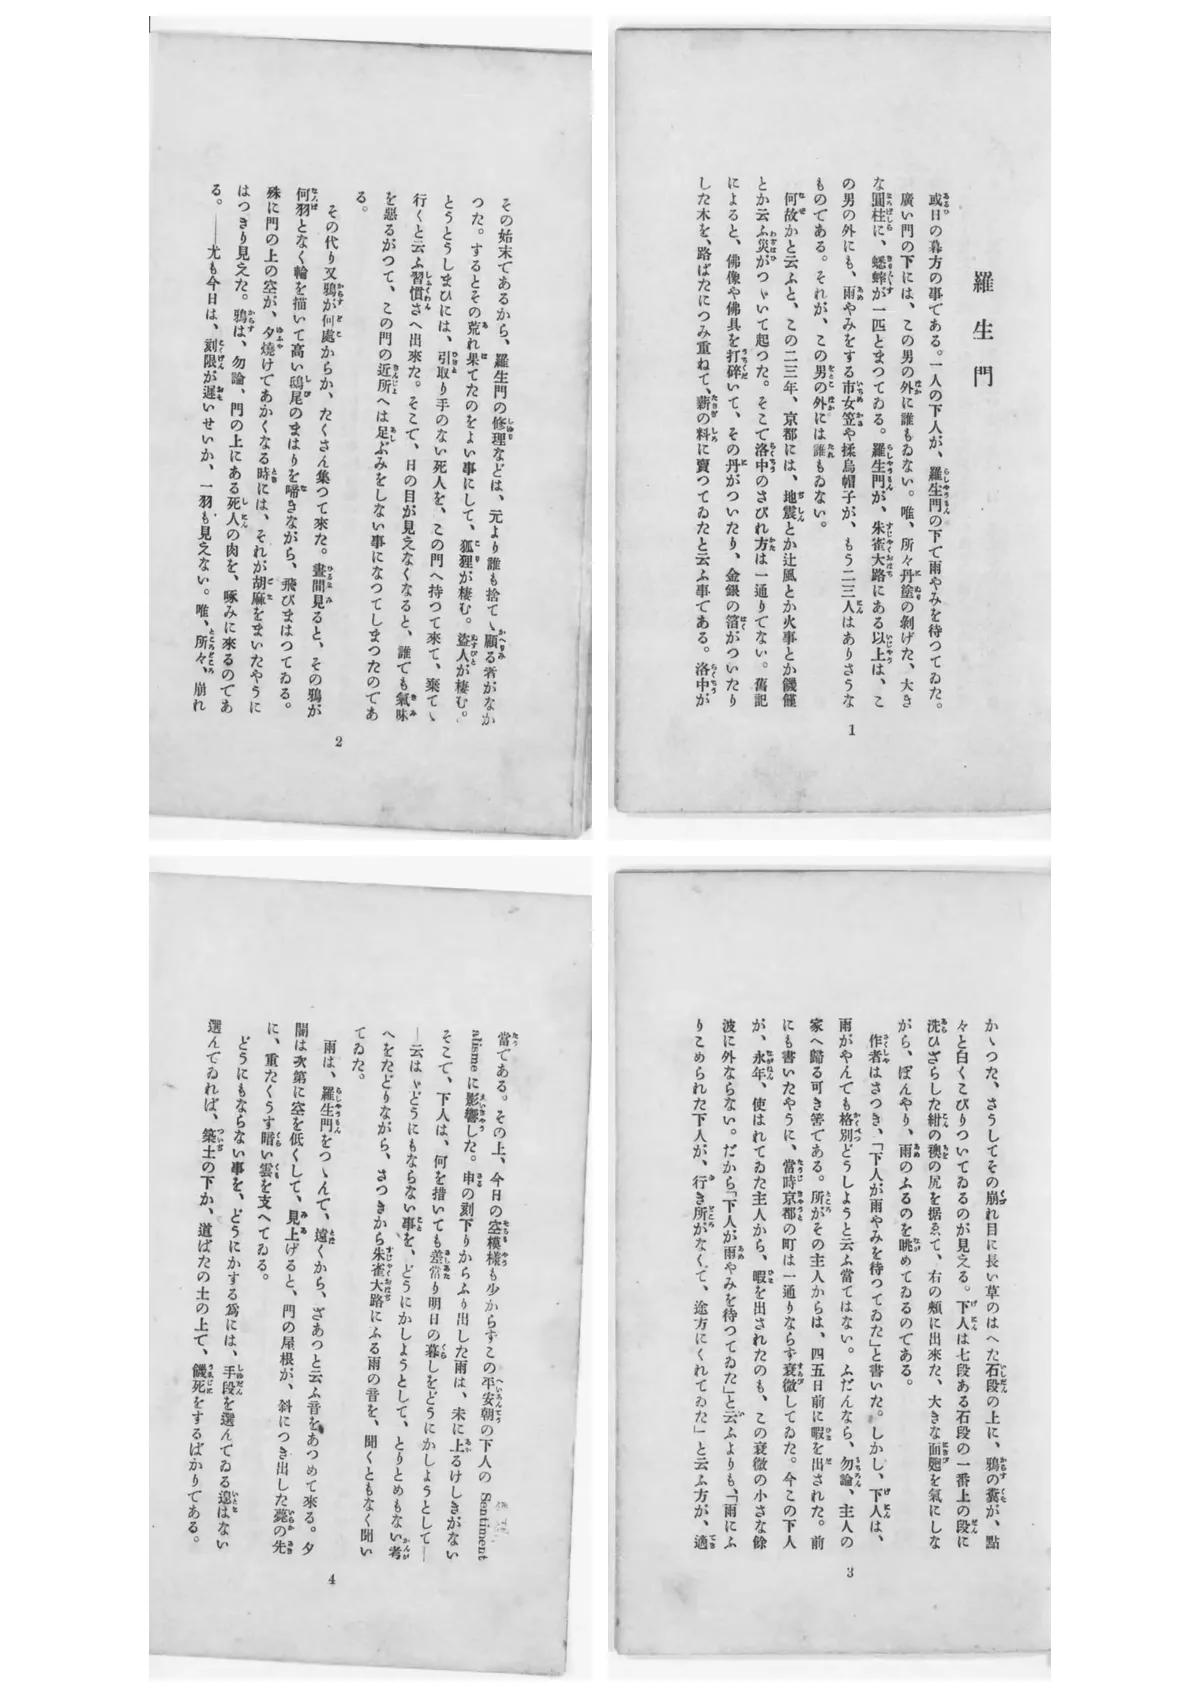
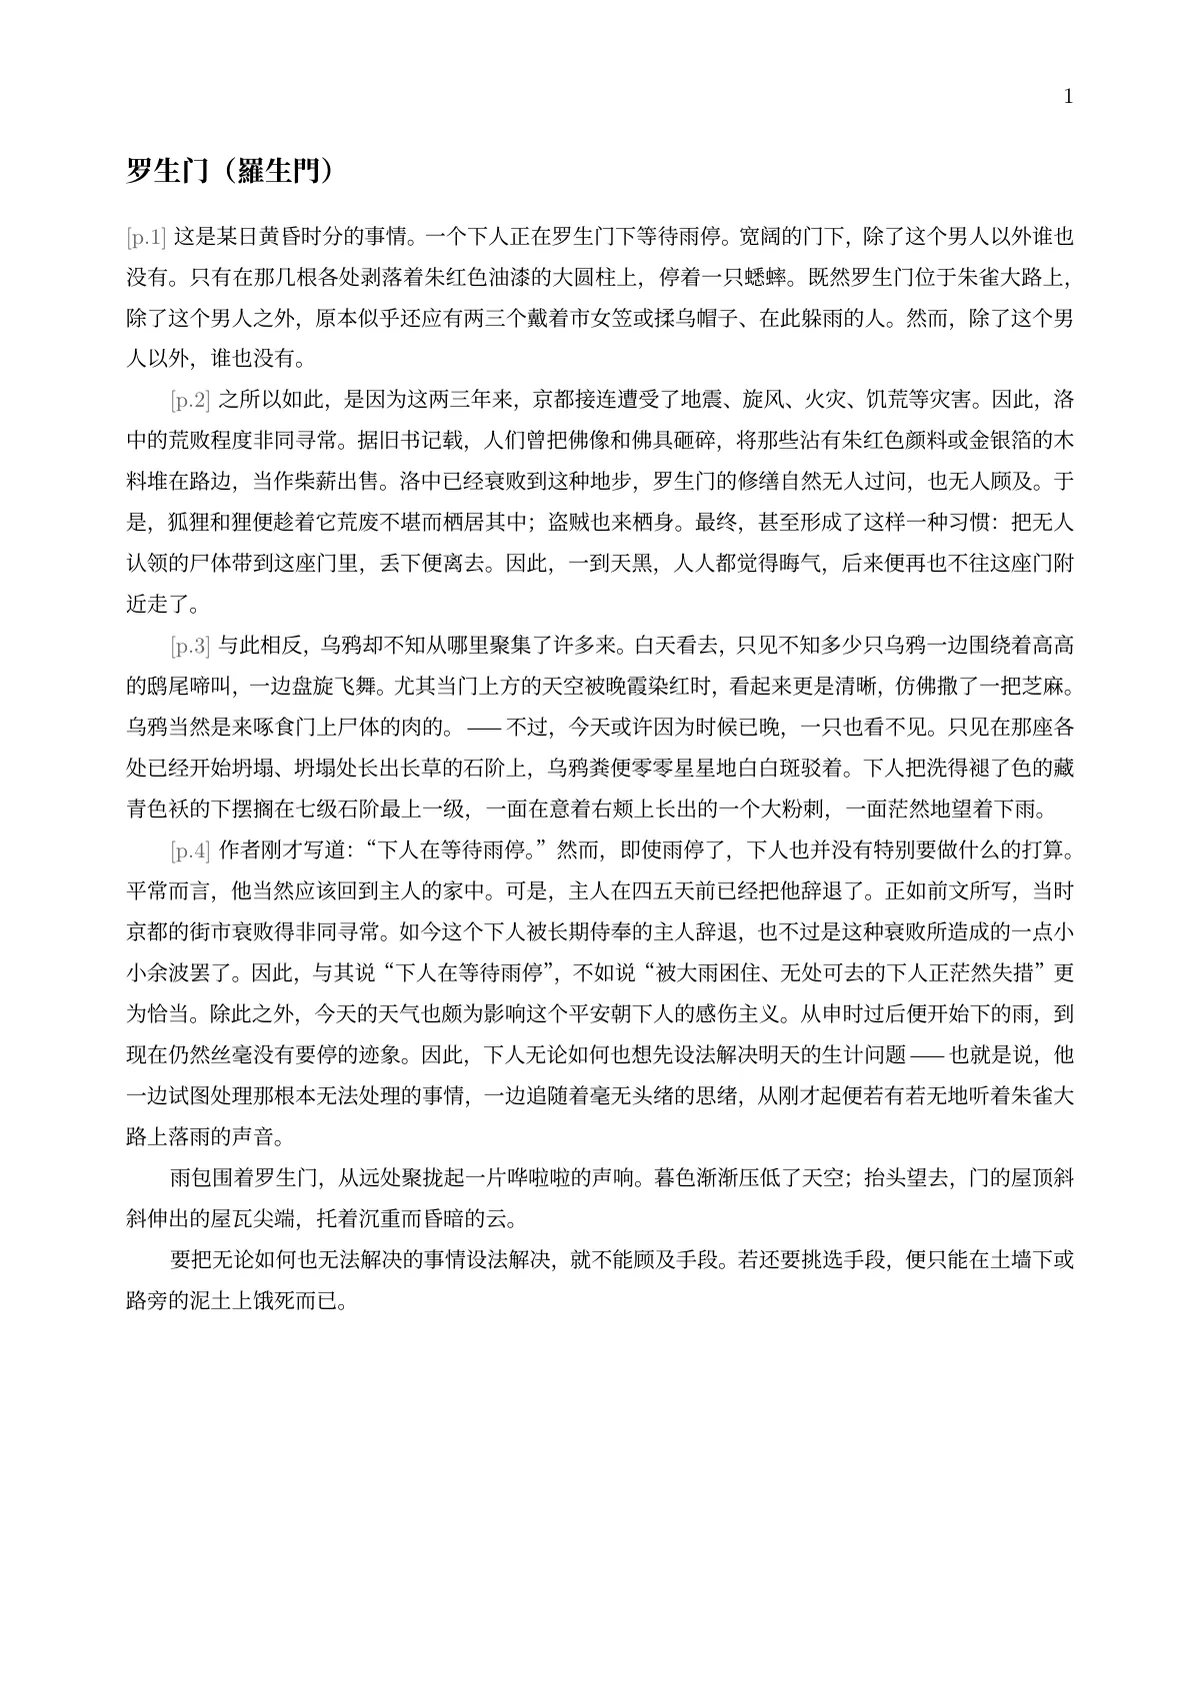
Vier gescannte Seiten mit vertikalem Japanisch aus der Erstausgabe von Rashōmon von 1917 (alte Kanji-Schreibweise, historisches Kana, Furigana) werden durch die Dateitranslation von Geyi im Modus „Dokumentlayout-Reflow“ hochpräzise in horizontales vereinfachtes Chinesisch umgewandelt: Die Leserichtung von rechts nach links bleibt erhalten, Furigana werden nicht in den Text übernommen, Fachbegriffe wie Suzaku-Allee, ichime-gasa und momi-eboshi bleiben bestehen und der gesamte Fließtext auf den 4 Seiten wird übersetzt.
Vorher
或日の暮方の事である。一人の下人が、羅生門の下で雨やみを待つてゐた。廣い門の下には、この男の外に誰もゐない。唯、所々丹塗の剝げた、大きな圓柱に、蟋蟀が一匹とまつてゐる。羅生門が、朱雀大路にある以上は、この男の外にも、雨やみをする市女笠や揉烏帽子が、もう二三人はありさうなものである。それが、この男の外には誰もゐない。
Nachher
这是某日黄昏时分的事情。一个下人正在罗生门下等待雨停。宽阔的门下,除了这个男人以外谁也没有。只有在那几根各处剥落着朱红色油漆的大圆柱上,停着一只蟋蟀。既然罗生门位于朱雀大路上,除了这个男人之外,原本似乎还应有两三个戴着市女笠或揉乌帽子、在此躲雨的人。然而,除了这个男人以外,谁也没有。
Tatsächliches Produktionsergebnis; 3 Stellen wurden vor der Anzeige manuell korrigiert. · Quelle: Rashōmon, Ryūnosuke Akutagawa, 1917 (Der Autor Ryūnosuke Akutagawa verstarb 1927, also vor mehr als 70 Jahren. Nach japanischem Urheberrecht waren Werke von Autoren, die vor Ende 1967 verstarben, 50 Jahre nach ihrem Tod geschützt, sodass der Schutz dieses Buches Ende 1977 auslief. Die National Diet Library Digital Collections kennzeichnet das Werk als PDM (Public Domain Mark) und veröffentlicht es online (DOI 10.11501/1088339).)
Häufige Fragen
Was kostet die Übersetzung eines Scans?
Scans durchlaufen den Erkennungspfad des KI-Reflows: 8 Credits pro Seite bei hoher Präzision, 4 bei Standard, mit einem Minimum von 10 Credits pro Datei. Ein einzelnes Bild zählt als eine Seite.
Warum ist es teurer als ein normales PDF?
Ein Scan muss erkannt werden, bevor er übersetzt werden kann. Dieser Schritt erfordert deutlich mehr Rechenleistung als das Lesen einer vorhandenen Textebene. Digitale PDFs im Modus zur Beibehaltung des Layouts kosten 4 Credits pro Seite.
Werden mehrspaltige Layouts durcheinandergebracht?
Nein. Mehrspaltige Seiten werden in der korrekten Lesereihenfolge wiederhergestellt, anstatt einfach von links nach rechts in einen Block zusammengefasst zu werden.
Kann Handschrift erkannt werden?
Gedruckter Text wird weitaus zuverlässiger erkannt als Handschrift. Wenn ein Dokument größtenteils handschriftlich verfasst ist, müssen die Ergebnisse überprüft werden — führen Sie zuerst eine Dokumentenextraktion durch, um die Erkennungsqualität zu beurteilen.
In welchem Format liegt die fertige Übersetzung vor?
Scans durchlaufen den KI-Reflow, sodass Sie Word-, PDF-, Markdown- oder EPUB-Dateien exportieren können. Beachten Sie, dass die Übersetzung nicht wieder auf das Originalbild projiziert wird, sondern als bearbeitbares Dokument formatiert wird.
Kostet ein einzelnes Bild wirklich 10 Credits?
Ja — jede Datei kostet mindestens 10 Credits, und ein Bild zählt als eine Seite. Wenn Sie mehrere Bilder vor dem Hochladen zu einem PDF zusammenfügen, wird die Gesamtzahl der Seiten berechnet, was kostengünstiger ist.
Verwandte Inhalte
- PDF-Übersetzung
- Übersetzung von Bildtext
- Dokumentenextraktion
- Vertikales Japanisch und klassische Layouts
- Erkunden Sie ein Beispiel, bevor Sie Ihr eigenes Dokument verwenden
简体中文 · English · Français · Русский · 日本語 · 한국어
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.