スキャン済みドキュメントの翻訳
スキャンされた文書内のテキストは、テキストではなく「画像」として扱われます。選択することができず、通常の翻訳ツールでは読み取ることができません。そのため、コピーしたアーカイブを翻訳ボックスにドラッグ&ドロップしても、通常は何も結果が得られません。
Geyiは、翻訳前にこれらのファイルを認識します。画像から文字を読み取り、読み取り順序を解析してから翻訳し、結果を再レイアウトします。複数列のページは、順序がバラバラになることなく列ごとに復元され、縦書きのテキストは横書きに変換されます。
対象となるオリジナルファイル
- スキャンされた書籍のページやコピーされたアーカイブ — スキャナーやコピー機で作成されたPDF。
- 文書の撮影画像 — PNG、JPEG、WEBP、TIFFなどの画像形式。
- 画像のみのPDF — リーダーでテキストを選択できないタイプのもの。
- 複雑なレイアウトの古い出版物 — 複数列、縦書き、見開きページなど。
認識精度が高くなる条件
真っ直ぐにスキャンされた鮮明な印刷物は、最も高い精度が得られます。ぼやけていたり、傾いていたり、照明が不均一な画像、手書き文字が多いページは、認識が著しく困難になります。その場合は、エクスポートする前に重要な箇所を原文と照らし合わせて確認してください。
縦書きの日本語、見開きページ、その他の特殊な読み取り順序は自動的に修正されるため、自分でページを分割したり順序を入れ替えたりする必要はありません。
原文のテキストのみが必要な場合
翻訳は不要で、スキャンからテキストを抽出するだけでよい場合は、「ドキュメント抽出」が適しています。1ページあたり4クレジットで、原文の言語のまま、編集可能なWord、PDF、TXT、またはMarkdown形式で出力されます。
最初に抽出を行って認識品質を確認してから翻訳するかどうかを決定することも、クレジットを節約する方法の一つです。
処理結果の例
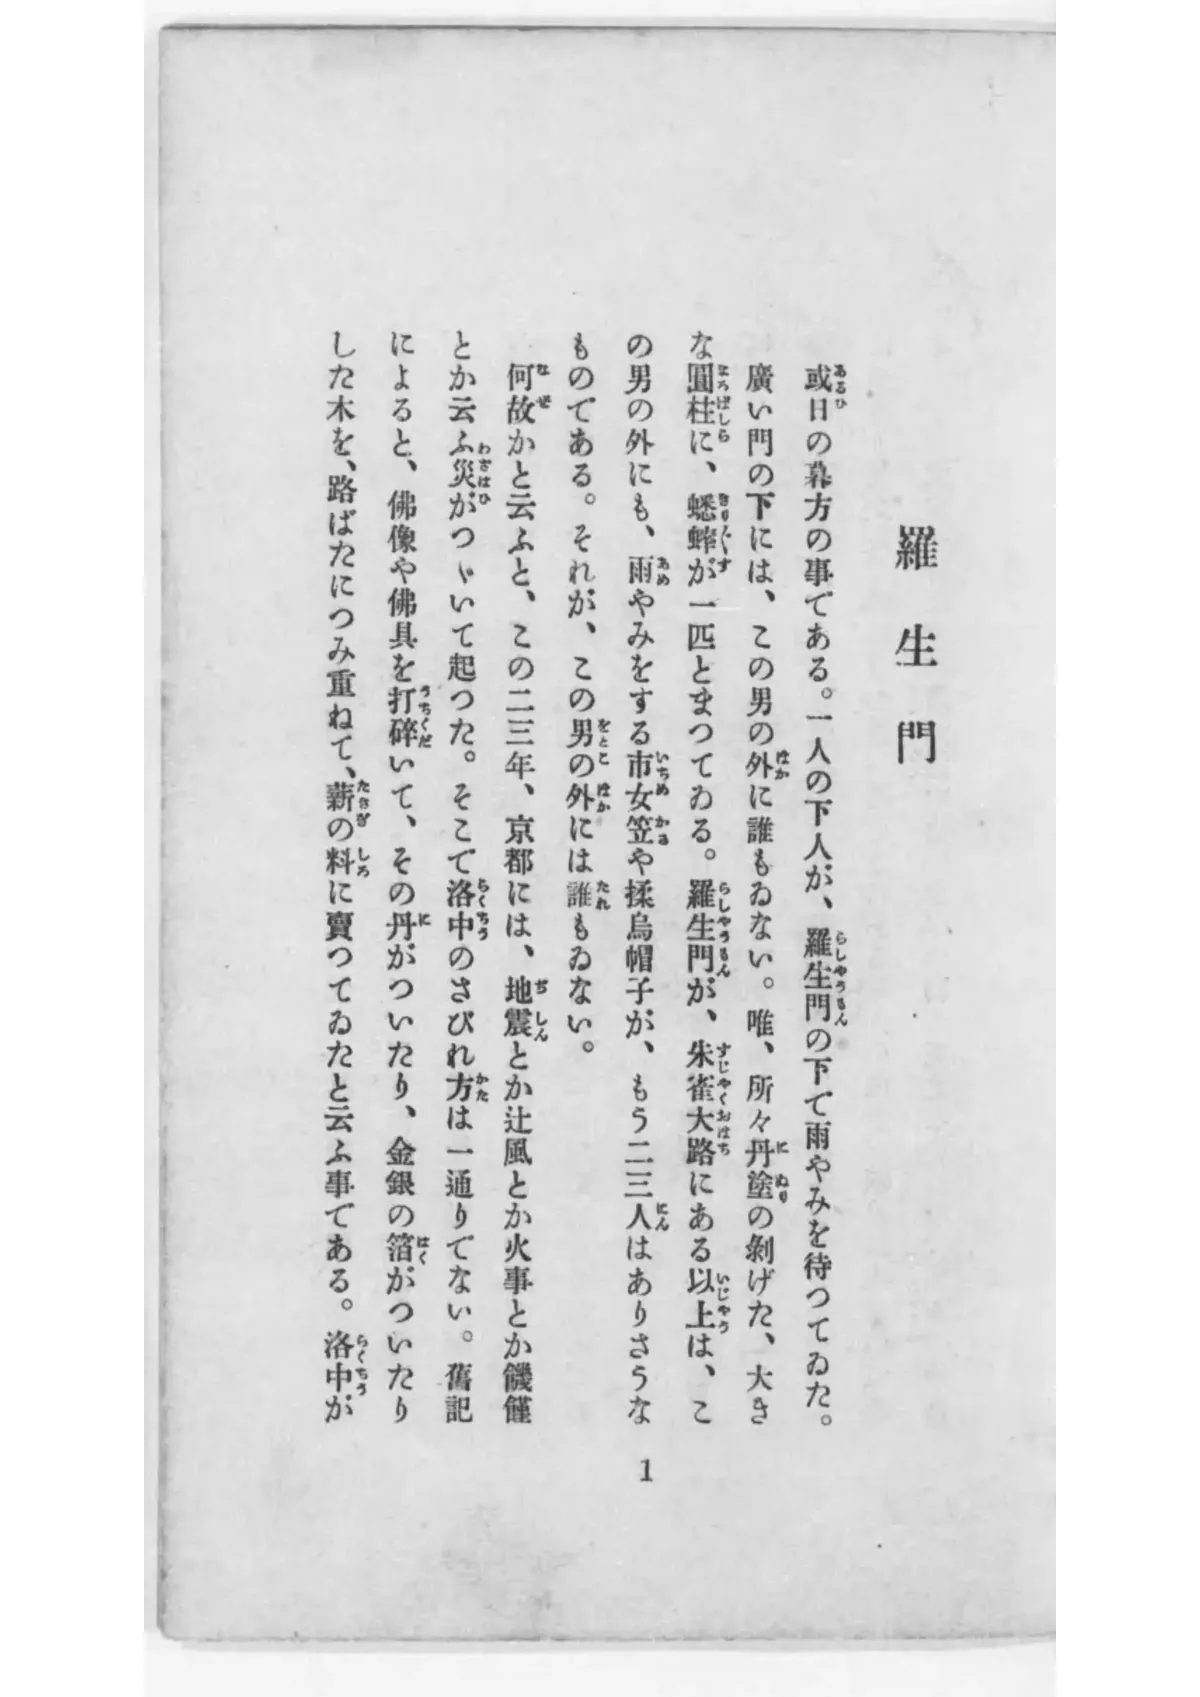
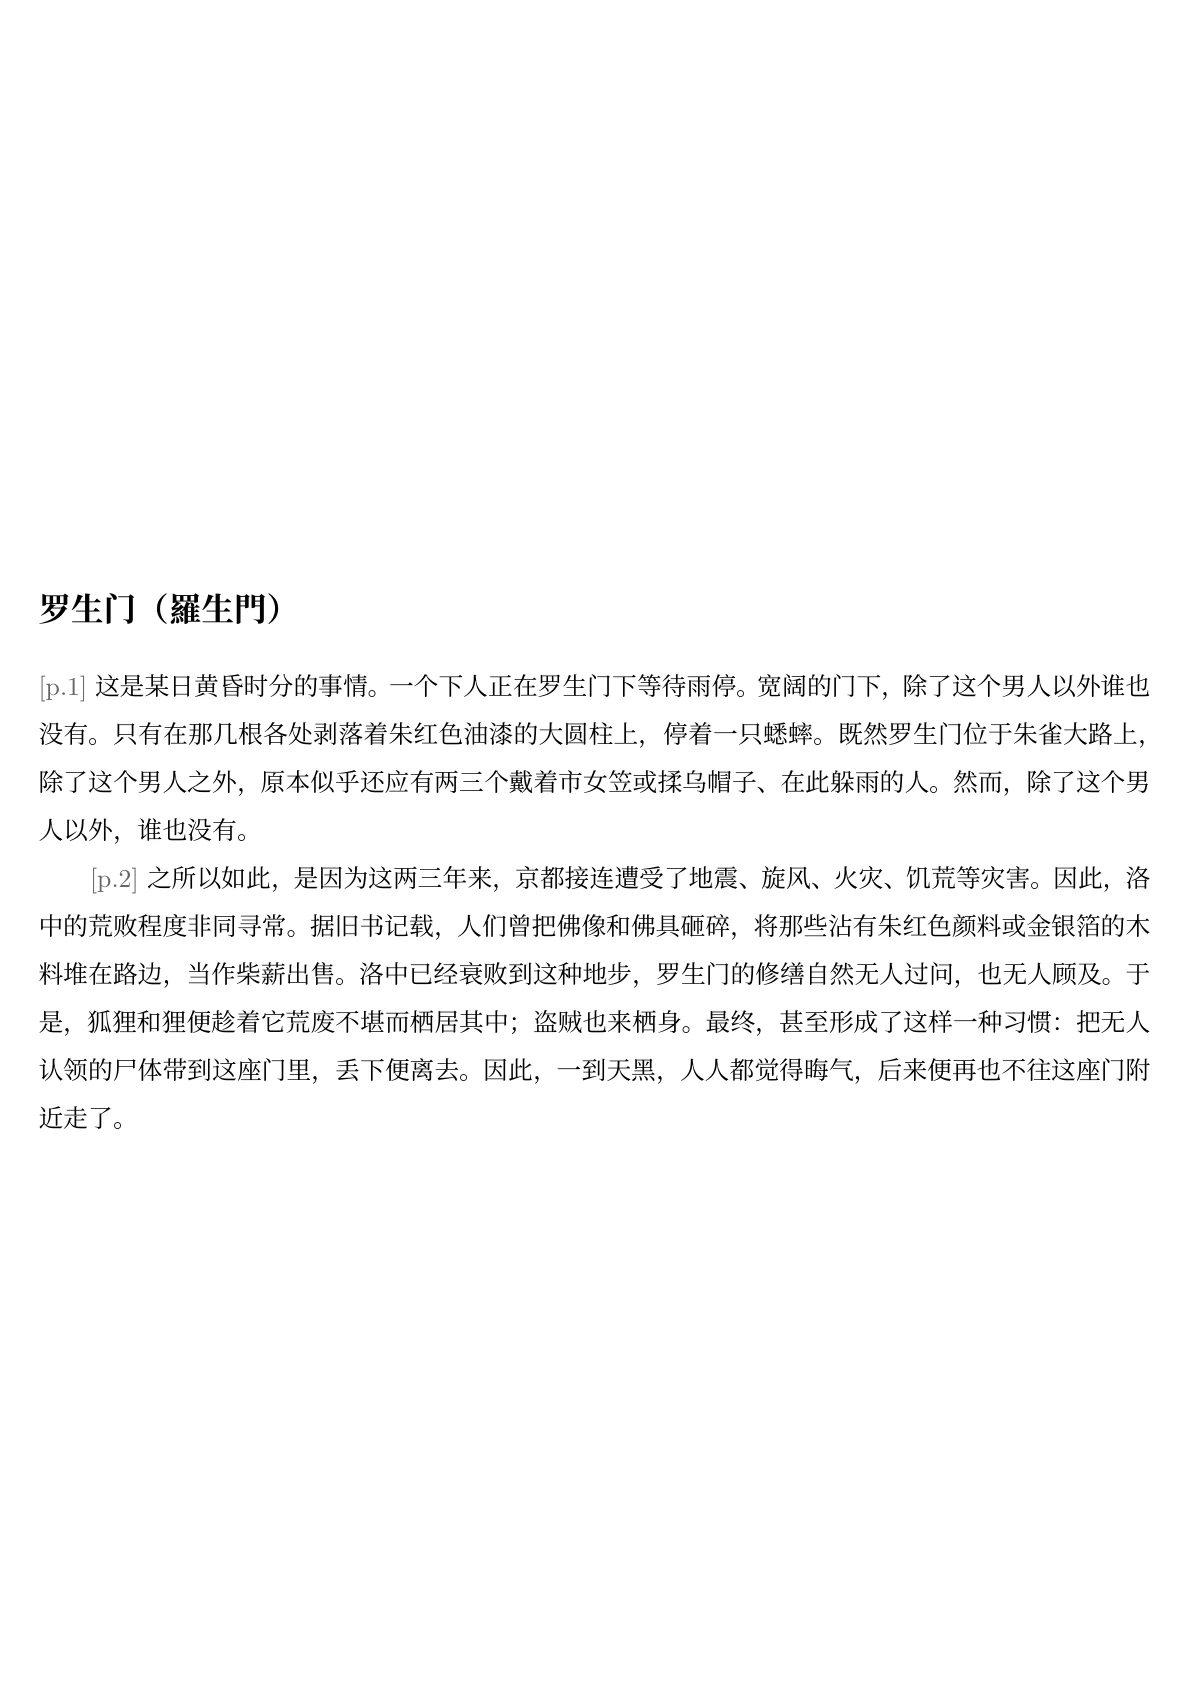
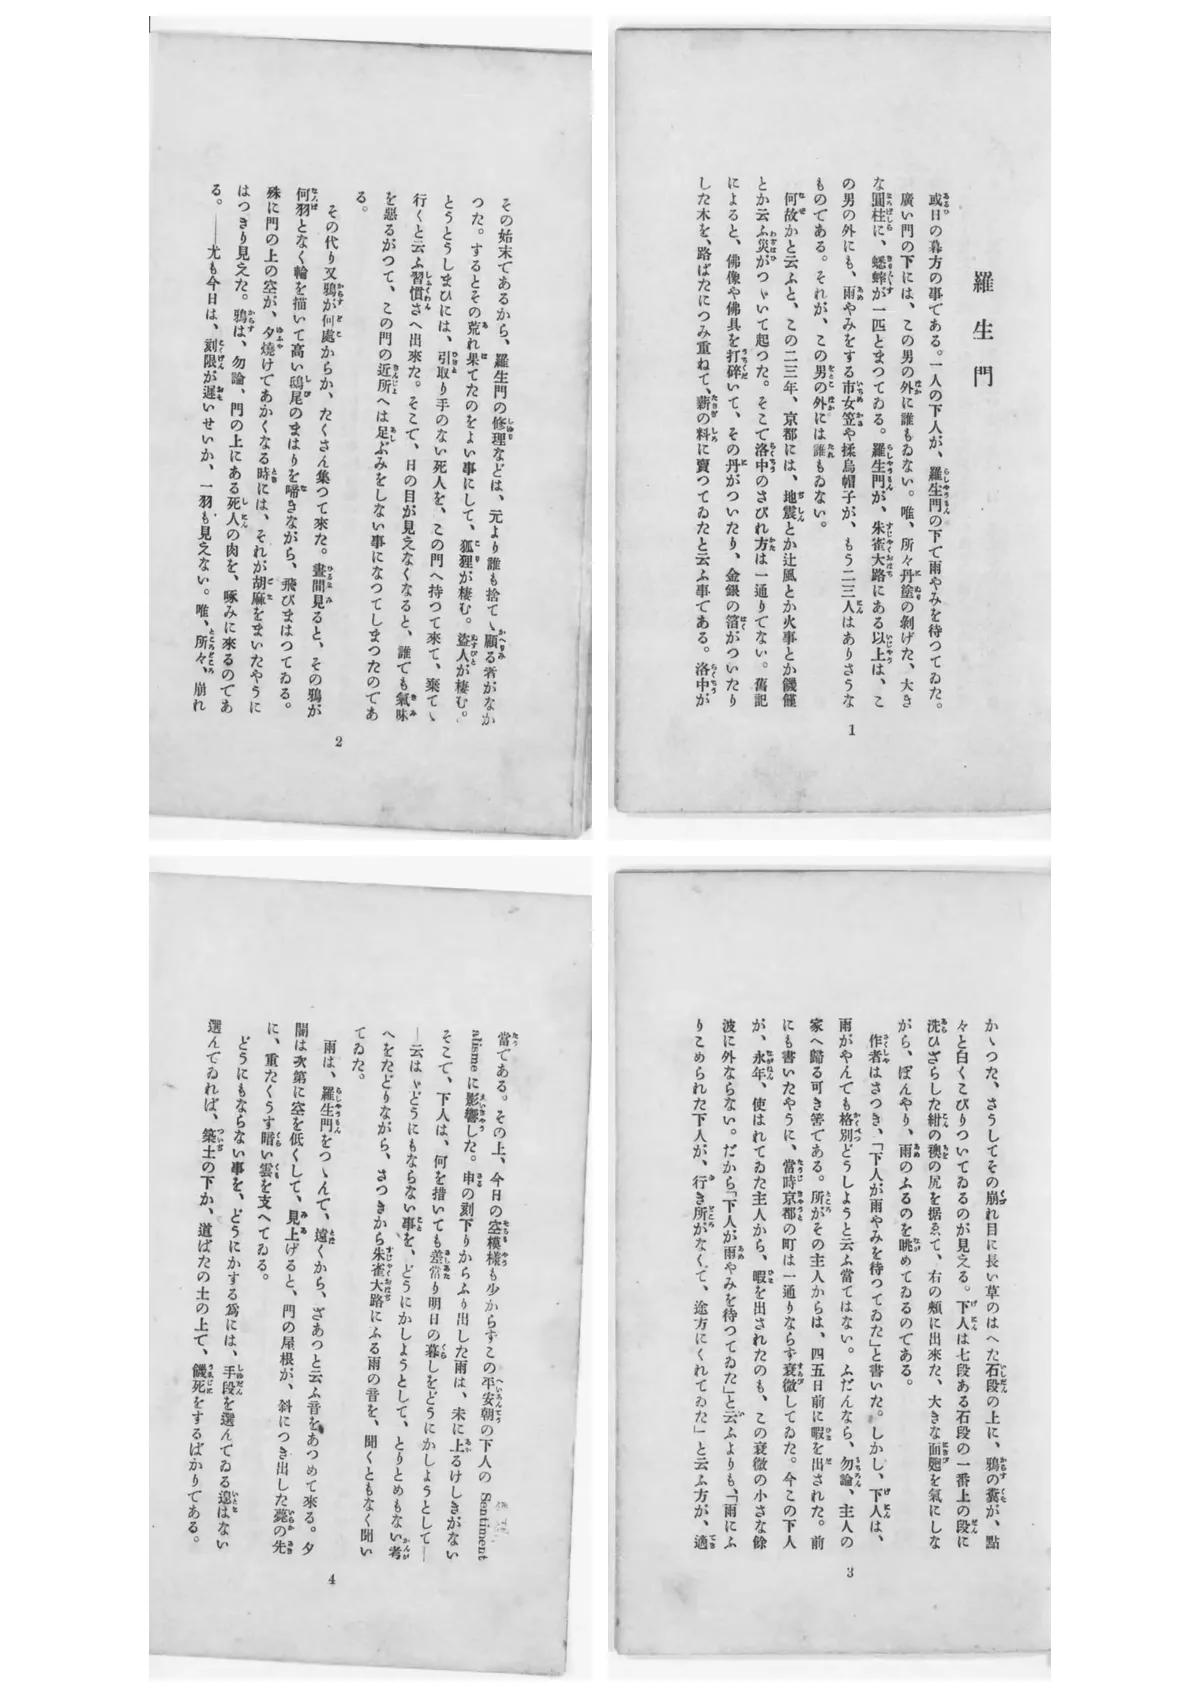
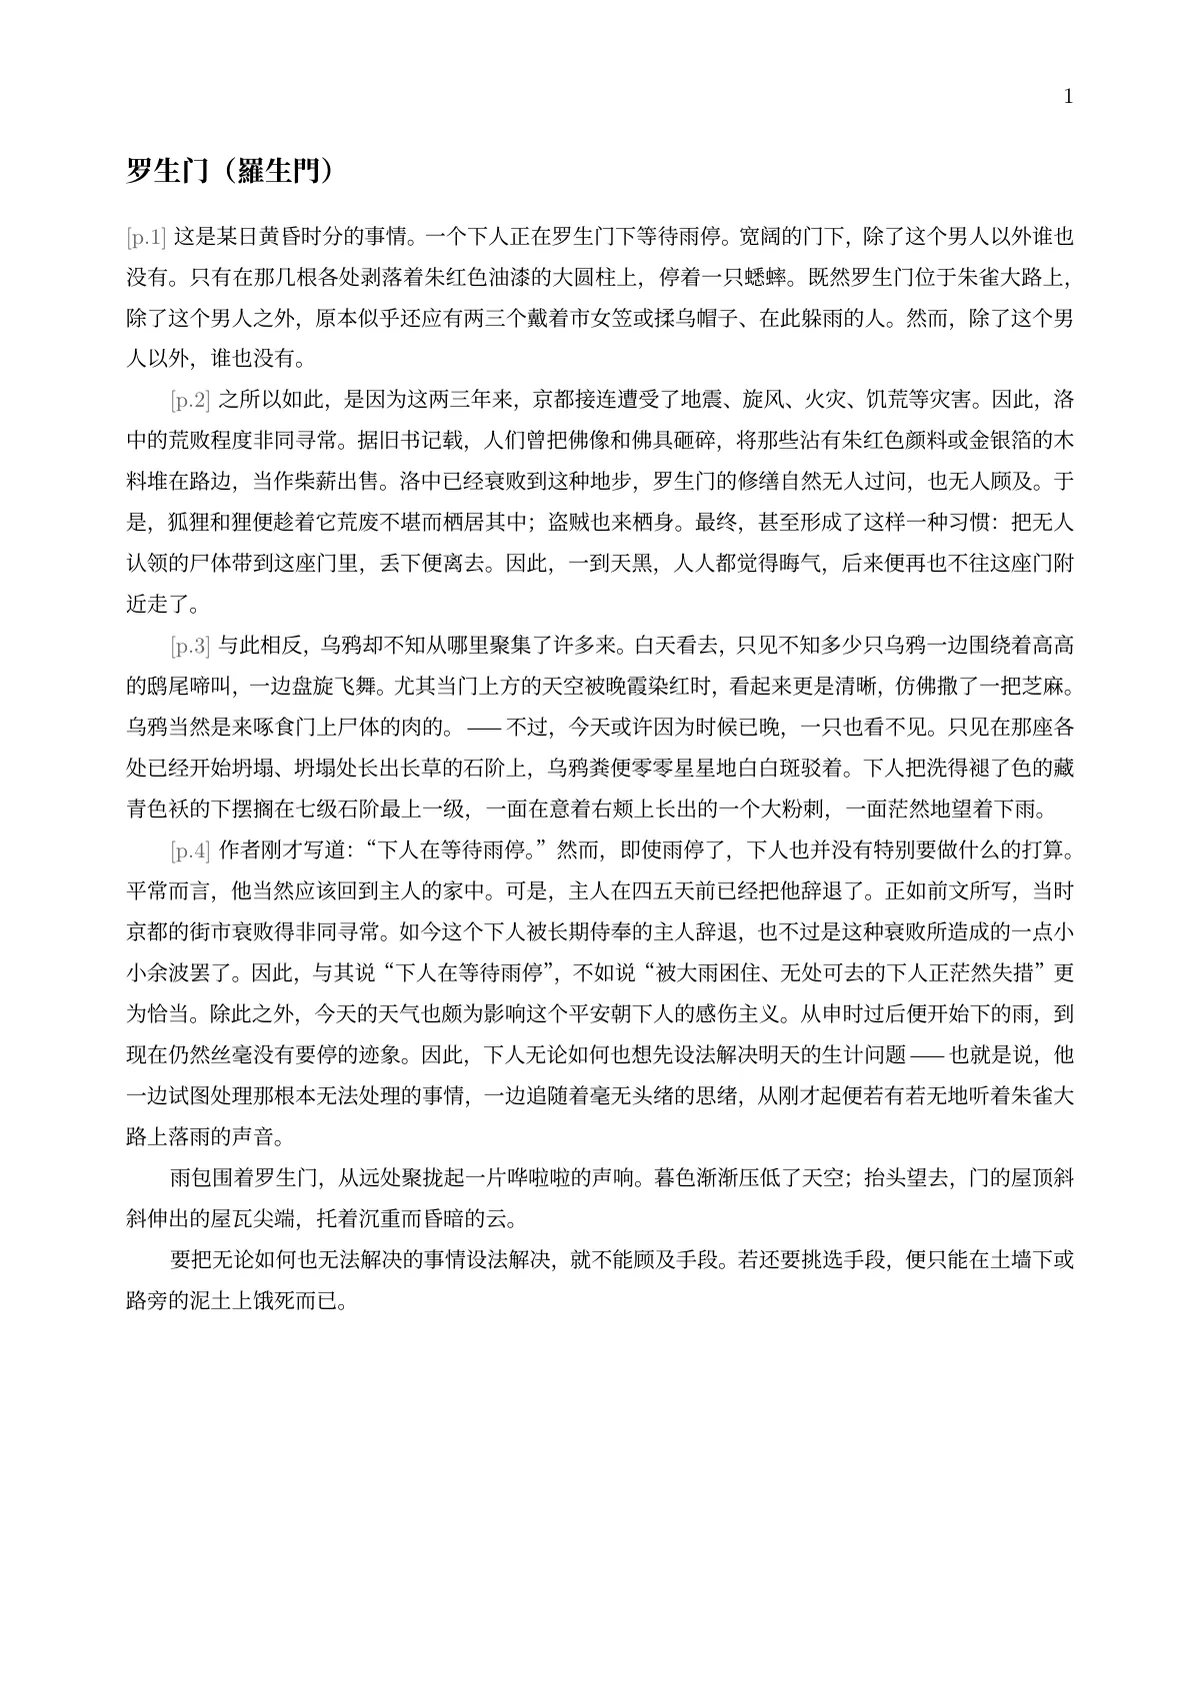
1917年版『羅生門』(旧字体、歴史的仮名遣い、ルビ付き)の縦書きスキャン4ページ分を、Geyiのファイル翻訳機能(リフローモード)で高精度に横書きの簡体字中国語へ変換しました。右から左への読み順を維持し、ルビを本文から除外。朱雀大路、一女笠、揉烏帽子といった時代用語もそのまま保持し、4ページ分の本文すべてを翻訳しています。
処理前
或日の暮方の事である。一人の下人が、羅生門の下で雨やみを待つてゐた。廣い門の下には、この男の外に誰もゐない。唯、所々丹塗の剝げた、大きな圓柱に、蟋蟀が一匹とまつてゐる。羅生門が、朱雀大路にある以上は、この男の外にも、雨やみをする市女笠や揉烏帽子が、もう二三人はありさうなものである。それが、この男の外には誰もゐない。
処理後
这是某日黄昏时分的事情。一个下人正在罗生门下等待雨停。宽阔的门下,除了这个男人以外谁也没有。只有在那几根各处剥落着朱红色油漆的大圆柱上,停着一只蟋蟀。既然罗生门位于朱雀大路上,除了这个男人之外,原本似乎还应有两三个戴着市女笠或揉乌帽子、在此躲雨的人。然而,除了这个男人以外,谁也没有。
実際の生成出力。表示前に3箇所を手動修正しています。 · 出典:羅生門, 芥川龍之介, 1917 (著者の芥川龍之介は1927年に没しており、70年以上が経過しています。日本の著作権法では、1967年末までに没した著者の著作物は死後50年で保護期間が満了するため、本書の保護期間は1977年末に終了しています。国立国会図書館デジタルコレクションでは、本資料はPDM(パブリックドメインマーク)として公開されています(DOI 10.11501/1088339)。)
よくある質問
スキャン翻訳の料金はいくらですか?
スキャンはAIによるドキュメントレイアウト復元と同じ認識パスを通ります。高精度モードは1ページあたり8クレジット、標準モードは4クレジットで、ファイルごとに10クレジットの最低料金が適用されます。画像1枚は1ページとしてカウントされます。
なぜ通常のPDFより高いのですか?
スキャンは翻訳前に認識処理が必要であり、そのステップは既存のテキストレイヤーを読み取るよりも大幅に多くの計算リソースを消費するためです。レイアウトを保持するモードのデジタルPDFは1ページあたり4クレジットです。
複数列のレイアウトはバラバラになりませんか?
いいえ。複数列のページは、左から右へ一つのブロックにまとめられるのではなく、読み取り順序に従って復元されます。
手書き文字は認識できますか?
印刷されたテキストは、手書き文字よりもはるかに高い精度で認識されます。文書の大部分が手書きである場合、結果を確認する必要があります。まずドキュメント抽出を実行して、認識品質を確認してください。
翻訳後の形式は何ですか?
スキャンはAIによるドキュメントレイアウト復元を通るため、Word、PDF、Markdown、またはEPUB形式でエクスポートできます。翻訳結果は元の画像の上に重ね書きされるのではなく、編集可能なドキュメントとしてレイアウトされることに注意してください。
画像1枚でも本当に10クレジットかかりますか?
はい。すべてのファイルには最低10クレジットが請求され、画像1枚は1ページとしてカウントされます。アップロード前に複数の画像を1つのPDFに結合すると、合計ページ数に基づいて請求されるため、より安価になります。
関連コンテンツ
简体中文 · English · Français · Deutsch · Русский · 한국어
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.