掃描文件翻譯
在掃描檔中,文字並非文字,而是圖片。您無法選取它,一般的翻譯工具也無法讀取,這就是為什麼將影印的檔案丟進翻譯框通常什麼結果都沒有的原因。
格譯 Geyi 會在翻譯前辨識這些檔案:它從圖片中讀取字元,計算閱讀順序,然後進行翻譯並重新排版。多欄頁面會按欄位順序呈現,不會亂碼,垂直文字也會轉換為水平。
哪些原始檔案適合這裡
- 掃描的書籍頁面與影印檔案——由掃描器或影印機產生的 PDF。
- 文件照片——PNG、JPEG、WEBP、TIFF 及類似的圖片格式。
- 純圖片 PDF——即在閱讀器中無法選取文字的檔案。
- 具有複雜排版的舊出版品——多欄、垂直排版、跨頁。
何時辨識最準確
直接掃描清晰的印刷品可獲得最高準確度。模糊、歪斜、光線不均的圖片,以及包含大量手寫內容的頁面,難度會顯著增加——對於這些情況,請在匯出前對照原文檢查關鍵段落。
垂直日文、跨頁及其他不尋常的閱讀順序會自動修正,無需您自行拆分頁面或重新排序。
當您只需要原始文字時
如果您只需要掃描檔中的文字而不需要翻譯,使用「文件提取」會更合適:每頁收費 4 點數,並產生橫向、可編輯的 Word、PDF、TXT 或 Markdown 格式,語言與原文相同。
先進行提取以檢查識別品質,再決定是否翻譯,也是一種節省點數的方法。
實際效果
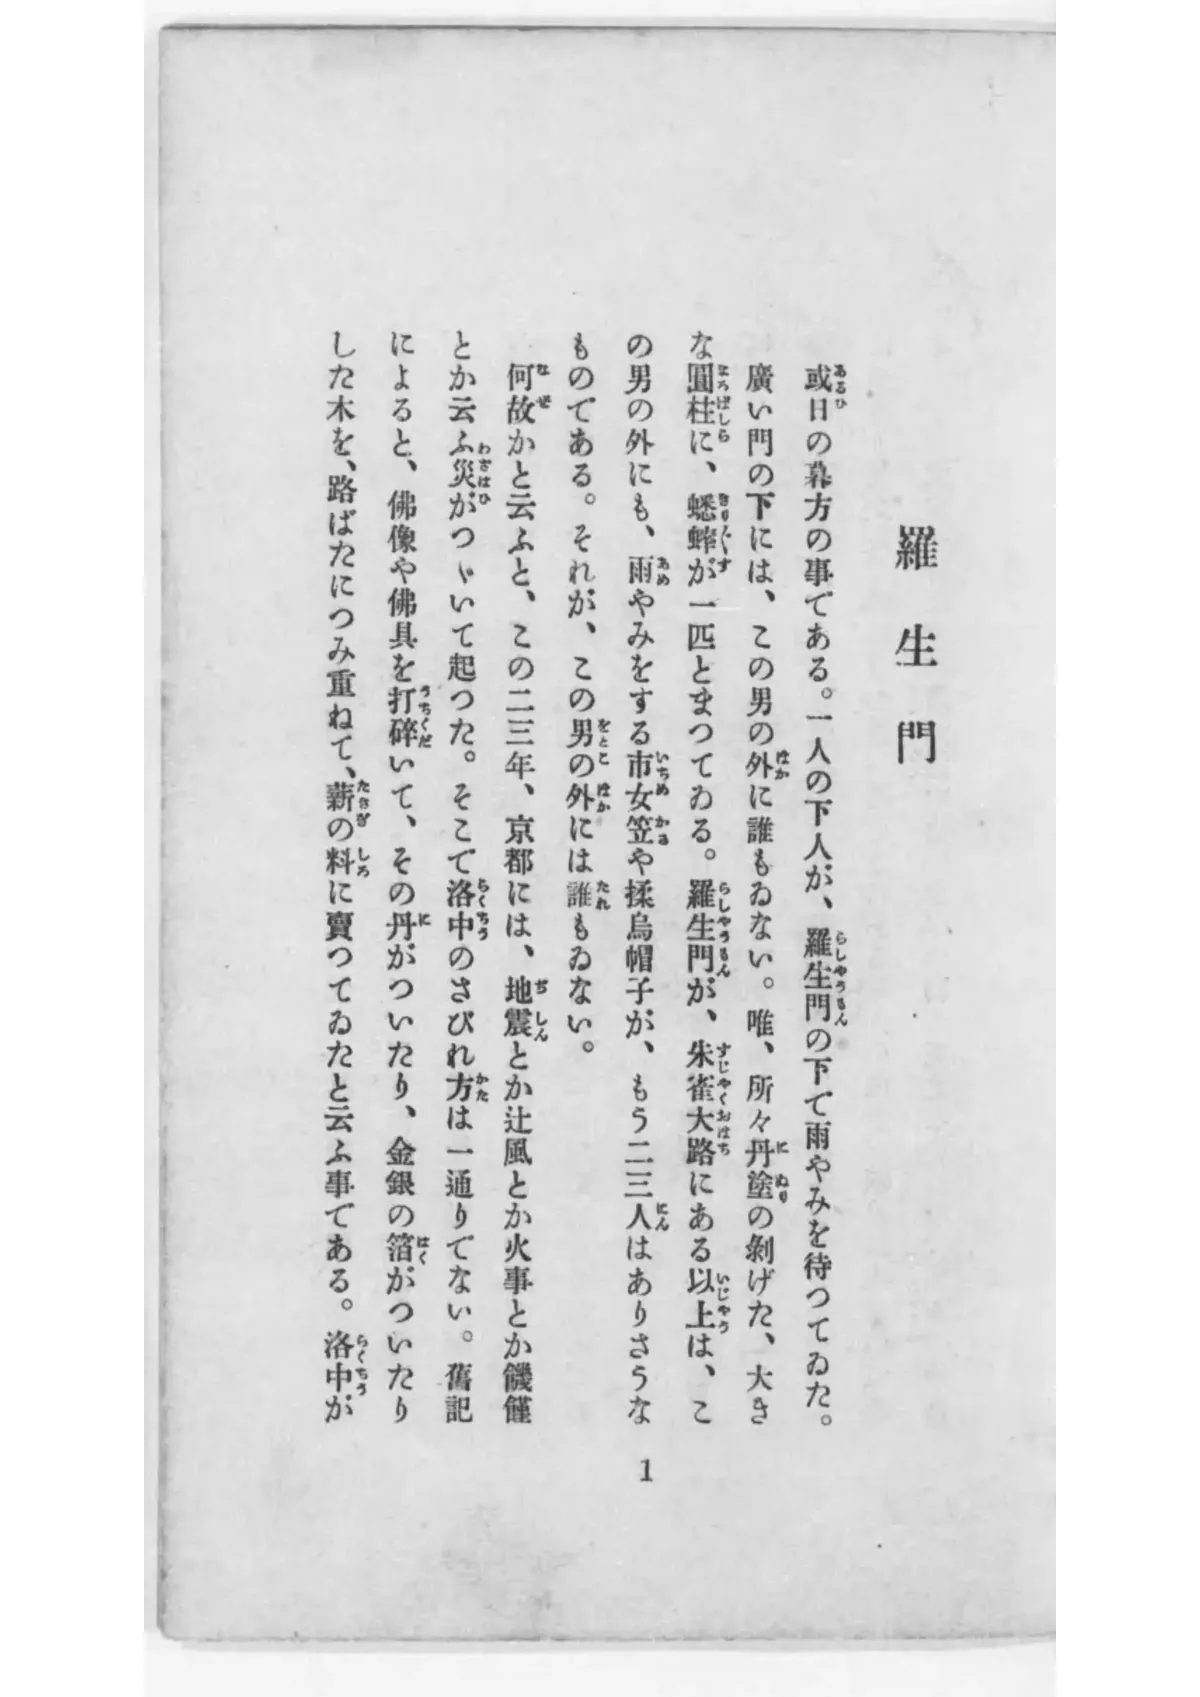
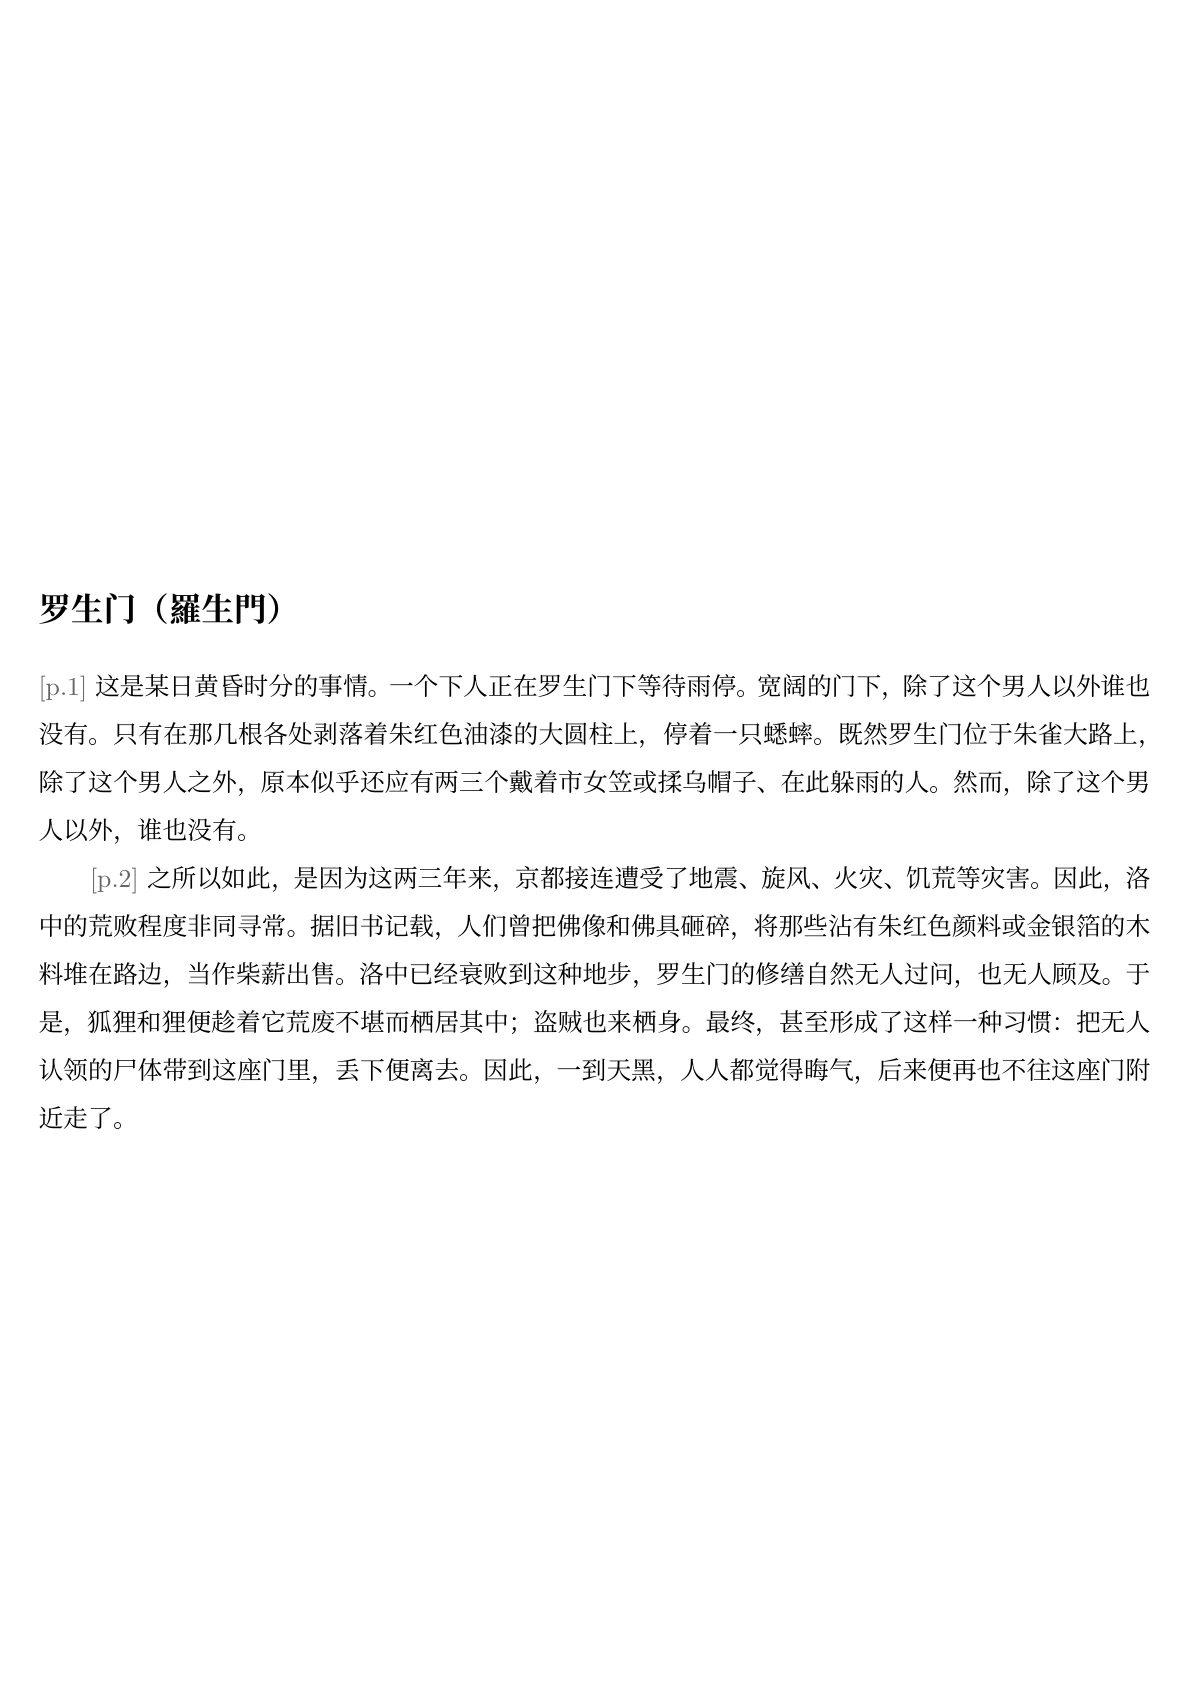
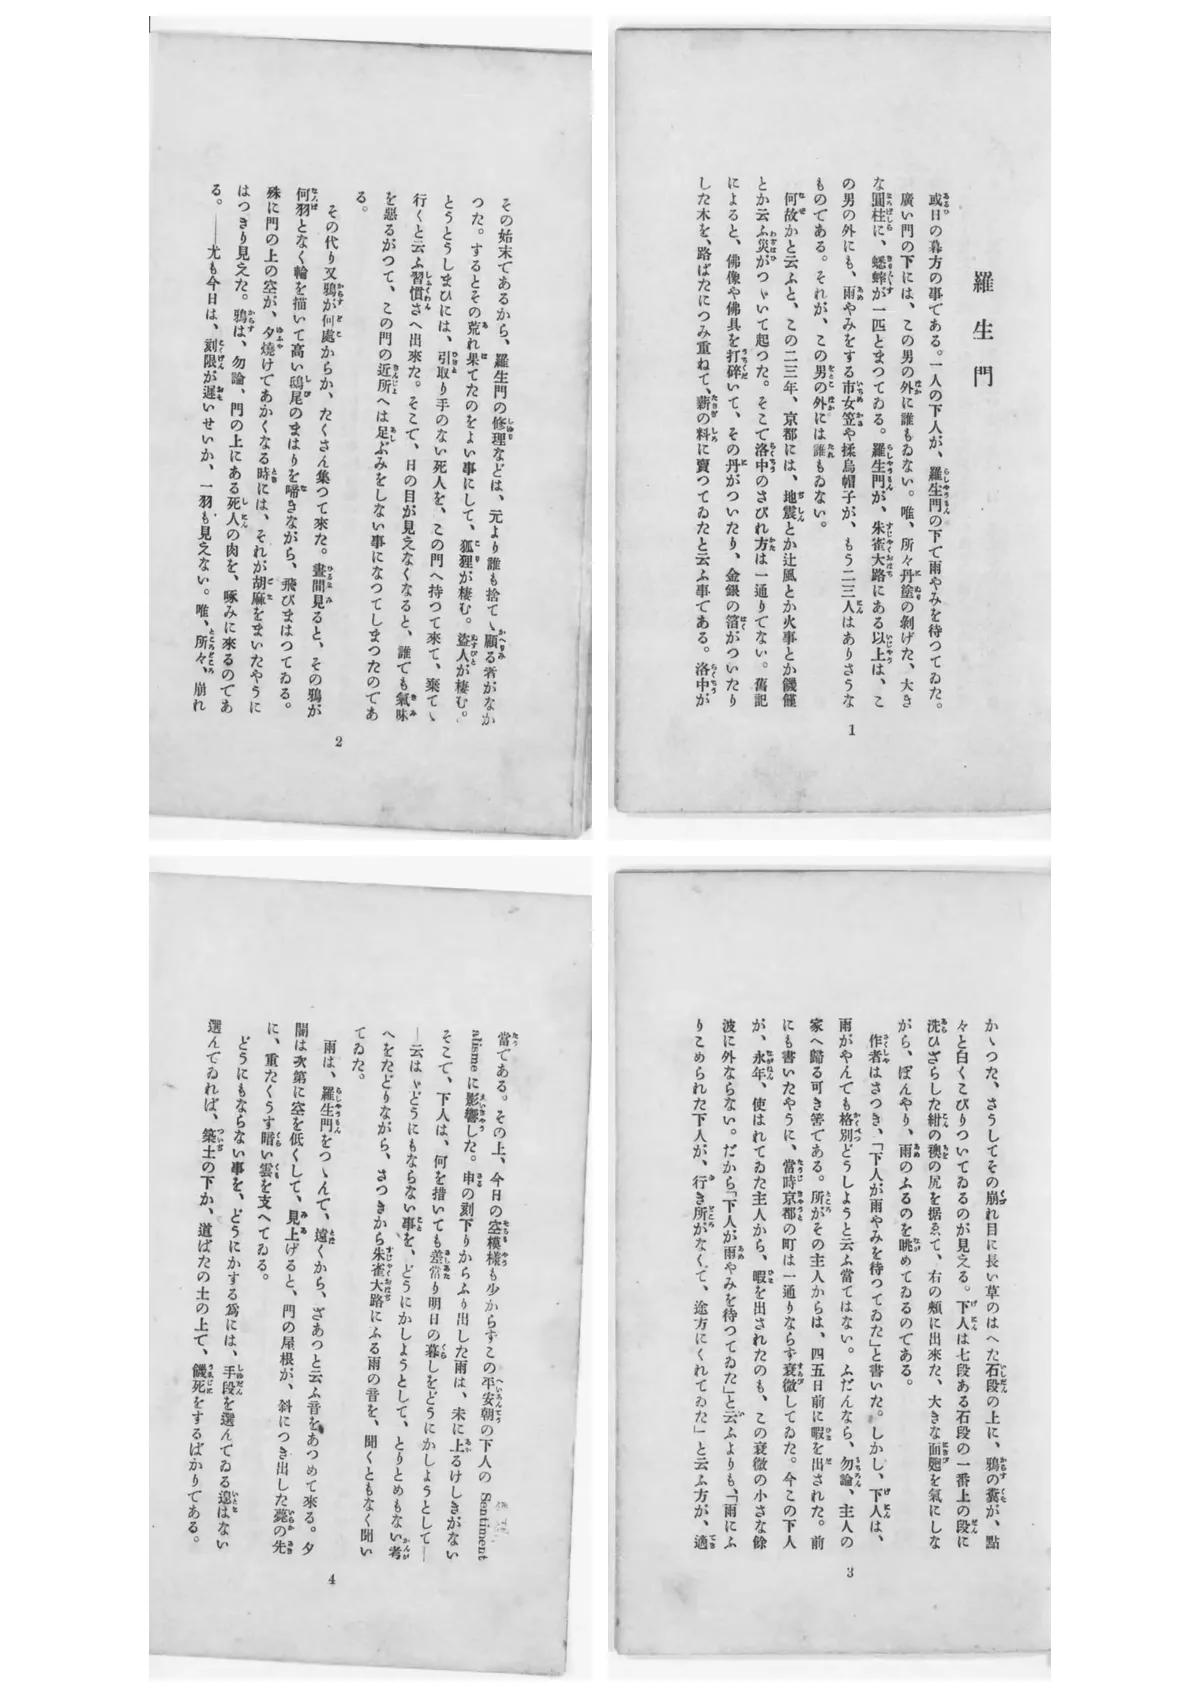
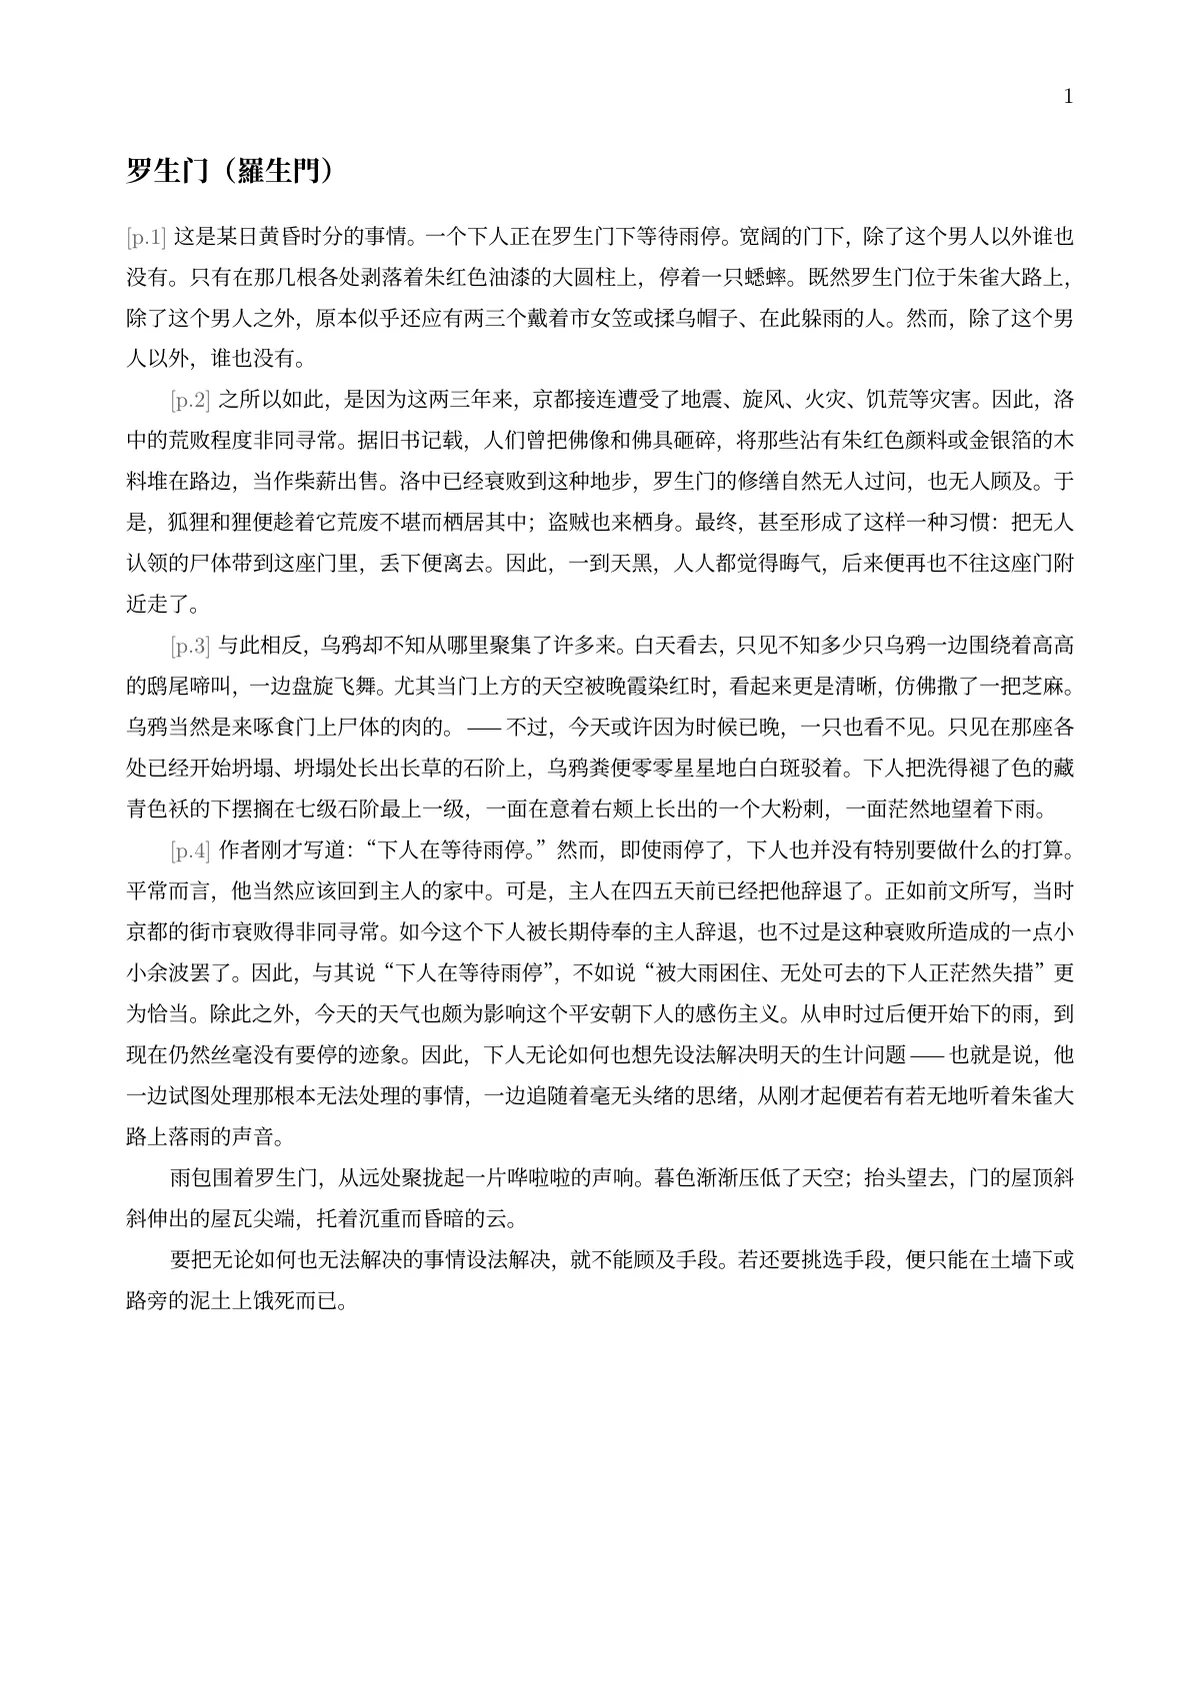
四頁掃描的直式日文,出自1917年《羅生門》原版(舊字體、歷史假名遣、振假名),透過高精度的檔案翻譯與重排模式轉換為橫式繁體中文:保留由右至左的閱讀順序,文字中排除振假名,保留朱雀大路、市女笠、揉烏帽子等時代用語,並翻譯了4頁全文內容。
處理前
或日の暮方の事である。一人の下人が、羅生門の下で雨やみを待つてゐた。廣い門の下には、この男の外に誰もゐない。唯、所々丹塗の剝げた、大きな圓柱に、蟋蟀が一匹とまつてゐる。羅生門が、朱雀大路にある以上は、この男の外にも、雨やみをする市女笠や揉烏帽子が、もう二三人はありさうなものである。それが、この男の外には誰もゐない。
處理後
这是某日黄昏时分的事情。一个下人正在罗生门下等待雨停。宽阔的门下,除了这个男人以外谁也没有。只有在那几根各处剥落着朱红色油漆的大圆柱上,停着一只蟋蟀。既然罗生门位于朱雀大路上,除了这个男人之外,原本似乎还应有两三个戴着市女笠或揉乌帽子、在此躲雨的人。然而,除了这个男人以外,谁也没有。
實際產出結果;顯示前經人工校對3處 · 原文:羅生門, 芥川龍之介, 1917 (作者芥川龍之介於1927年逝世,距今已超過70年;根據日本著作權法,1967年底前逝世作者的作品享有死後50年保護,因此該書的保護期已於1977年底屆滿。日本國立國會圖書館數位典藏將此項目標記為 PDM(公有領域標章)並於線上公開(DOI 10.11501/1088339)。)
常見問題
翻譯掃描檔需要多少費用?
掃描檔會經過 AI 重排所使用的識別路徑:高精度模式每頁 8 點數,標準模式每頁 4 點數,每個檔案最低收費 10 點數。單張圖片視為一頁。
為什麼比一般 PDF 更貴?
掃描檔在翻譯前必須先經過識別,此步驟所需的運算量遠高於讀取現有的文字層。數位 PDF 在保留版面模式下每頁收費 4 點數。
多欄位版面會不會亂掉?
不會。多欄位頁面會依照閱讀順序還原,而不是直接從左到右掃描成一個區塊。
手寫文字可以識別嗎?
印刷文字的識別可靠度遠高於手寫文字。若文件大部分為手寫,結果需要檢查——請先執行文件提取以查看識別品質。
完成的翻譯是什麼格式?
掃描檔會經過 AI 重排,因此您可以匯出 Word、PDF、Markdown 或 EPUB。請注意,翻譯內容不會覆蓋回原始圖片上;而是排版成一份可編輯的文件。
單張圖片真的要 10 點數嗎?
是的——每個檔案至少收取 10 點數,且一張圖片視為一頁。在上傳前將多張圖片合併為一個 PDF,會依總頁數計費,這樣比較划算。
相關內容
简体中文 · English · Français · Deutsch · Русский · 日本語 · 한국어 · العربية
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.