Traduction de documents numérisés
Dans un scan, le texte n'est pas du texte, c'est une image. Vous ne pouvez pas le sélectionner et les outils de traduction ordinaires ne peuvent pas le lire. C'est pourquoi le simple fait de glisser une archive photocopiée dans une zone de traduction ne donne généralement aucun résultat.
Geyi reconnaît ces fichiers avant de les traduire : le logiciel extrait les caractères de l'image, détermine l'ordre de lecture, puis traduit et remet en page le résultat. Les pages multi-colonnes sont restituées colonne par colonne plutôt que de manière désordonnée, et le texte vertical est converti en horizontal.
Quels originaux sont concernés
- Pages de livres numérisées et archives photocopiées — fichiers PDF produits par un scanner ou un copieur.
- Photographies de documents — formats PNG, JPEG, WEBP, TIFF et formats d'image similaires.
- PDF contenant uniquement des images — ceux pour lesquels aucun texte ne peut être sélectionné dans un lecteur.
- Publications anciennes avec des mises en page complexes — colonnes multiples, texte vertical, doubles pages.
Quand la reconnaissance est-elle la plus précise
Une impression propre numérisée directement offre la meilleure précision. Les images floues, inclinées ou inégalement éclairées, ainsi que les pages contenant beaucoup d'écriture manuscrite, sont nettement plus difficiles à traiter. Pour ces cas, vérifiez les passages clés par rapport à l'original avant l'exportation.
Le japonais vertical, les doubles pages et autres ordres de lecture inhabituels sont corrigés automatiquement, sans qu'il soit nécessaire de diviser les pages ou de réorganiser quoi que ce soit vous-même.
Lorsque vous souhaitez uniquement le texte original
Si vous avez seulement besoin d'extraire le texte d'un scan sans le traduire, l'extraction de document est plus adaptée : elle est facturée 4 crédits par page et produit un document Word, PDF, TXT ou Markdown horizontal et modifiable, dans la langue de l'original.
Effectuer d'abord une extraction pour vérifier la qualité de la reconnaissance, puis décider de traduire ou non, est également un moyen d'économiser des crédits.
Résultats concrets
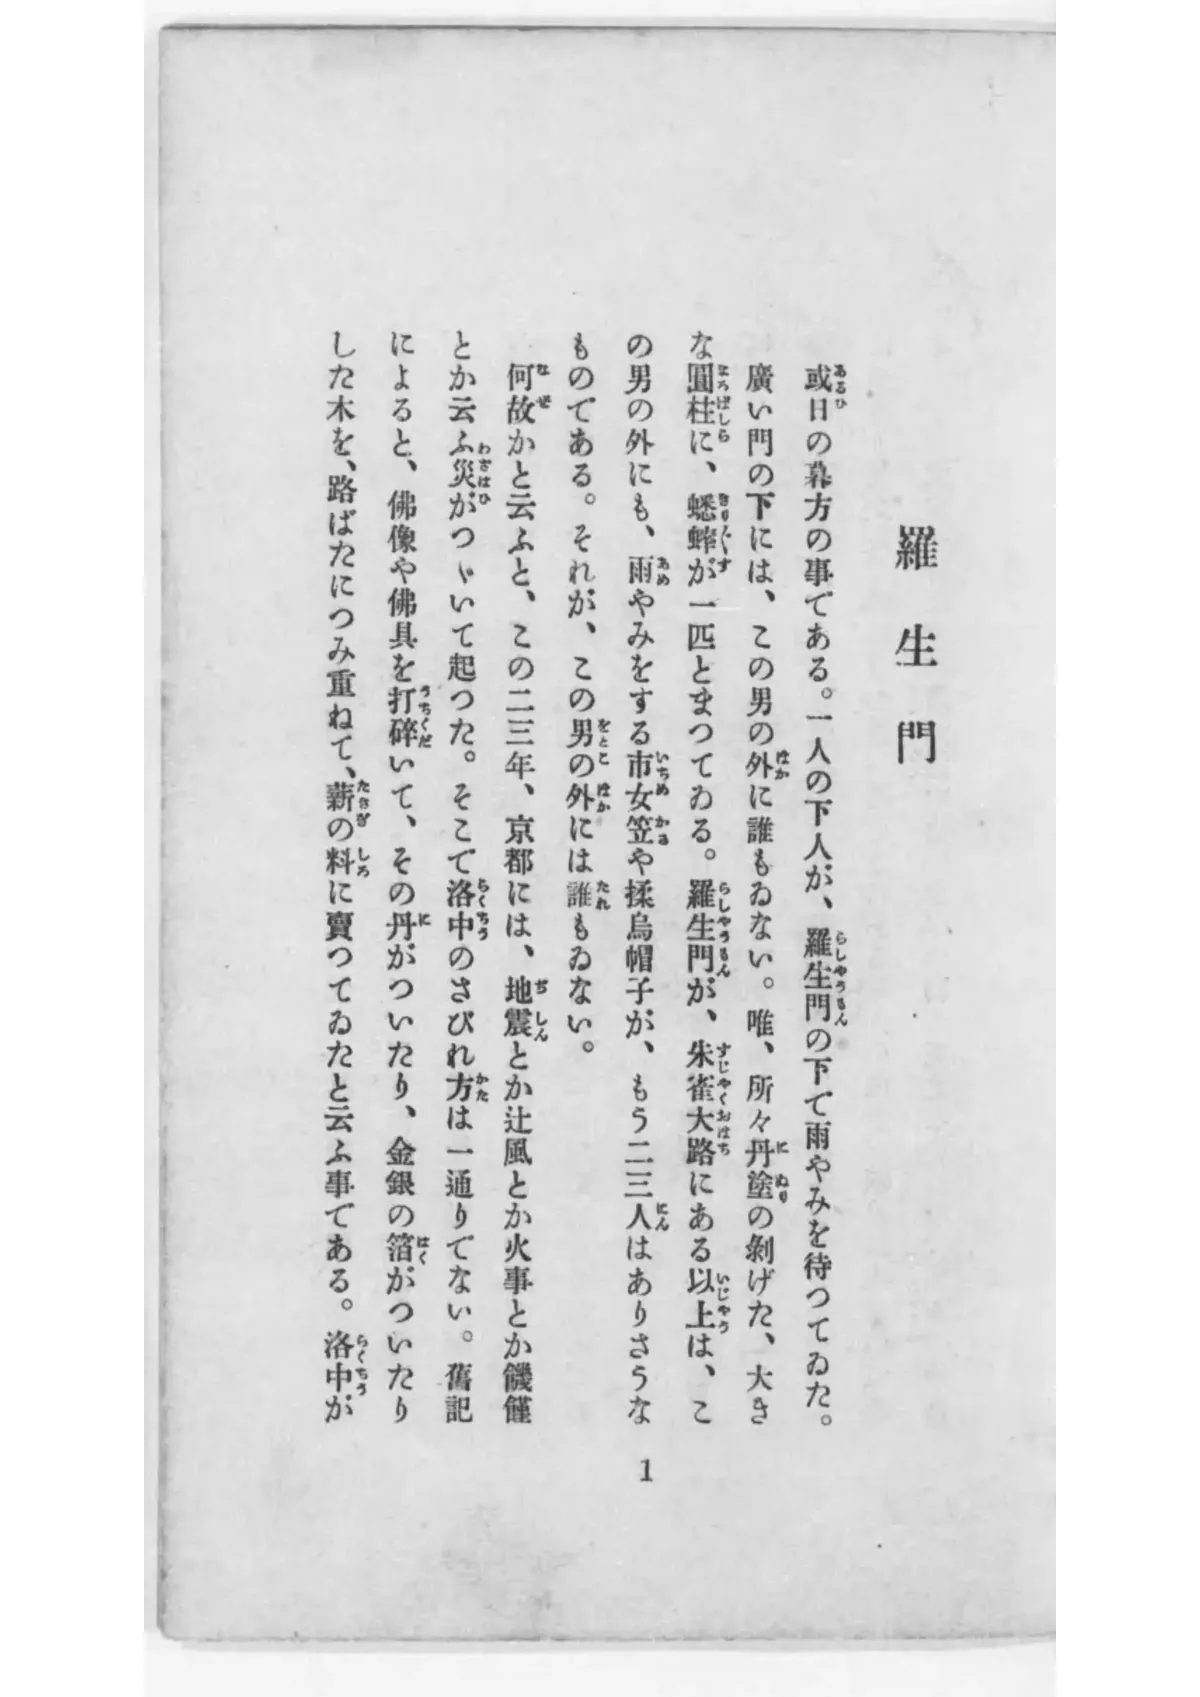
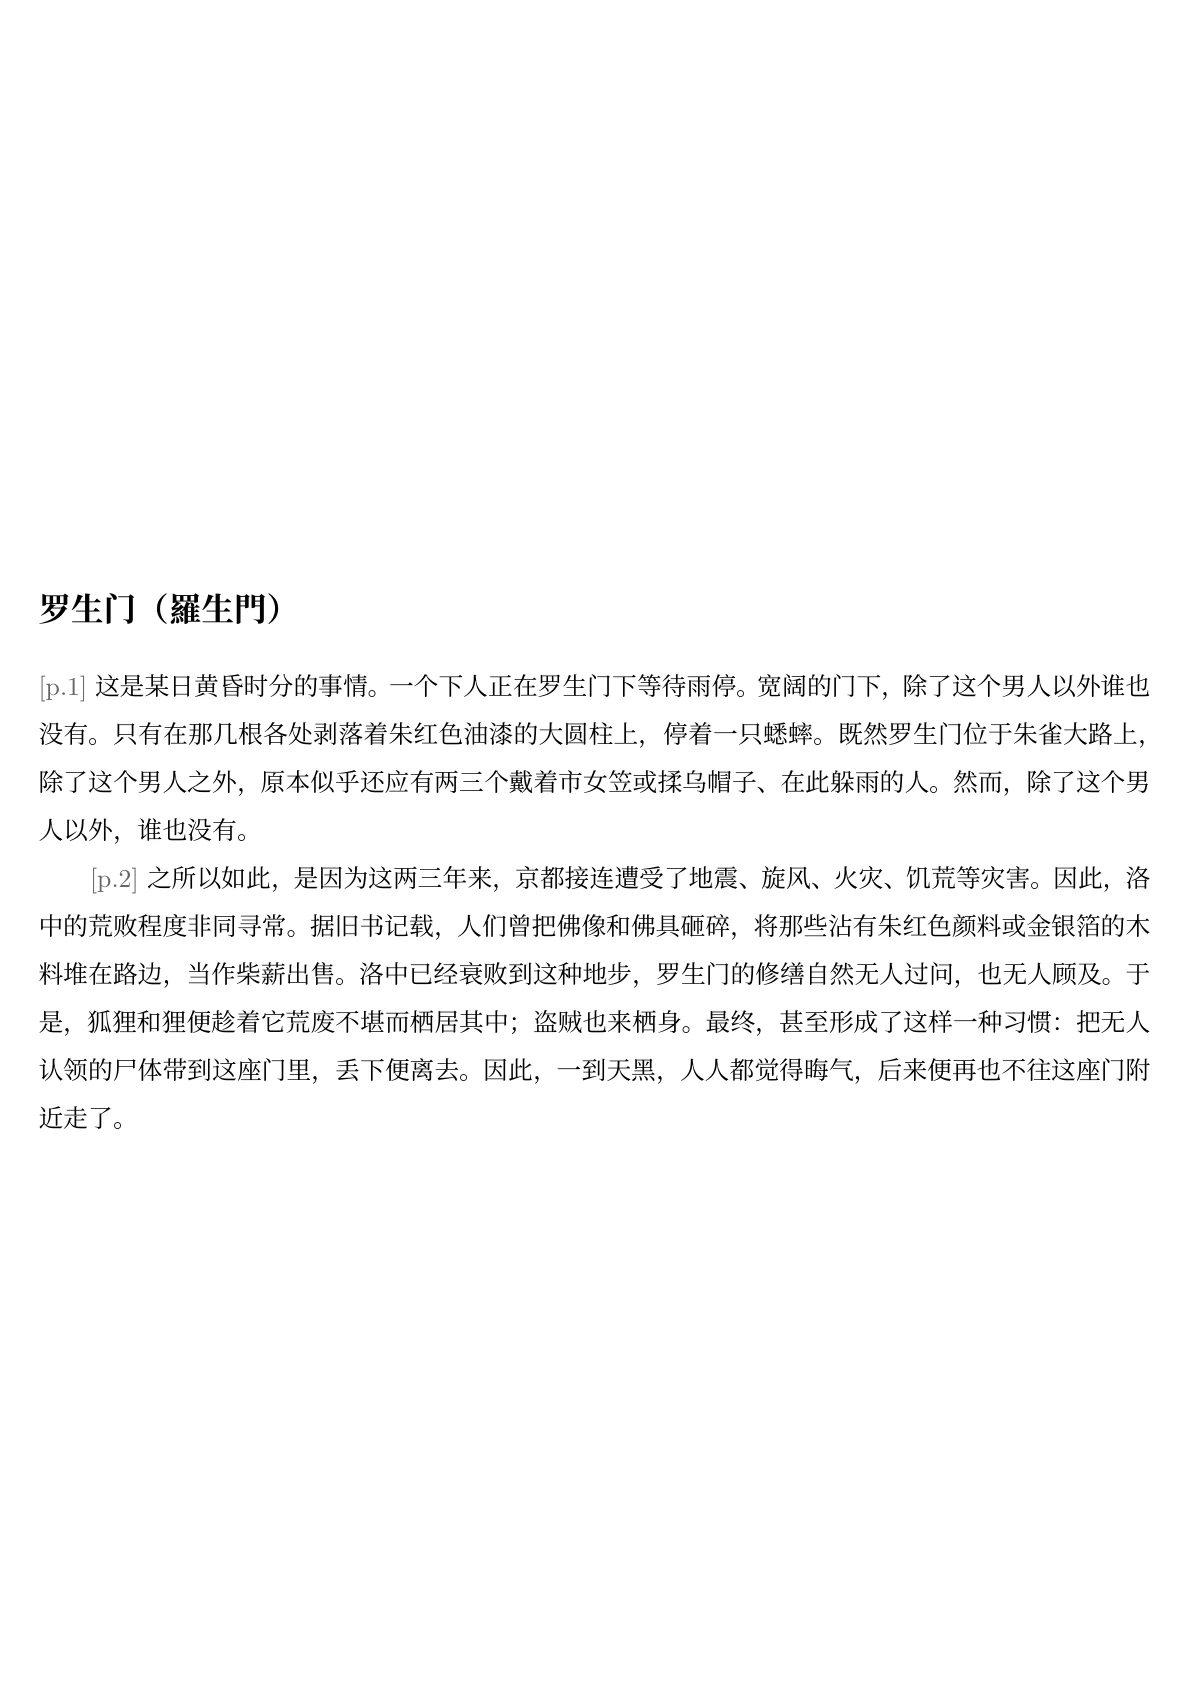
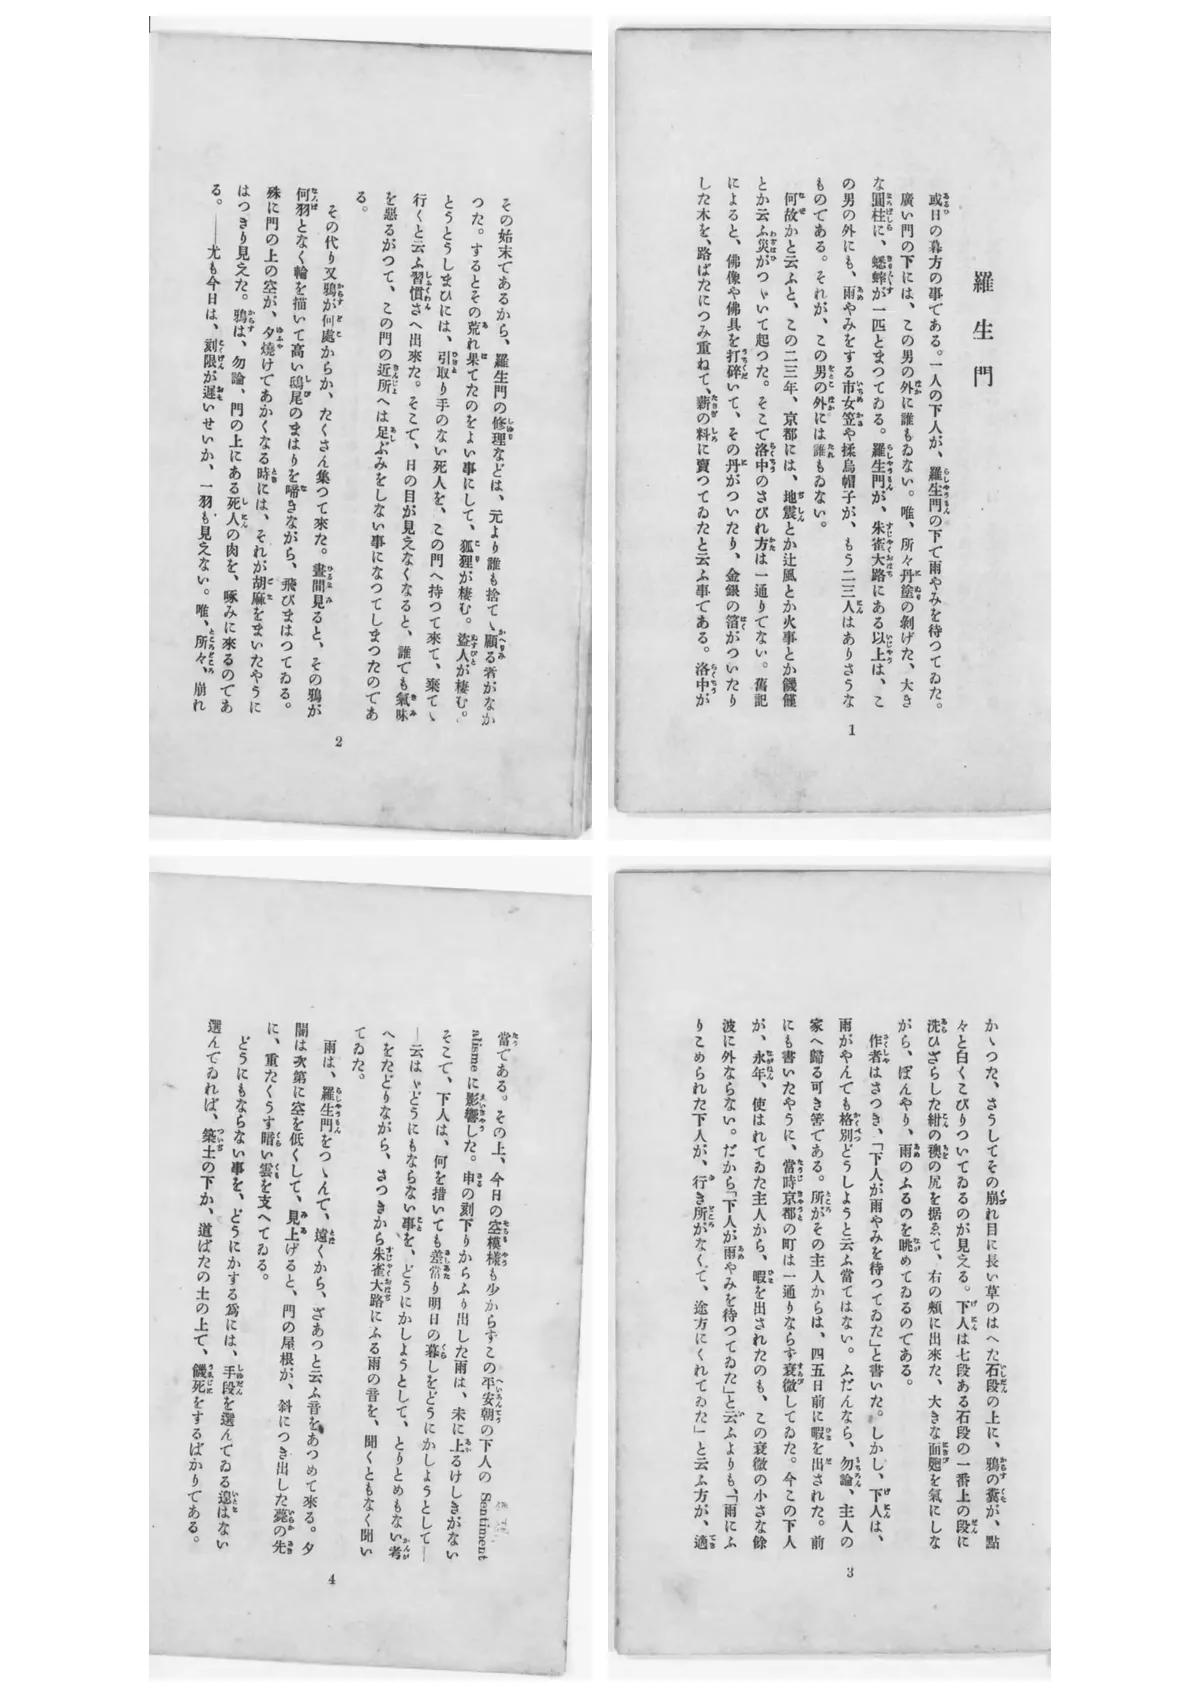
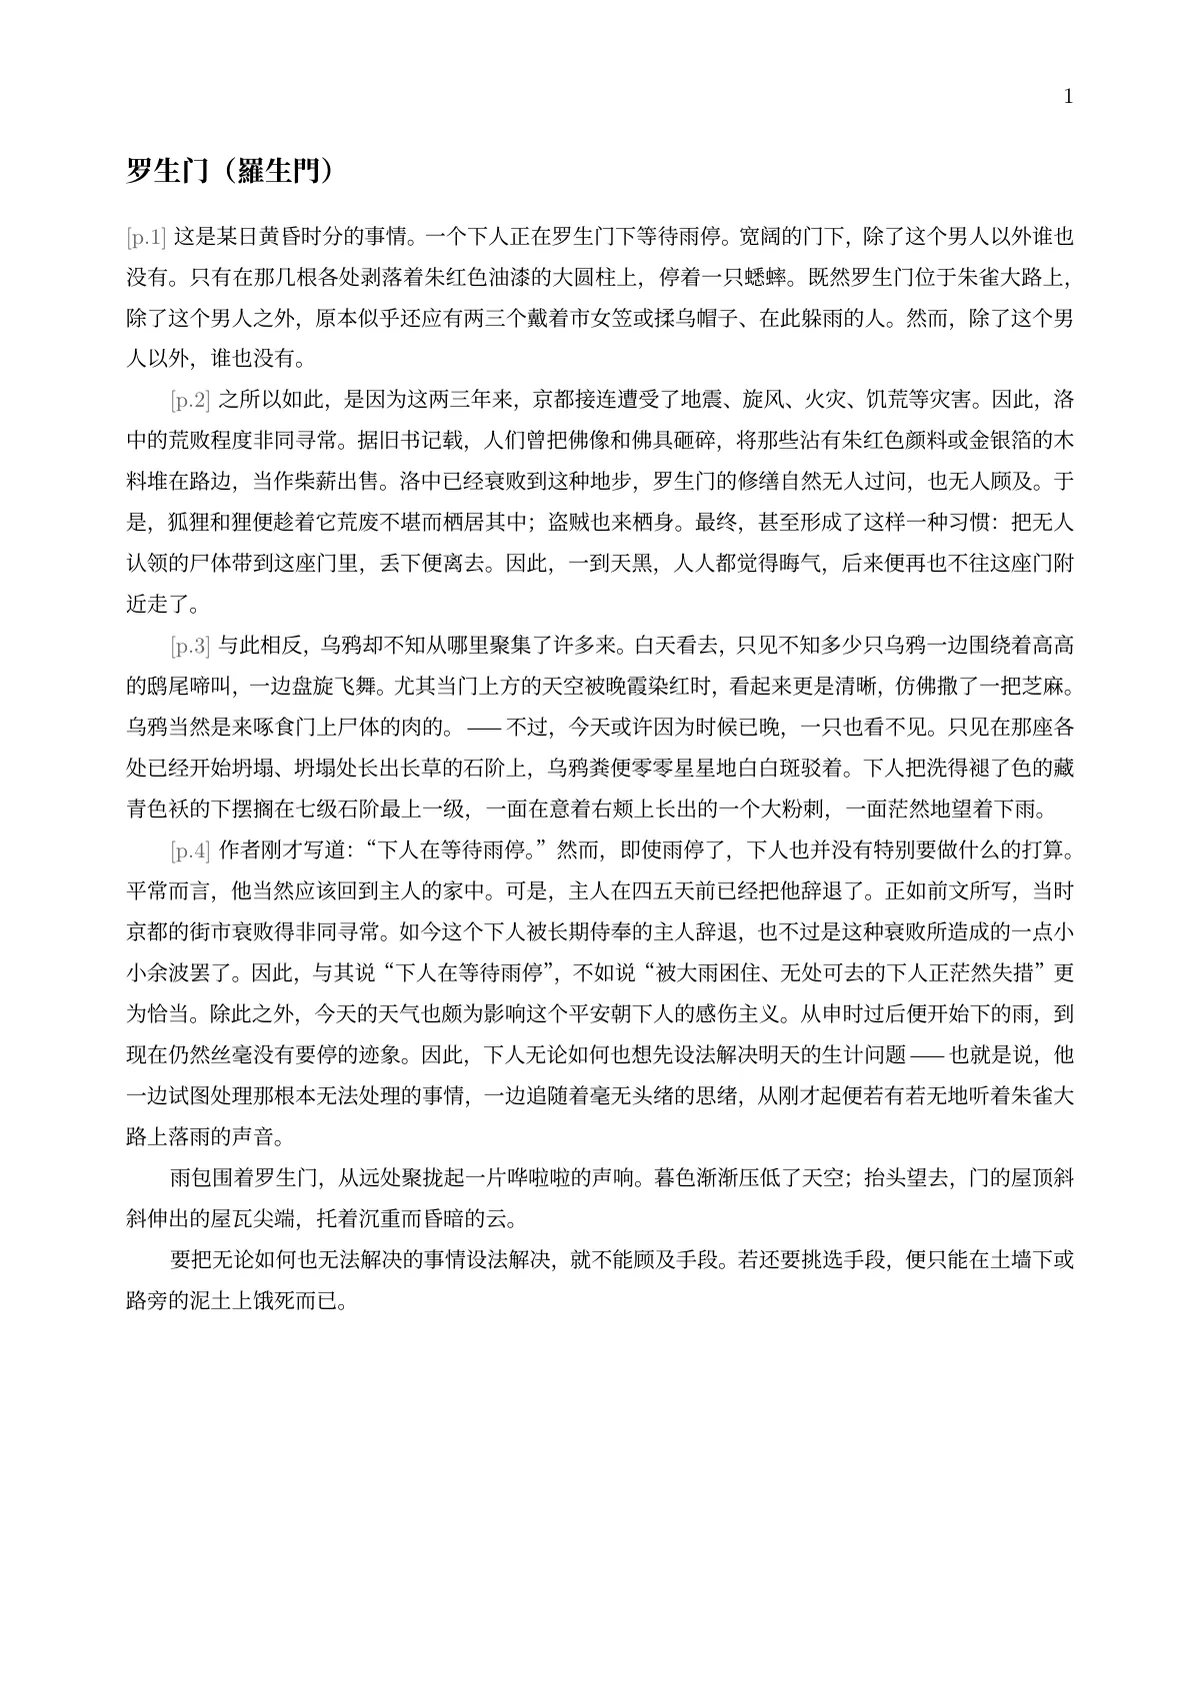
Quatre pages numérisées de japonais vertical issues de l'édition originale de 1917 de Rashōmon (kanji anciens, kana historiques, furigana) sont converties en chinois simplifié horizontal grâce à la traduction de fichiers avec une grande précision en mode reflow : le sens de lecture de droite à gauche est conservé, les furigana sont exclus du texte, les termes d'époque tels que l'avenue Suzaku, ichime-gasa et momi-eboshi sont préservés, et tout le corps du texte des 4 pages est traduit.
Avant
或日の暮方の事である。一人の下人が、羅生門の下で雨やみを待つてゐた。廣い門の下には、この男の外に誰もゐない。唯、所々丹塗の剝げた、大きな圓柱に、蟋蟀が一匹とまつてゐる。羅生門が、朱雀大路にある以上は、この男の外にも、雨やみをする市女笠や揉烏帽子が、もう二三人はありさうなものである。それが、この男の外には誰もゐない。
Après
这是某日黄昏时分的事情。一个下人正在罗生门下等待雨停。宽阔的门下,除了这个男人以外谁也没有。只有在那几根各处剥落着朱红色油漆的大圆柱上,停着一只蟋蟀。既然罗生门位于朱雀大路上,除了这个男人之外,原本似乎还应有两三个戴着市女笠或揉乌帽子、在此躲雨的人。然而,除了这个男人以外,谁也没有。
Résultat de production réel ; 3 points corrigés manuellement avant affichage · Source : Rashōmon, Ryūnosuke Akutagawa, 1917 (L'auteur, Ryūnosuke Akutagawa, est décédé en 1927, il y a plus de 70 ans ; selon la loi japonaise sur le droit d'auteur, les œuvres des auteurs décédés avant la fin de 1967 étaient protégées pendant 50 ans après leur décès, la protection de ce livre a donc expiré à la fin de 1977. Les collections numériques de la Bibliothèque nationale de la Diète marquent cet élément PDM (Public Domain Mark) et le publient en ligne (DOI 10.11501/1088339).)
Questions fréquentes
Combien coûte la traduction d'un scan ?
Les scans suivent le parcours de reconnaissance utilisé par le document layout reflow : 8 crédits par page en haute précision, 4 en standard, avec un minimum de 10 crédits par fichier. Une seule image compte pour une page.
Pourquoi est-ce plus cher qu'un PDF normal ?
Un scan doit être reconnu avant de pouvoir être traduit, et cette étape consomme beaucoup plus de ressources de calcul que la lecture d'une couche de texte existante. Les PDF numériques en mode de préservation de la mise en page coûtent 4 crédits par page.
Les mises en page multi-colonnes sont-elles restituées de manière désordonnée ?
Non. Les pages multi-colonnes sont restaurées dans l'ordre de lecture plutôt que d'être balayées de gauche à droite en un seul bloc.
L'écriture manuscrite peut-elle être reconnue ?
Le texte imprimé est reconnu de manière beaucoup plus fiable que l'écriture manuscrite. Lorsqu'un document est en grande partie manuscrit, les résultats doivent être vérifiés — effectuez d'abord une extraction de document pour évaluer la qualité de la reconnaissance.
Quel est le format de la traduction finale ?
Les scans passent par le document layout reflow, vous pouvez donc exporter au format Word, PDF, Markdown ou EPUB. Notez que la traduction n'est pas réinsérée sur l'image originale ; elle est mise en page sous forme de document modifiable.
Une seule image coûte-t-elle vraiment 10 crédits ?
Oui — chaque fichier est facturé au minimum 10 crédits et une image compte pour une page. Combiner plusieurs images en un seul PDF avant l'importation permet de facturer sur le nombre total de pages, ce qui est plus économique.
Contenu associé
- Traduction de PDF
- Traduction de texte sur image
- Extraction de documents
- Japonais vertical et mises en page classiques
- Explorez un exemple avant d'utiliser votre propre document
简体中文 · English · Deutsch · Русский · 日本語 · 한국어
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.