竖排日文与古籍翻译
竖排日文是通用翻译工具最容易翻车的地方:字从上往下、从右往左排,一旦按横排的习惯去读,出来的就是一串顺序全乱的句子——每个词都认识,连起来什么也不是。竖版古籍、旧刊也是同样的问题。
上传竖排文档开始翻译
格译对竖排版面单独处理:识别时就按竖排的阅读顺序走,見開き(跨页排版)与多栏页面的顺序也会自动纠正,译文统一转成横排。
格译对竖排版面单独处理:识别时按竖排的阅读顺序走,見開き与多栏页面的顺序自动纠正,译文统一转成横排;竖排日文与竖排中文都适用。
核心能力
- 竖排日文与竖排中文,识别后转成横排输出
- 見開き(左右跨页)按整体阅读顺序还原
- 多栏页面按栏还原
- 图注与旁注按版面归属处理
- 只要原文时可用文档提取,不翻译
会自动处理的几种版式
- 竖排日文与竖排中文:识别后转成横排输出。
- 見開き(左右跨页):按跨页整体的阅读顺序还原,不必自己把页面拆成两半。
- 多栏页面:按栏还原,不会横扫成一大团。
- 混排的图注与旁注:按版面归属处理,而不是插进正文中间。
先提取还是直接翻译
如果你要的是把古籍或旧刊里的原文抠出来做研究,用文档提取:4 积分一页,只提取不翻译,原文是什么语言出来还是什么语言,导出 Word / PDF / TXT / Markdown。
如果要的是读懂内容,直接走文件翻译的 AI 重排,识别与翻译一次完成。不确定识别质量时,先用文档提取跑一页看看,是最省的做法。
老资料的常见障碍
影印质量是决定性因素:印刷清晰、扫描端正的识别率最高;纸张发黄、油墨晕开、扫描倾斜都会让识别难度上升。异体字与旧字形也可能被识别成现代字形。
涉及考据的用途,建议把译文当作阅读辅助,关键结论仍以原件为准。
格译与通用机器翻译、手工处理对比
「通用机器翻译」「手工处理」两列描述的是常见情况,具体表现因工具和做法而异;格译一列只列目前已上线、可在产品里用到的能力。
实际效果
1917 年版《罗生门》开头 4 页竖排扫描件经高精度重排翻译,再对照原件逐段校订为横排简体中文。展示时清理了混入正文的注音,并修正了衣物、时刻及跨页衔接等译文问题。
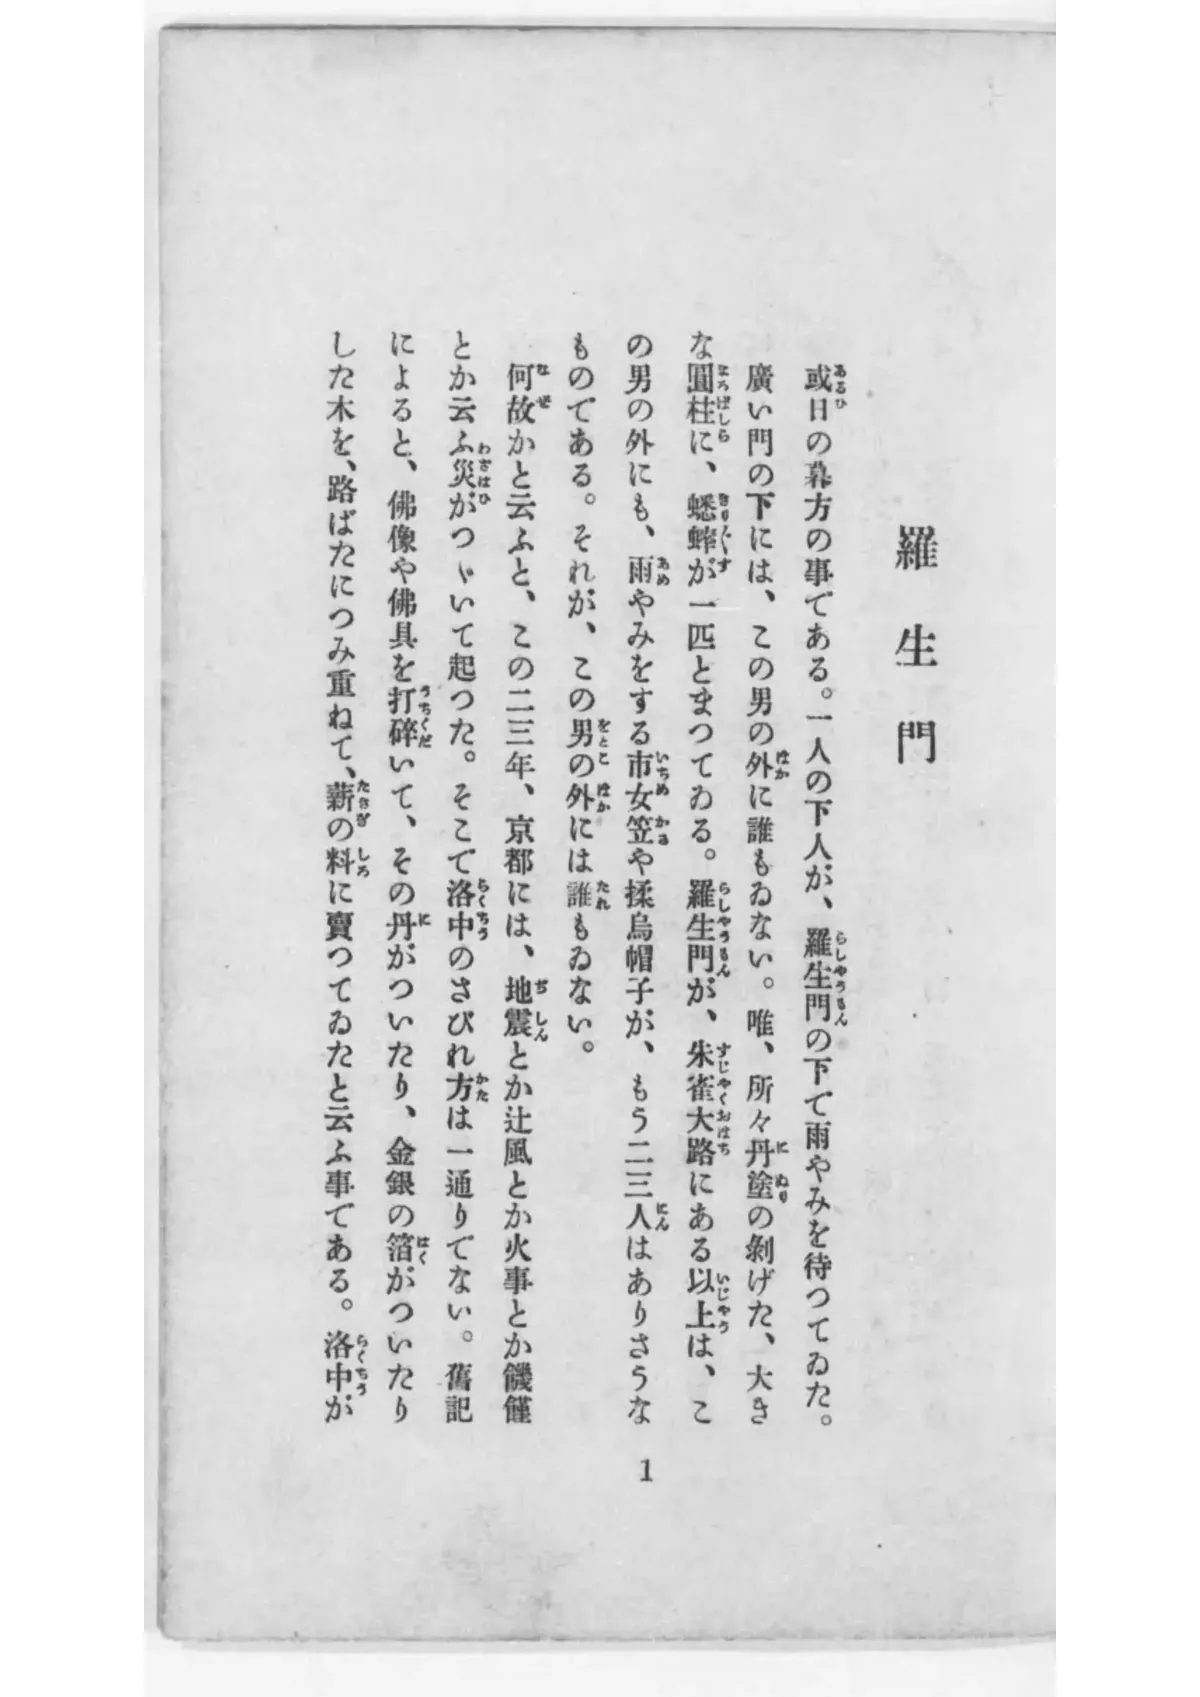
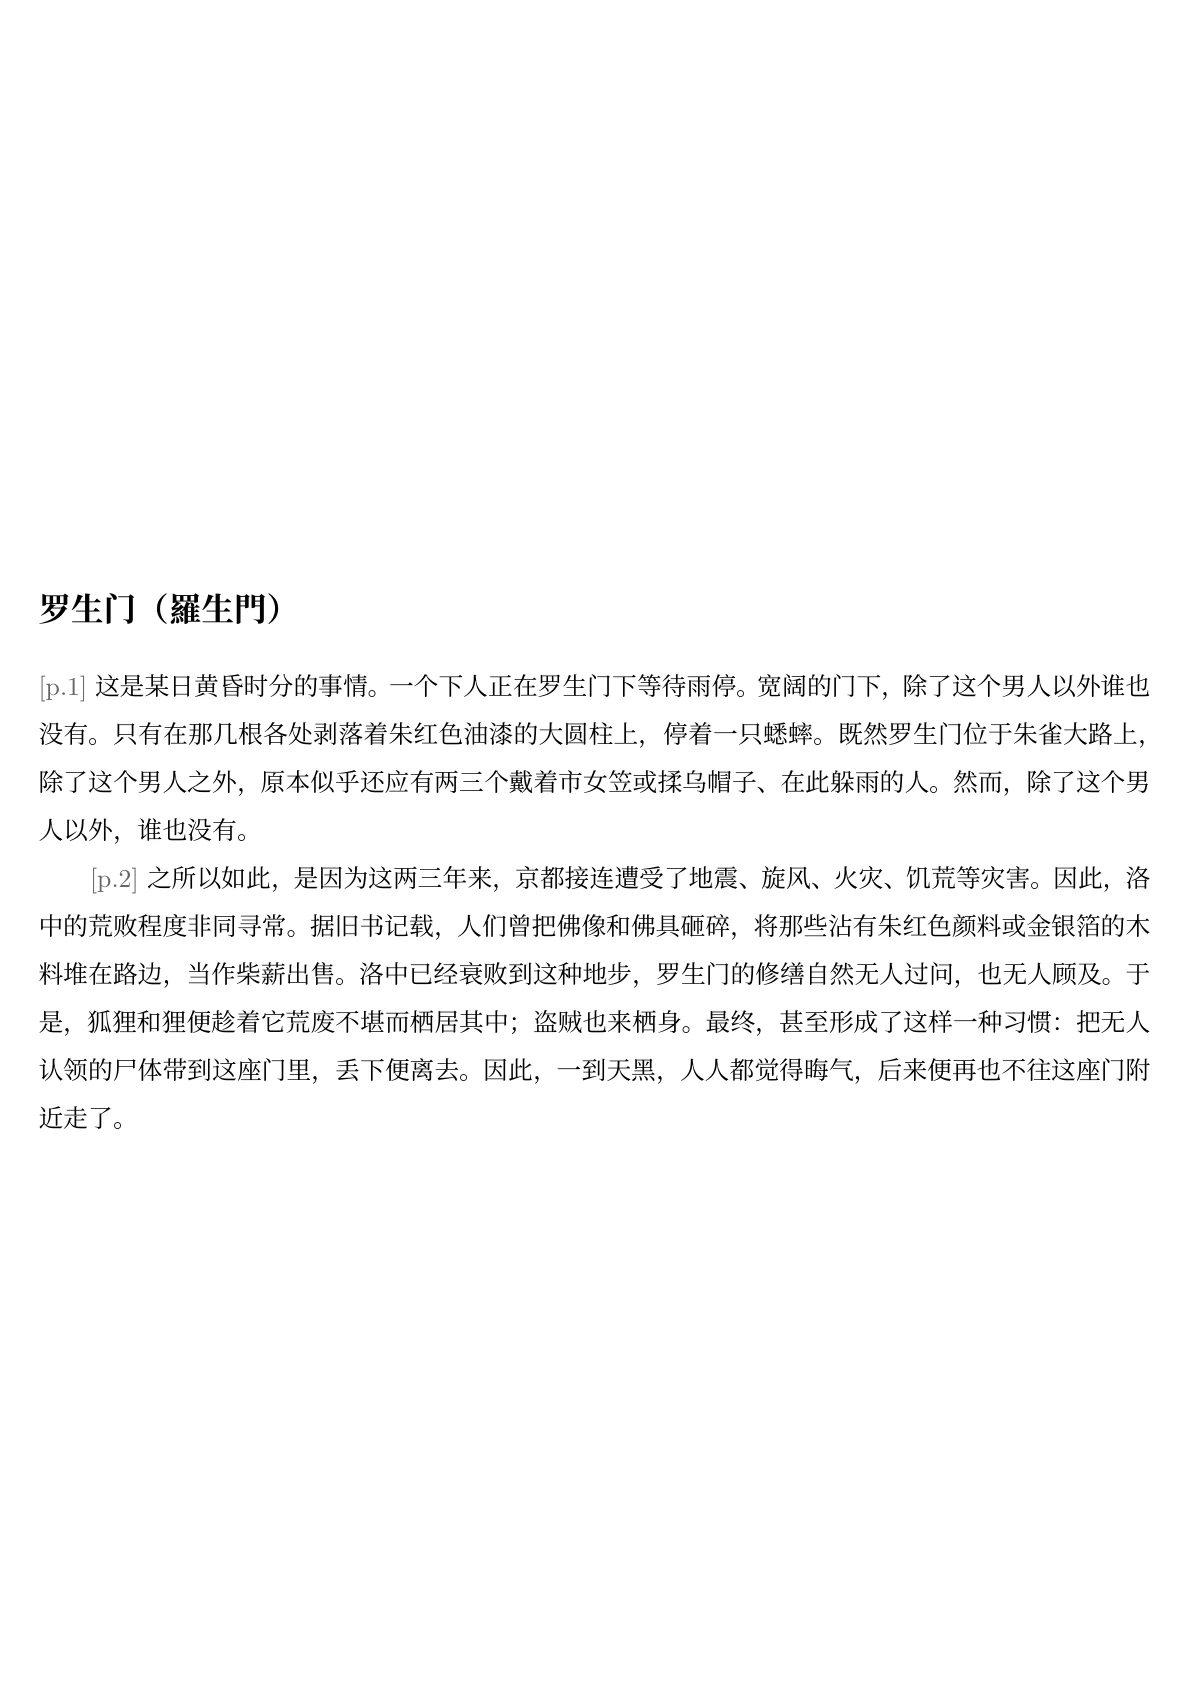 竖排旧书翻译:1917 年版原书第 1 页与校对后的开头一段简体中文译文;注音不混入正文。
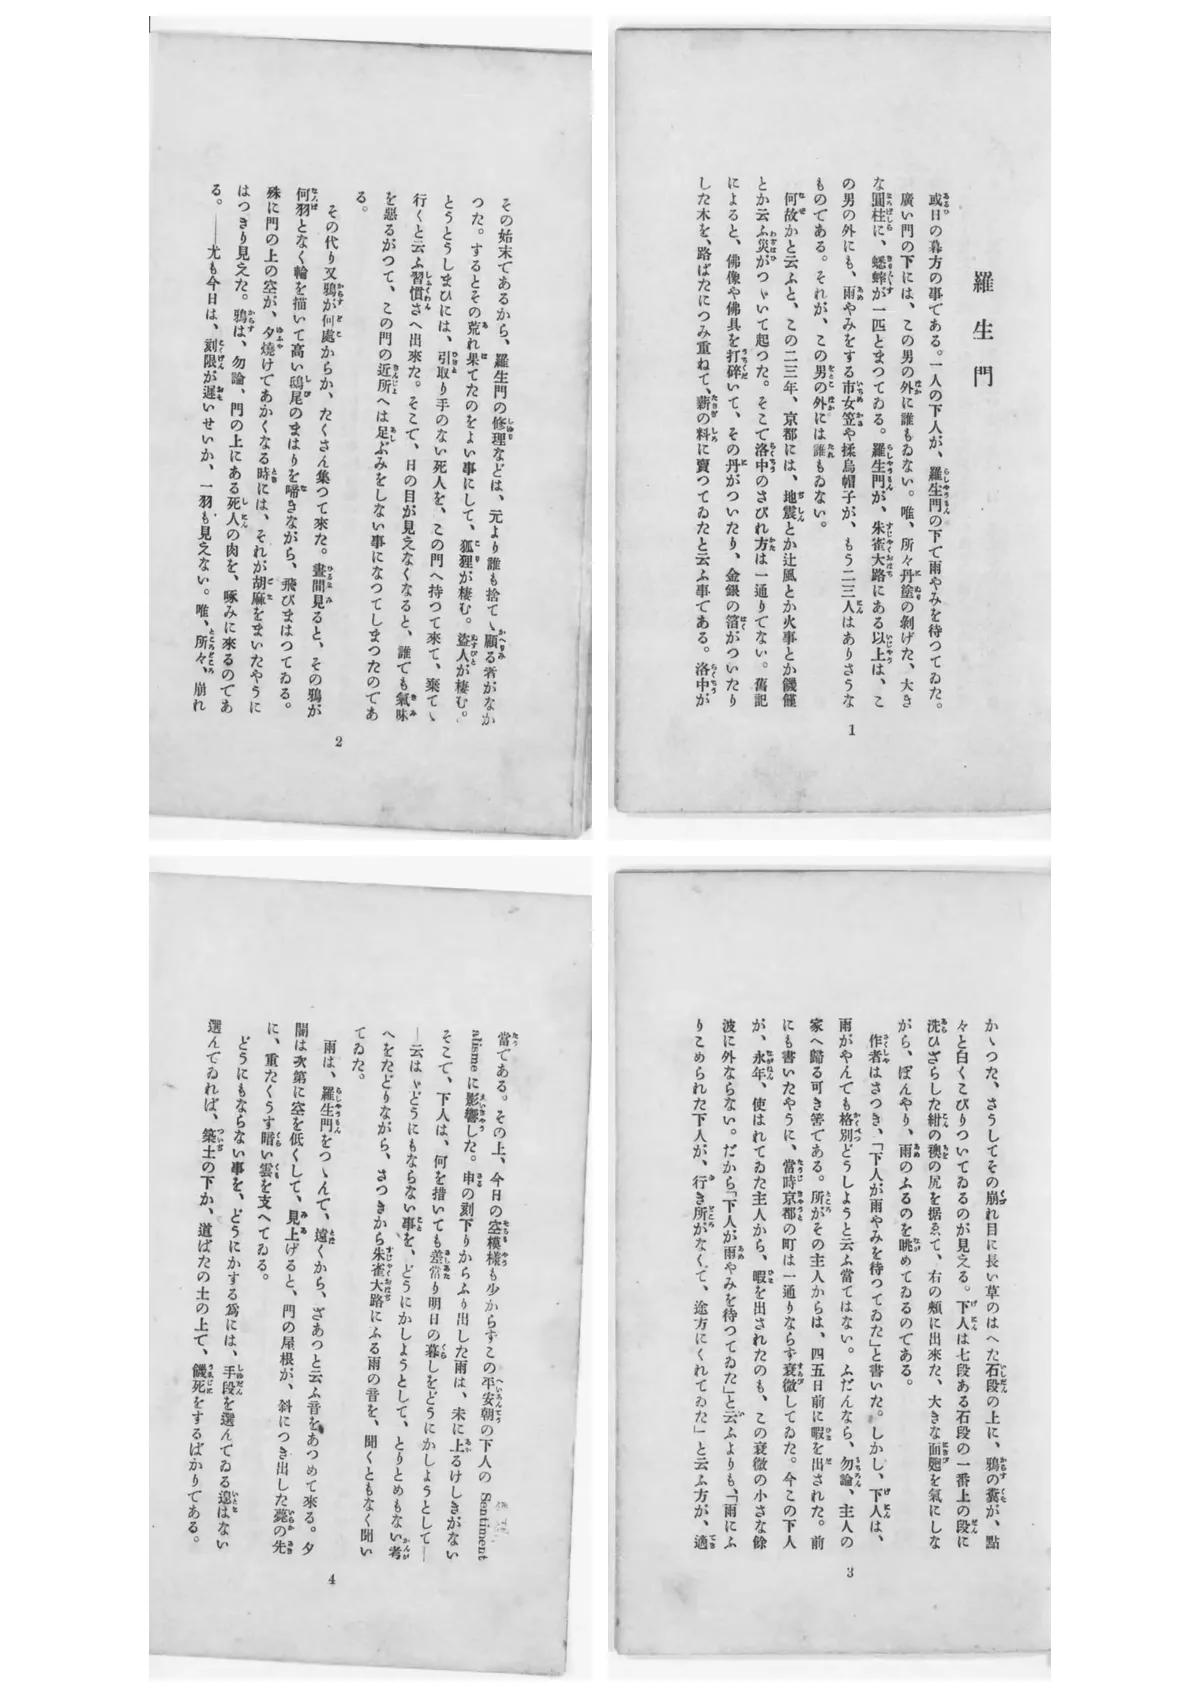
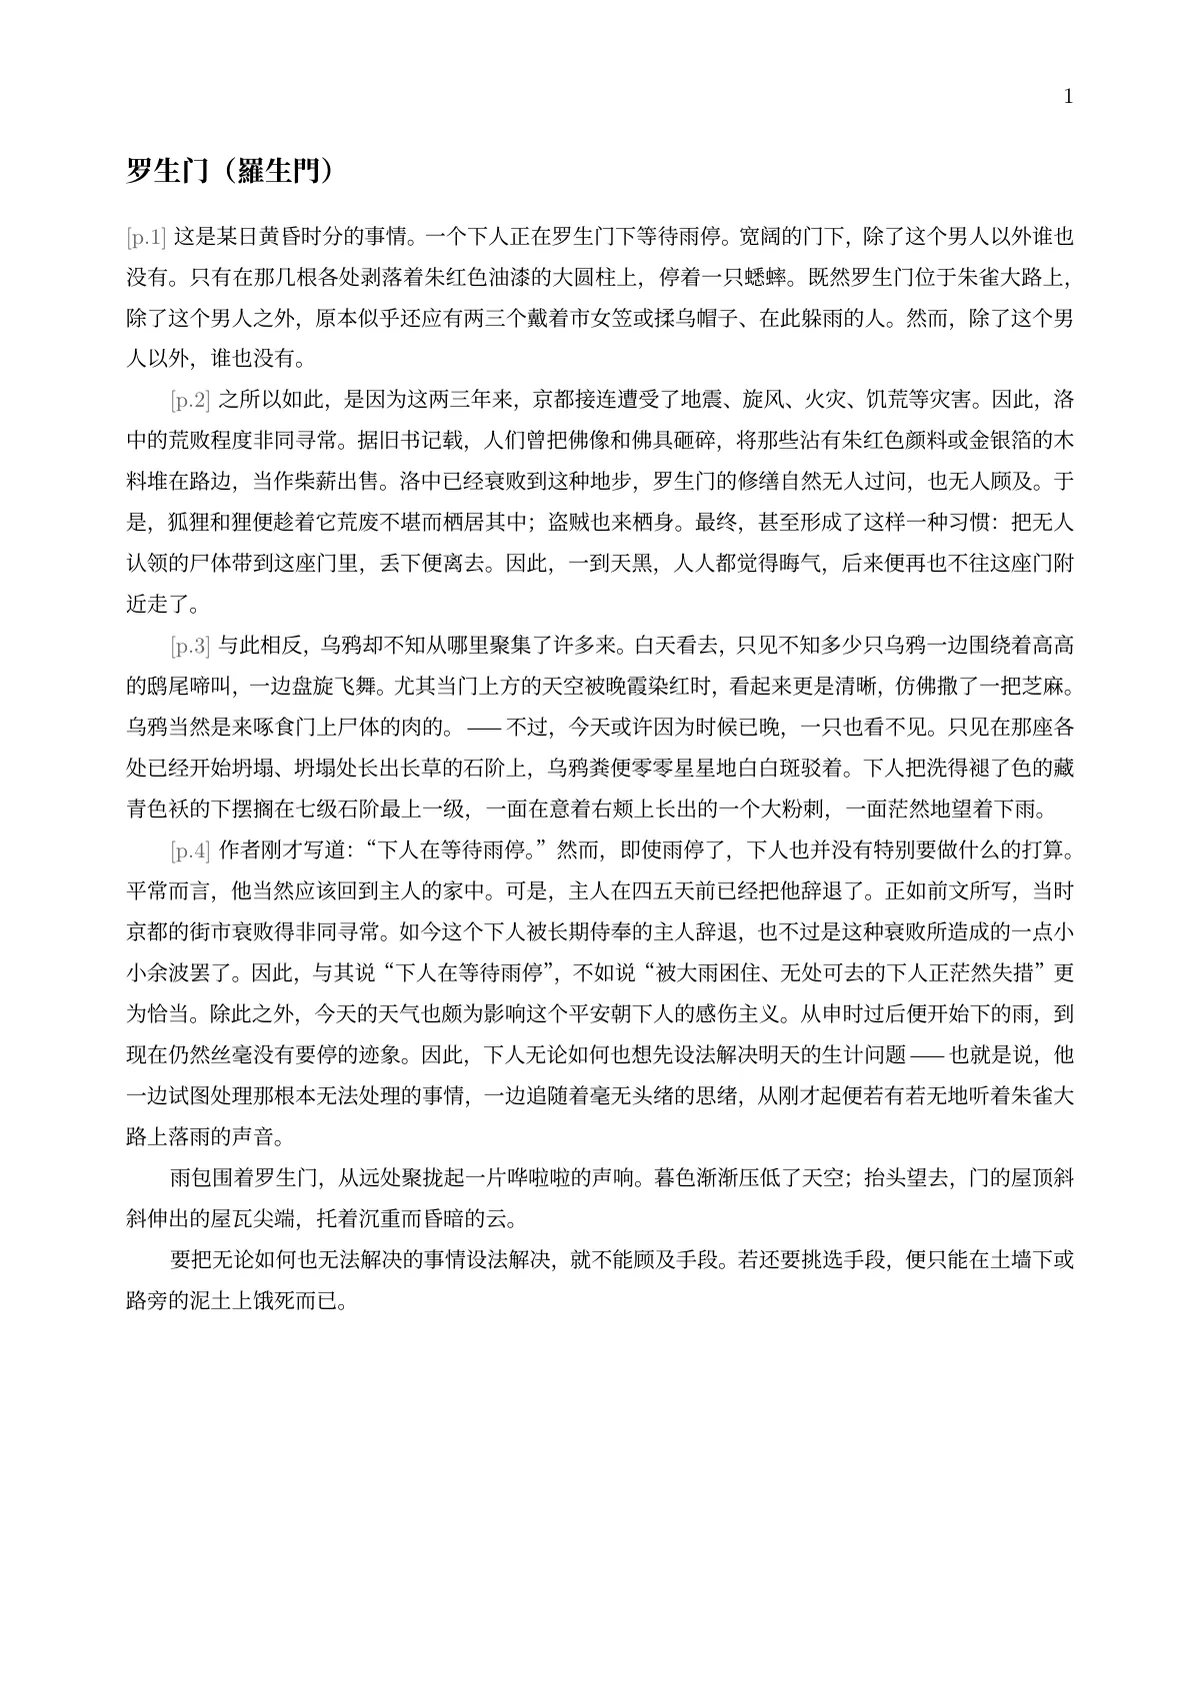 原书第 1–4 页(按日文阅读顺序排列)与完整校订节选对照,跨页文字按语义衔接。
处理前
或日の暮方の事である。一人の下人が、羅生門の下で雨やみを待つてゐた。廣い門の下には、この男の外に誰もゐない。唯、所々丹塗の剝げた、大きな圓柱に、蟋蟀が一匹とまつてゐる。羅生門が、朱雀大路にある以上は、この男の外にも、雨やみをする市女笠や揉烏帽子が、もう二三人はありさうなものである。それが、この男の外には誰もゐない。
处理后
某日黄昏时分,一个下人正在罗生门下等待雨停。宽阔的门下,除了这个男人以外谁也没有。只有在那几根各处剥落着朱红色油漆的大圆柱上,停着一只蟋蟀。既然罗生门位于朱雀大路上,除了这个男人之外,原本似乎还应有两三个戴着市女笠或揉乌帽子、在此躲雨的人。然而,除了这个男人以外,谁也没有。
开头一段:原书文字按扫描件转录(旧字体保留、略去注音),与逐句校订的简体中文译文对照。
经格译实际管道处理;展示前逐段人工校对并修订译文,所示为优化后的节选。 · 原文:羅生門,芥川龍之介,1917(作者芥川龍之介 1927 年去世,距今已超过 70 年;按日本著作权法,1967 年底以前去世的作者保护期为死后 50 年,本书保护期已于 1977 年底届满。国立国会图书馆数字馆藏将该条目标为 PDM(公有领域标记)并在互联网公开(DOI 10.11501/1088339)。)
常见问题
竖排会被读成乱序吗?
不会。识别阶段就按竖排的阅读顺序处理,見開き与多栏页面的顺序也会自动纠正。
译文还是竖排吗?
不是,统一转成横排输出。横排更适合在屏幕上阅读,也便于后续编辑。
怎么计费?
竖排原件通常是扫描件,走 AI 重排的识别路径:高精度 8 积分一页、标准 4 积分一页,每个文件最低 10 积分。
只要原文不要译文可以吗?
可以,用文档提取,4 积分一页,只提取不翻译。
旧字形和异体字能识别吗?
多数能识别,但可能被归一成现代字形。涉及考据时请以原件为准。
中文古籍也支持吗?
支持。竖排中文与竖排日文走同一条识别路线,阅读顺序同样会纠正。
相关内容
English · Français · Deutsch · Русский · 日本語 · 한국어 · العربية · 繁體中文
Geyi is a proprietary AI document platform owned and operated by Nayuta Technology and Culture Company Limited.